
NLTK Tokenize: Tokenizator riječi i rečenica s primjerom
 Uredništvo
⚡ Pametni sažetak
NLTK Tokenize dijeli veliki tekst na manje jedinice zvane tokeni, što je temeljni korak u obradi prirodnog jezika. Alat pruža word_tokenize za razdvajanje rečenica na riječi i sent_tokenize za dijeljenje teksta na pojedinačne rečenice.
Što je tokenizacija?
Tokenization je proces kojim se velika količina teksta dijeli na manje dijelove koji se nazivaju tokeni. Ovi su tokeni vrlo korisni za pronalaženje obrazaca i smatraju se osnovnim korakom za stvaranje korijena i lematizaciju. Tokenizacija također pomaže u zamjeni osjetljivih podatkovnih elemenata s neosjetljivim podatkovnim elementima.
Obrada prirodnog jezika koristi se za izradu aplikacija kao što su klasifikacija teksta, inteligentni chatbot, sentimentalna analiza, prijevod jezika, itd. Postaje ključno razumjeti obrazac u tekstu kako bi se postigla gore navedena svrha.
Za sada se ne brinite oko korijena i lematizacije, već ih tretirajte kao korake za čišćenje tekstualnih podataka pomoću NLP-a (Procesiranje prirodnog jezika). Kasnije ćemo u udžbeniku raspravljati o podrijetlu i lematizaciji. Zadaci kao što su Klasifikacija teksta ili filtriranje spama koristi NLP zajedno s bibliotekama dubokog učenja kao što su Keras i Tenzor protok.
Alati za prirodni jezik imaju vrlo važan modul NLTK tokenizirati rečenica koje se dalje sastoje od podmodula
- riječ tokenizirati
- rečenica tokenizirati
Tokenizacija riječi
Koristimo metodu word_tokenize() rastaviti rečenicu na riječi. Izlaz tokenizacije riječi može se pretvoriti u Data Frame za bolje razumijevanje teksta u aplikacijama strojnog učenja. Također se može dati kao ulaz za daljnje korake čišćenja teksta kao što je uklanjanje interpunkcijskih znakova, numeričkih znakova ili korijena. Modeli strojnog učenja trebaju numeričke podatke da bi bili obučeni i dali predviđanje. Tokenizacija riječi postaje ključni dio konverzije teksta (stringa) u numeričke podatke. Molimo pročitajte o Bag of Words ili CountVectorizer. Pogledajte donji primjer riječi tokenize NLTK kako biste bolje razumjeli teoriju.
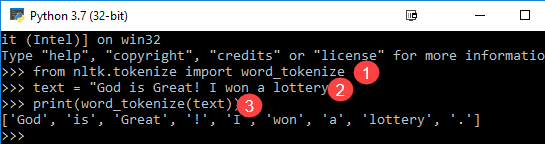
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
Code Objašnjenje
- word_tokenize modul je uvezen iz NLTK biblioteke.
- Varijabla "text" inicijalizirana je s dvije rečenice.
- Tekstualna varijabla prosljeđuje se u word_tokenize modul i ispisuje rezultat. Ovaj modul razdvaja svaku riječ interpunkcijskim znakovima koje možete vidjeti u izlazu.
Tokenizacija rečenica
Podmodul dostupan za gore navedeno je sent_tokenize. Očito pitanje u vašem umu bilo bi zašto je potrebna tokenizacija rečenice kada imamo mogućnost tokenizacije riječi. Zamislite da trebate izbrojati prosječne riječi po rečenici, kako ćete izračunati? Za izvršenje takvog zadatka potreban vam je NLTK tokenizator rečenica kao i NLTK tokenizator riječi za izračunavanje omjera. Takav izlaz služi kao važna značajka za strojnu obuku jer bi odgovor bio numerički.
Provjerite donji primjer NLTK tokenizatora da biste saznali kako se tokenizacija rečenice razlikuje od tokenizacije riječi.
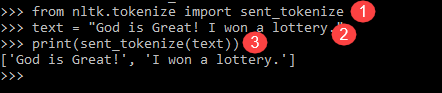
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Imamo 12 riječi i dvije rečenice za isti unos.
Objašnjenje programa
- U liniji kao u prethodnom programu, uvezen je modul sent_tokenize.
- Uzeli smo istu rečenicu. Daljnji tokenizator rečenica u NLTK modulu raščlanio je te rečenice i prikazao izlaz. Jasno je da ova funkcija razbija svaku rečenicu.
Tokenizator riječi iznad Python primjeri su dobra postava za razumijevanje mehanike tokenizacije riječi i rečenice.
