
Kako zamijeniti nedostajuće vrijednosti (NA) u R: na.omit & na.rm
 Evelyn Clarke
⚡ Pametni sažetak
Zamjena nedostajućih vrijednosti u R-u obuhvaća otkrivanje NA vrijednosti, uklanjanje nepotpunih redaka pomoću na.omit() i njihovo imputiranje sa srednjom vrijednošću ili medijanom pomoću mutate(). Ovaj vodič koristi skup podataka Titanic, gdje i age i fare nose nedostajuća opažanja.
Što su nedostajuće vrijednosti u R-u?
Nedostajuće vrijednosti pojavljuju se kada opažanje nema zabilježenu vrijednost u stupcu ili kada se nenumeričko rezervirano mjesto nalazi tamo gdje bi trebao biti broj. Moraju se ukloniti ili zamijeniti prije bilo kakvog izračuna jer većina R funkcija vraća NA u trenutku kada je jedan prisutan.
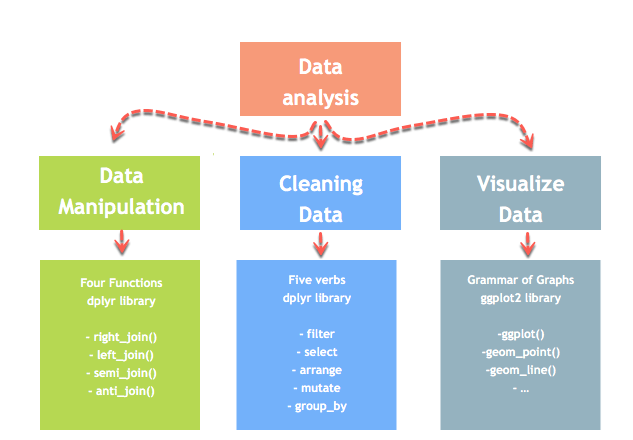
Ovaj tutorial pokazuje kako se nositi s nedostajućim vrijednostima pomoću biblioteke dplyr, dijela ekosustava tidyverse za analizu podataka.
Prvi korak je uvijek saznati koliko vrijednosti nedostaje i gdje.
Kako otkriti i prebrojati nedostajuće vrijednosti u R-u
Prije nego što odlučite što učiniti s nedostajućim vrijednostima, morate znati koliko ih ima i gdje se nalaze. R nudi četiri provjere, od jednog odgovora da ili ne do potpunog zbrajanja po stupcu.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
U praksi se preporučuje colSums(). Vraća imenovani vektor s jednim brojem po stupcu, što odmah pokazuje nedostaje li varijabli nekoliko vrijednosti ili je uglavnom prazna.
Brojanje punih redaka. complete.cases() vraća TRUE za retke bez nedostajućih vrijednosti nigdje, što vam unaprijed govori koliko podataka bi na.omit() odbacio:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Upozorenje o rezerviranim mjestima. R prepoznaje samo NA. Skupovi podataka često kodiraju nedostajuće vrijednosti kao prazan niz, razmak, "N/A", "-" ili kontrolni broj kao što je -99 ili 999. Oni prolaze svaku gornju provjeru nezapaženo. Pretvorite ih pri uvozu kako bi se ostatak tijeka rada ponašao ispravno:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Uvijek skenirajte raspon svakog numeričkog stupca nakon uvoza. Starost od -99 ili cijena od 9999 daleko su opasniji od poštenog NA, jer vas nijedna funkcija neće upozoriti na to.
Vrste nedostajućih podataka: MCAR, MAR i MNAR
Zašto vrijednost nedostaje određuje je li njezino unošenje sigurno. Statističari prepoznaju tri mehanizma.
- MCAR, potpuno nasumično nedostaje. Vjerojatnost da nedostaje nije povezana ni s čim, promatranim ili ne, na primjer sa senzorom koji zakaže u nasumičnim trenucima.ping ili imputiranje ovih redaka ne uvodi pristranost, već samo gubitak preciznosti.
- MAR, nasumično nedostaje. Vjerojatnost ovisi o drugim promatranim varijablama, ali ne o samoj nedostajućoj vrijednosti. Ako je manja vjerojatnost da će stariji putnici imati zabilježenu dob, dob je MAR s obzirom na ostale stupce. Imputacija koja koristi te stupce dobro se nosi s tim.
- MNAR, ne nedostaje slučajno. Vjerojatnost ovisi o samoj nepromatranoj vrijednosti, na primjer, osobe s visokim primanjima odbijaju navesti svoj prihod. Nijedna metoda imputacije ne može to popraviti samo iz podataka, a sam nedostatak sadrži informacije vrijedne bilježenja u stupcu s oznakama.
Imputacija srednje vrijednosti, kako se koristi u ovom vodiču, obranjiva je samo pod MCAR-om i jednostavnim MAR-om. Čak i tada ima poznatu cijenu: popunjavanje svake praznine istim brojem smanjuje varijancu stupca i slabi njegovu korelaciju sa svime ostalim. Za ozbiljan rad koristite metodu temeljenu na modelu kao što je paket mices i uvijek zadržite stupac s oznakom koji označava koje su vrijednosti imputirane.
mutirati()
mutate() je dplyr glagol koji stvara novu varijablu ili prepisuje postojeću, što ga čini prirodnim alatom za izgradnju očišćene kopije stupca.
Nastavit ćemo u dva dijela. Naučit ćemo kako:
- isključi nedostajuće vrijednosti iz podatkovnog okvira
- imputirati nedostajuće vrijednosti sa srednjom i medijanom
Glagol mutate() vrlo je jednostavan za korištenje. Možemo stvoriti novu varijablu slijedeći ovu sintaksu:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Isključi nedostajuće vrijednosti (NA)
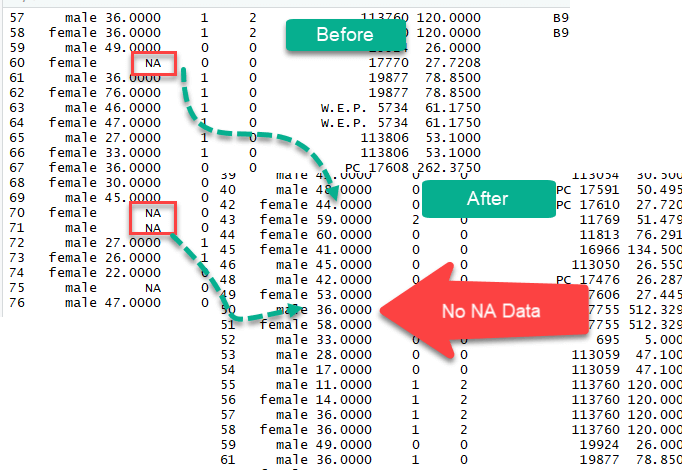
na.omit() je osnovna R funkcija, a ne dplyr glagol, ali svejedno čisto prosljeđuje. Izbacuje svaki redak koji sadrži barem jednu NA. To je najbrža opcija i rijetko najbolja, jer jedna nedostajuća vrijednost odbacuje cijelo opažanje.
Kako bismo riješili problem nedostajućih opažanja, koristit ćemo titanski skup podataka. U ovom skupu podataka imamo pristup informacijama o putnicima u zrakoplovu tijekom tragedije. Ovaj skup podataka ima mnogo NA o kojima treba voditi računa.
Učitajte CSV datoteku s interneta, a zatim navedite stupce koji sadrže NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Izlaz:
## [1] "age" "fare"
Ovdje,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
vraća nazive stupaca koji sadrže barem jednu nedostajuću vrijednost.
U stupcima starost i cijena karte nedostaju vrijednosti.
Možemo ih ispustiti pomoću na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Izlaz:
## [1] 1045 13
Novi skup podataka sadrži 1045 redaka u usporedbi s 1309 s izvornim skupom podataka.
Imputirajte nedostajuće podatke sa srednjom vrijednosti i medijanom
Također možete imputirati, odnosno popuniti nedostajuće vrijednosti srednjom vrijednošću ili medijanom. Dobra je praksa stvoriti dvije odvojene varijable za srednju vrijednost i medijan. Nakon što ih stvorimo, možemo zamijeniti nedostajuće vrijednosti novostvorenim varijablama.
Koristit ćemo metodu primjene za izračunavanje srednje vrijednosti stupca s NA. Pogledajmo primjer
Korak 1) Ranije u vodiču, pohranili smo naziv stupca s nedostajućim vrijednostima na popis pod nazivom list_na. Koristit ćemo se ovim popisom
Korak 2) Izračunajte srednju vrijednost s argumentom na.rm = TRUE. Ovaj argument je obavezan jer stupci imaju nedostajuće podatke, a to govori R-u da ih ignorira.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Objašnjenje:
Prosljeđujemo 4 argumenta u metodi primjene.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Ovaj kod će vratiti naziv stupca iz objekta list_na (tj. “age” i “fare”)
- 2: Izračunajte funkciju na stupcima
- srednja vrijednost: Izračunajte srednju vrijednost
- na.rm = TRUE: Zanemarite vrijednosti koje nedostaju
Izlaz:
##      age     fare
## 29.88113 33.29548
Uspješno smo stvorili srednju vrijednost stupaca koji sadrže opažanja koja nedostaju. Ove dvije vrijednosti će se koristiti za zamjenu opažanja koja nedostaju.
Korak 3) Zamijenite NA vrijednosti
Glagol mutate iz biblioteke dplyr koristan je u stvaranju nove varijable. Ne želimo nužno mijenjati izvorni stupac kako bismo mogli stvoriti novu varijablu bez NA. mutate je jednostavan za korištenje, samo odabiremo ime varijable i definiramo kako stvoriti tu varijablu. Ovdje je kompletan kod
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Objašnjenje:
Stvaramo dvije varijable, replace_mean_age i replace_mean_fare na sljedeći način:
- zamijeni srednju_dob = ifelse(is.na(dob), prosjek_nedostaje[1], dob)
- zamjena_srednje_karte = ifelse(je.na(karta), prosjek_nedostaje[2],karta)
Ako stupac age ima nedostajuće vrijednosti, zamijenite ga prvim elementom prosječne_nedostajuće (srednja vrijednost starosti), inače zadržite izvorne vrijednosti. Ista logika za cijenu
sum(is.na(df_titanic_replace$age))
Izlaz:
## [1] 263
Nakon zamjene, novi stupac uopće ne sadrži nedostajuće vrijednosti:
sum(is.na(df_titanic_replace$replace_mean_age))
Izlaz:
## [1] 0
Izvorni stupac s dobi sadrži 263 nedostajuće vrijednosti, dok je novi stupac replace_mean_age svaku od njih popunio prosječnom dobi.
Korak 4) Opažanja koja nedostaju također možemo zamijeniti medijanom.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Izlaz:

Korak 5) Na širokom skupu podataka, metoda korak po korak postaje zamorna. sapply() sažima cijeli postupak u jednu naredbu, po cijenu da se imputirane vrijednosti nikada ne vide.
sapply ne stvara a podatkovni okvir, tako da možemo omotati funkciju sapply() unutar data.frame() da bismo stvorili objekt okvira podataka.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Moderna imputacija s replace_na() i across()
Gore navedeni pristupi apply() i sapply() i dalje rade, ali tidyr i dplyr sada izražavaju iste operacije sigurnije i čitljivije.
replace_na() za fiksne vrijednosti. tidyr::replace_na() uzima imenovani popis stupaca i njihovih zamjena:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() za svaki numerički stupac. Ovo je izravna, tipski sigurna zamjena za sapply() jednolinijski izraz i za razliku od sapply() nikada ne dira znakovne ili faktorske stupce:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Zašto je prečac sapply() rizičan: Primjer sapply() s jednom linijom izvršava se preko svaki stupac, uključujući znakovne i faktorske. Pozivanje mean() na te vraća NA s upozorenjem, a sapply() zatim prisiljava cijeli rezultat na znakovni. Gornja verzija across(where(is.numeric), ...) to u potpunosti izbjegava.
coalesce() za rezervne stupce. Kada drugi stupac može dati nedostajuću vrijednost, coalesce() vraća prvi unos koji ne nedostaje među svojim argumentima:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Vodite evidenciju o tome što ste promijenili. Dodajte zastavicu prije imputiranja, tako da bilo koji kasniji model može učiti iz činjenice da je vrijednost nedostajala:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Obrada nedostajućih vrijednosti u R-u: Referenca metode
U ovom tutorijalu su obrađena tri pristupa:
- Isključite sva zapažanja koja nedostaju
- Pripisati srednjoj vrijednosti
- Pripisati medijanu
Donja tablica sažima otkrivanje i uklanjanje:
| Knjižnica | Cilj | Code |
|---|---|---|
| baza | Navedite zapažanja koja nedostaju |
colnames(df)[apply(df, 2, anyNA)] |
| baza | Ukloni svaki redak koji sadrži NA |
na.omit(df) |
Imputiranje sa srednjom ili medijanom može se izvršiti na dva načina
- Korištenje primijeniti
- Korištenje sapply
| način | Detaljnije | Prednosti | Nedostaci |
|---|---|---|---|
| Korak po korak uz prijavu | Provjerite stupce u kojima nedostaju, izračunajte srednju vrijednost/medijan, pohranite vrijednost, zamijenite s mutate() | Možete vidjeti imputiranu srednju vrijednost ili medijan | Više vremena izvršenja. Može biti spor s velikim skupom podataka |
| Brzi način s dodatkom | Upotrijebite sapply() i data.frame() za automatsko pretraživanje i zamjenu vrijednosti koje nedostaju srednjom/medijanom | Kratak kod i brzo | Imputirane vrijednosti se nikada ne prikazuju |
