
Što je Hadoop? Architekstura, ekosustav i komponente
 Prafulla Ranadive
⚡ Pametni sažetak
Apache Hadoop je okvir otvorenog koda koji pohranjuje ogromne skupove podataka na klastere standardnih računala i premješta logiku obrade na podatke, tako da se analiza skalira dodavanjem jeftinih čvorova umjesto većih poslužitelja.
Što je Hadoop?
Apache Hadoop je softverski okvir otvorenog koda koji se koristi za razvoj aplikacija za obradu podataka koje se izvode u distribuiranom računalnom okruženju.
Aplikacije izgrađene pomoću Hadoop-a izvode se na velikim skupovima podataka raspoređenim po klasterima standardnih računala. Standardna računala su jeftina i široko dostupna. Uglavnom su korisna za postizanje veće računalne snage uz nisku cijenu.
Slično podacima koji se nalaze u lokalnom datotečnom sustavu osobnog računala, u Hadoopu se podaci nalaze u distribuiranom datotečnom sustavu koji se naziva Hadoop distribuirani datotečni sustavModel obrade temelji se na 'Lokalitet podataka' koncept, u kojem se računalna logika šalje čvorovima klastera (poslužiteljima) koji sadrže podatke. Ova računalna logika je jednostavno kompilirana verzija programa napisanog u programskom jeziku visoke razine kao što je JavaTakav program obrađuje podatke pohranjene u Hadoop HDFS.
Znate li? Računalni klaster sastoji se od skupa više procesorskih jedinica (disk za pohranu + procesor) koje su međusobno povezane i djeluju kao jedinstveni sustav.
Verzija 3.5.0, objavljena 2. travnja 2026., trenutno je stabilno izdanje; linija 3.4 još uvijek prima ažuriranja za održavanje.
Hadoop ekosustav i komponente
Donji dijagram prikazuje različite komponente u Hadoop ekosustavu, grupirane prema poslu koji svaka od njih obavlja - pohrana, obrada te alati za upite, unos i koordinaciju oko njih.

Apache Hadoop sastoji se od dva potprojekta –
- Hadoop MapReduce: MapReduce je računalni model i softverski okvir za pisanje aplikacija koje se pokreću na Hadoopu. Ovi MapReduce programi sposobni su za paralelnu obradu ogromnih podataka na velikim klasterima računalnih čvorova.
- HDFS (Hadoop distribuirani datotečni sustav): HDFS brine o dijelu za pohranu Hadoop aplikacija. MapReduce aplikacije troše podatke iz HDFS-a. HDFS stvara višestruke replike podatkovnih blokova i distribuira ih na računalne čvorove u klasteru. Ova distribucija omogućuje pouzdana i iznimno brza izračunavanja.
Trenutna izdanja isporučuju dva dodatna osnovna modula. Hadoop PREĐA, dodan u Hadoop 2.x, zakazuje rad na klasteru i Hadoop Common drži dijeljeno Java biblioteke o kojima ovisi svaki modul. YARN je ono što omogućuje engine-ima kao što su Spark, Tez i Flink rade uz MapReduce.
Iako je Hadoop najpoznatiji po MapReduceu i njegovom distribuiranom datotečnom sustavu HDFS, taj se izraz koristi i za obitelj srodnih projekata koji spadaju pod okrilje distribuiranog računarstva i obrade podataka velikih razmjera. Ostali projekti povezani s Hadoopom na Apacheu uključuju Košnica, HBase, Mahout, Sqoop, Flumei ZooKeeper.
Hadoop Architektura
Hadoop ima master-slave arhitekturu za pohranu podataka i distribuiranu obradu podataka koristeći MapReduce i HDFS metode. Dijagram u nastavku postavlja te uloge jednu pored druge, sa slojem za pohranu na jednoj strani i slojem za obradu na drugoj.
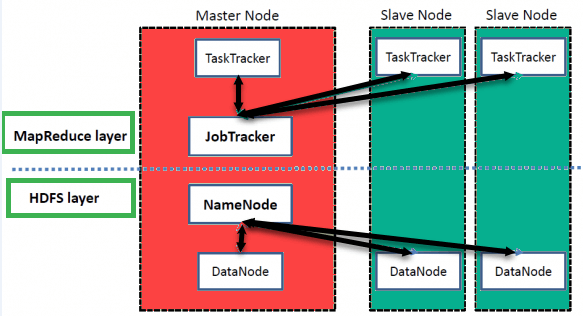
Hadoop visoke razine Architektura
NameNode
NameNode pohranjuje metapodatke za svaku datoteku i direktorij korišten u imenskom prostoru, uključujući koji blokovi čine svaku datoteku i gdje se ti blokovi nalaze.
Čvor podataka
DataNode upravlja stanjem HDFS čvora i omogućuje vam interakciju s blokovima koje pohranjuje, izvještavajući NameNode s periodičnim izvješćima o blokovima i otkucajima srca.
Glavni čvor
Glavni čvor vam omogućuje provođenje paralelne obrade podataka pomoću Hadoop MapReduce.
Podređeni čvor
Podređeni čvorovi su dodatni strojevi u Hadoop klasteru koji vam omogućuju pohranu podataka i izvođenje složenih izračuna. Štoviše, svaki podređeni čvor izvršava zadatak.Tracker i DataNode. To vam omogućuje sinkronizaciju procesa s NameNodeom i JobomTracker respektivno.
U Hadoopu, glavni ili podređeni sustavi mogu se postaviti u oblaku ili lokalno.
Jedna napomena o imenovanju: PosaoTracker i ZadatakTracker pripadaju prvoj generaciji MapReduce runtimea (MRv1). Od Hadoop 2.x nadalje, YARN dijeli svoje dužnosti između klastera na razini cijelog klastera Upravitelj resursaA Upravitelj čvorova po radniku i jedan Glavni programer aplikacija po poslu. NameNode i DataNode ostaju nepromijenjeni.
Značajke Hadoop-a
Pogodno za analizu velikih podataka
As Big Podaci Budući da su po prirodi distribuirani i nestrukturirani, Hadoop klasteri su najprikladniji za analizu velikih podataka. Budući da je logika obrade (ne stvarni podaci) ta koja teče do računalnih čvorova, troši se manje mrežne propusnosti. To se naziva koncept lokaliteta podataka, i pomaže povećati učinkovitost aplikacija temeljenih na Hadoopu.
skalabilnost
Hadoop klasteri se mogu lako skalirati do bilo koje mjere dodavanjem dodatnih čvorova klastera, te tako omogućiti rast velikih podataka (Big Data). Također, skaliranje ne zahtijeva modifikacije logike aplikacije.
Tolerancija kvarova
Hadoop ekosustav ima mogućnost repliciranja ulaznih podataka na druge čvorove klastera. Na taj način, u slučaju kvara čvora klastera, obrada podataka i dalje se može nastaviti korištenjem podataka pohranjenih na drugom čvoru klastera. HDFS prema zadanim postavkama čuva tri kopije svakog bloka, vrijednost koju postavlja dfs.replikacija svojstvo, a NameNode ponovno replicira svaki blok koji padne ispod tog broja.
Topologija mreže u Hadoopu
Topologija (raspored) mreže utječe na performanse Hadoop klastera kako veličina klastera raste. Osim performansi, potrebno je voditi računa i o visokoj dostupnosti i rukovanju kvarovima. Da bi se to postiglo, formiranje Hadoop klastera koristi topologiju mreže.
Donje stablo prikazuje kako je taj raspored modeliran, od podatkovnog centra do čvorova unutar svakog stalka.

Obično je propusnost mreže važan faktor koji treba uzeti u obzir pri formiranju bilo koje mreže. Međutim, budući da mjerenje propusnosti može biti teško, u Hadoopu se mreža predstavlja kao stablo, a udaljenost između čvorova tog stabla (broj skokova) smatra se važnim faktorom u formiranju Hadoop klastera. Ovdje je udaljenost između dva čvora jednaka zbroju njihovih udaljenosti do njihovog najbližeg zajedničkog pretka.
Hadoop klaster sastoji se od podatkovnog centra, racka i čvora koji zapravo izvršava zadatke. Ovdje se podatkovni centar sastoji od rackova, a rack se sastoji od čvorova. Propusnost mreže dostupna procesima varira ovisno o lokaciji procesa. To jest, dostupna propusnost postaje manja kako se udaljavamo od-
- Procesi na istom čvoru
- Različiti čvorovi na istom nosaču
- Čvorovi na različitim policama istog podatkovnog centra
- Čvorovi u različitim podatkovnim centrima
Svijest o stalku koristi isto stablo: HDFS smješta replike na više od jednog stalka, tako da gubitak prekidača za stalak ne odnosi svaku kopiju podataka sa sobom.
