
Gaussova jezgra u strojnom učenju: Python Kernel metode
 Evelyn Clarke
⚡ Pametni sažetak
Gaussove metode jezgre čine neodvojive podatke linearno odvojivim bez ikakve izgradnje visokodimenzionalne mape značajki. Ovaj vodič prikazuje polinomsku mapuping ručno, a zatim trenira slučajni Fourierov klasifikator s jezgrom u TensorFlowu.
Svrha ovog vodiča je napraviti skup podataka linearno odvojivim. Vodič je podijeljen u dva dijela:
- Transformacija značajki
- Treniranje klasifikatora jezgre pomoću TensorFlowa
U prvom dijelu shvatit ćete ideju iza Kernel metode u strojnom učenju, dok ćete u drugom dijelu vidjeti kako trenirati kernel klasifikator pomoću TensorFlowKoristit ćete skup podataka za odrasle. Cilj ovog skupa podataka je klasificirati prihode ispod i iznad 50 tisuća, poznajući ponašanje svakog kućanstva.
Zašto su vam potrebne kernel metode?
Cilj svakog klasifikatora je ispravno predvidjeti klase. Za to, skup podataka mora biti odvojiv. Pogledajte donji grafikon; prilično je jednostavno vidjeti da sve točke iznad crne linije pripadaju prvoj klasi, a ostale točke drugoj klasi. Međutim, izuzetno je rijetko imati tako jednostavan skup podataka. U većini slučajeva, podaci nisu odvojivi, a podaci koji nisu odvojivi otežavaju naivnim klasifikatorima poput logističke regresije.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Na donjoj slici prikazujemo skup podataka koji nije linearno odvojiv. Ako nacrtamo ravnu liniju, većina točaka neće biti klasificirana u ispravnu klasu.
Jedan od načina za rješavanje ovog problema je uzeti skup podataka i transformirati podatke u drugu mapu značajki. To znači da ćete koristiti funkciju za premještanje podataka u drugu ravninu, onu koja bi trebala biti linearno odvojiva.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
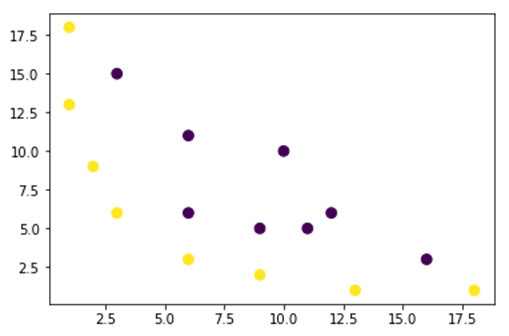
Podaci s gornje slike nalaze se u 2D ravnini i nisu odvojivi. Možete pokušati transformirati ove podatke u tri dimenzije, što znači da stvarate lik s 3 osi.
U našem primjeru Gaussove jezgre, primijenit ćemo polinomsko preslikavanjeping kako bismo naše podatke doveli u treću dimenziju. Formula za transformaciju podataka je sljedeća.

Vi definirate funkciju u Gaussovoj jezgri Python za izradu novih mapa značajki.
Možete koristiti numpy za kodiranje gornje formule. Svaki redak ispod uparuje jedan član mapeping s izrazom polja koji ga proizvodi, a mala slika označava kvadratni korijen faktora dva.
| Formula | Ekvivalentni NumPy kod |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Nova kartaping ima 3 dimenzije i 16 točaka.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Sada napravite novi graf s 3 osi, x, y i z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Vidimo poboljšanje, ali ako promijenimo orijentaciju grafikona, postaje jasno da je skup podataka sada odvojiv.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Ako morate manipulirati velikim skupom podataka i stvoriti više od dvije dimenzije, suočit ćete se s velikim problemom s gornjom metodom. Zapravo, morate transformirati sve podatkovne točke, što očito nije održivo. Trebat će vam puno vremena, a vašem računalu može ponestati memorije.
Najčešći način za rješavanje ovog problema je korištenje kernela.
Što je kernel u strojnom učenju?
Ideja je koristiti prostor značajki više dimenzije kako bi se podaci učinili gotovo linearno odvojivima, kao što je prikazano na gornjoj slici.
Postoji mnogo višedimenzionalnih prostora koji omogućuju odvajanje podatkovnih točaka. Na primjer, pokazali smo da polinomno preslikavanjeping je odličan početak.
Također smo pokazali da s puno podataka ove transformacije nisu učinkovite. Umjesto toga, možete koristiti Kernel funkciju u Strojnom učenju za izmjenu podataka bez prelaska na novu ravninu značajki.
Magija kernela je pronaći funkciju koja izbjegava sve probleme koje podrazumijeva visokodimenzionalno računanje. Rezultat kernela je skalar, ili drugim riječima, vraćamo se u jednodimenzionalni prostor.
Nakon što ste pronašli ovu funkciju, možete je uključiti u standardni linearni klasifikator.
Evo primjera koji konkretizira koncept strojnog učenja jezgre. Imate dva vektora, x1 i x2. Cilj je stvoriti višu dimenziju korištenjem polinomskog mapiranja.pingIzlaz je jednak skalarnom umnošku nove mape značajki. Iz gornje metode potrebno je:
- Transformirajte x1 i x2 u novu dimenziju
- Izračunajte točkasti umnožak: zajednički za sve jezgre
Transformirajte x1 i x2 u novu dimenziju
Možete koristiti gore stvorenu funkciju za izračunavanje više dimenzije.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Izlaz
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Izračunajte točkasti umnožak
Možete koristiti točku objekta iz numpy izračunati skalarni produkt između prvog i drugog vektora pohranjenog u x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Izlaz je 8100. Vidite problem: trebate pohraniti novu mapu značajki u memoriju kako biste izračunali skalarni produkt. Ako imate skup podataka s milijunima zapisa, to je računalno neučinkovito.
Umjesto toga, možete koristiti polinomsku jezgru za izračunavanje skalarnog produkta bez transformacije vektora. Ova funkcija izračunava skalarni produkt x1 i x2 kao da su ta dva vektora transformirana u višu dimenziju. Drugim riječima, jezgra funkcije izračunava rezultat skalarnog produkta iz drugog prostora značajki.
Možete napisati polinomnu kernel funkciju Python kako slijedi.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
To je snaga točkastog produkta dva vektora. U nastavku vraćate drugi stupanj jezgre polinoma. Izlaz je jednak drugoj metodi. Ovo je magija kernela.
polynomial_kernel(x1, x2, p=2)
8100
Vrste kernel metoda
Dostupne su mnoge različite tehnike kernela. Najjednostavnija je linearna kernel. Ova funkcija prilično dobro funkcionira za klasifikaciju teksta. Ostale kernele su:
- Polinomska jezgra
- Gaussova jezgra
Donja tablica sažima što svaki od njih radi i kada ga praktičari koriste.
| Zrno | Što izračunava | Tipična upotreba |
|---|---|---|
| linearan | Jednostavan skalarni produkt u izvornom prostoru značajki | Već odvojivi podaci i visokodimenzionalne tekstualne značajke |
| Polinom | Skanski produkt podignut na stupanj p, koji obuhvaća interakcije značajki | Zakrivljene granice kada se zna da su interakcije važne |
| Gaussov (RBF) | Sličnost temeljena na udaljenosti koja pada prema nuli kako se točke udaljavaju | Uobičajeni prvi izbor kada je oblik granice nepoznat |
U primjeru s TensorFlowom, koristit ćemo nasumična Fourierova obilježja. TensorFlow ima ugrađeni estimator za izračunavanje novog prostora obilježja. Maper nasumičnih Fourierovih obilježja je aproksimacija Gaussove kernel funkcije prikazane u nastavku.

Funkcija Gaussovog filtriranja izračunava sličnost između podatkovnih točaka u mnogo većem dimenzionalnom prostoru.
Nakon što je teorija riješena, ostatak ovog vodiča koristi Gaussovu jezgru za rad na stvarnom skupu podataka.
Uvježbajte Gaussov kernel klasifikator s TensorFlowom
Cilj algoritma je klasificirati kućanstvo koje zarađuje više ili manje od 50k.
Prvo ćete procijeniti logističku regresiju kako biste dobili referentni model. Nakon toga ćete trenirati Kernel klasifikator kako biste vidjeli možete li dobiti bolje rezultate.
Koristite sljedeće varijable iz skupa podataka za odrasle:
- starost
- radna klasa
- fnlwgt
- obrazovanje
- obrazovanje_br
- bračni
- okupacija
- odnos
- utrka
- seks
- kapitalni dobitak
- gubitak_kapitala
- sati_tjedan
- rodna_zemlja
- oznaka
Prije treniranja i evaluacije modela postupit ćete na sljedeći način:
- Uvezite biblioteke
- Uvezite podatke
- Pripremite podatke
- Konstruirajte logistički model: osnovni model
- Ocijenite model
- Konstruirajte i evaluirajte klasifikator jezgre
Napomena o verziji: Svaki isječak u nastavku cilja TensorFlow 1.x. Imenski prostor tf.contrib, koji pruža real_valued_column, RandomFourierFeatureMapper i KernelLinearClassifier, uklonjen je u TensorFlowu 2.0, a sam tf.estimator uklonjen je u TensorFlowu 2.16. U trenutnom izdanju, izgradite isti cjevovod sa slojem tf.keras.layers.experimental.RandomFourierFeatures nakon čega slijedi izlazni sloj Dense ili s parom RBFSampler i SGDClassifier iz scikit-learn.
Korak 1) Uvezite biblioteke
Za uvoz i obuku kernel modela Umjetna inteligencija, morate uvesti TensorFlow, pande i NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Korak 2) Uvezite podatke
Preuzimate podatke iz Stranica s podacima o skupu podataka za odrasle UCI i uvezite ga kao pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Sada kada su vlak i testni skup definirani, možete promijeniti oznaku stupca iz niza znakova u cijeli broj. TensorFlow ne prihvaća nizove znakova za oznaku.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Korak 3) Pripremite podatke
Skup podataka sadrži i kontinuirane i kategoričke značajke. Dobra praksa je standardizirati vrijednosti kontinuiranih varijabli. Možete koristiti funkciju StandardScaler iz scikit učitiTakođer stvarate korisnički definiranu funkciju kako biste olakšali pretvaranje skupa za učenje i testiranje. Imajte na umu da spajate kontinuirane i kategoričke varijable u zajednički skup podataka, a niz bi trebao biti tipa float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Funkcija transformatora je spremna, tako da možete pretvoriti skup podataka i stvoriti funkciju input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
U sljedećem koraku trenirat ćete logističku regresiju. To će vam dati osnovnu točnost. Cilj je nadmašiti osnovnu liniju drugačijim algoritmom, naime klasifikatorom kernela.
Korak 4) Konstruirajte logistički model: osnovni model
Stupac značajki konstruirate s objektom real_valued_column. Pobrinut će se da sve varijable budu gusti numerički podaci.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Estimator se definira pomoću TensorFlow Estimator API-ja; vi navodite stupce značajki i gdje spremiti graf.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Logističku regresiju trenirat ćete koristeći mini-serije veličine 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Model možete trenirati s 1,000 iteracija.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Korak 5) Procijenite model
Definirate ulaznu funkciju NumPy za procjenu modela. Za procjenu koristite cijeli skup testova.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Imate točnost od 82 posto. U sljedećem odjeljku pokušat ćete pobijediti logistički klasifikator pomoću Kernel klasifikatora.
Korak 6) Konstruirajte kernel klasifikator
Kernel estimator se ne razlikuje toliko od tradicionalnog linearnog klasifikatora, barem što se tiče konstrukcije. Ideja iza njega je kombinirati snagu eksplicitnog kernel mapiranjaping s linearnim klasifikatorom.
Potrebna su vam dva unaprijed definirana procjenitelja dostupna u TensorFlowu za obuku Kernel Classifier-a:
- RandomFourierFeatureMapper
- KernelLinearClassifier
U prvom dijelu ste naučili da trebate transformirati nisku dimenziju u višu dimenziju pomoću kernel funkcije. Preciznije, koristit ćete nasumične Fourierove značajke koje aproksimiraju Gaussovu funkciju. TensorFlow 1.x pruža to mapiranjeping kao RandomFourierFeatureMapper, a model se može trenirati pomoću estimatora KernelLinearClassifier.
Da biste izradili model, slijedite ove korake:
- Postavite kernel funkciju visoke dimenzije
- Postavite hiperparametar L2
- Izgradite model
- Uvježbajte model
- Ocijenite model
Korak A) Postavite visokodimenzionalnu kernel funkciju
Trenutni skup podataka sadrži 14 značajki koje ćete transformirati u novi 5,000-dimenzionalni vektor. Za postizanje transformacije koristite nasumične Fourierove značajke. Ako se prisjetite Gaussove formule jezgre, primijetit ćete da postoji parametar standardne devijacije koji treba definirati. Ovaj parametar kontrolira mjeru sličnosti koja se koristi tijekom klasifikacije: mala stddev čini da jezgra tretira samo vrlo bliske točke kao slične, dok velika zaglađuje granicu odluke.
Možete podesiti sve parametre u RandomFourierFeatureMapper pomoću:
- input_dim = 14
- output_dim = 5000
- stddev = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Morate konstruirati kernel mapper korištenjem stupaca značajki kreiranih prije: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Korak B) Postavite hiperparametar L2
Kako biste spriječili prekomjerno prilagođavanje, kažnjavate funkciju gubitka regularizatorom L2. Hiperparametar L2 postavljate na 0.1, a brzinu učenja na 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Korak C) Izrada modela
Sljedeći korak je sličan linearnoj klasifikaciji. Koristite ugrađeni estimator KernelLinearClassifier. Imajte na umu da dodajete mapper kernela koji je prethodno definiran i mijenjate direktorij modela.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Upozorenja o zastarivanju u nastavku očekivana su na TensorFlowu 1.x, jer je modul kernel_methods izgrađen na starijim estimatorima tf.contrib.learn.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Korak D) Treniranje modela
Sada kada je Kernel klasifikator izgrađen, spremni ste za njegovo treniranje. Odlučite iterirati model 2,000 puta.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Korak E) Procijenite model
Posljednje, ali ne manje važno, vi ocjenjujete izvedbu svog modela. Trebali biste moći pobijediti logističku regresiju.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Konačna točnost je 84%, što je oko 1.6 postotnih bodova iznad osnovne vrijednosti logističke regresije (0.83975184 u odnosu na 0.82353663). Postoji kompromis između poboljšanja točnosti i računalnih troškova. Morate razmisliti isplati li se to poboljšanje vremena koje troši teži klasifikator i ima li uvjerljiv utjecaj na vaše poslovanje.
