
Kako instalirati Hadoop na UbuntuKoraci za preuzimanje i postavljanje
 Prafulla Ranadive
⚡ Pametni sažetak
Instaliranje Apache Hadoop-a na Ubuntu potrebna su dva prolaza: raspakiranje izdanja pod namjenskim sistemskim računom s SSH-om bez lozinke, zatim uređivanje četiri XML datoteke prije formatiranja HDFS-a i pokretanja klastera s jednim čvorom.
U ovom vodiču, provest ćemo vas kroz korak-po-korak postupak instalacije Apache Hadoop-a na Linux računalo (Ubuntu). Ovo je dvodjelni postupak: prvo preuzmite i instalirajte izdanje, a zatim ga konfigurirajte.
Postoje dva preduvjeta:
- Morate imati Ubuntu instaliran i trčanje.
- Morate imati Java instaliran.
Napomene o verziji Hadoop 3.x za ovu postavku
Snimke zaslona u ovom vodiču snimljene su na Hadoopu 2.2.0. Slijed koraka nije se promijenio u trenutnim izdanjima, ali je nekoliko naziva i zadanih postavki premješteno. Provjerite tablicu u nastavku prije doslovnog kopiranja bilo koje naredbe.
| Postavka ili korak | U ovom tutorijalu (Hadoop 2.x) | Trenutni Hadoop 3.x |
|---|---|---|
| Arhiva izdanja | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz, prvo stabilno izdanje 3.5, objavljeno 2. travnja 2026. |
| Zadano svojstvo datotečnog sustava | fs.default.name u prozi, fs.defaultFS u XML-u |
fs.defaultFS samo; fs.default.name je zastario |
| Svojstvo MapReduce | mapreduce.jobtracker.address |
mapreduce.framework.name postavljen na yarnPosaoTracker više ne postoji nakon što YARN zakaže rad |
| mapred-site.xml | Kopirano iz mapred-site.xml.template |
Brodovi ulaze etc/hadoop već, tako da je korak kopiranja nepotreban |
| Port web korisničkog sučelja NameNode | 50070 | 9870 |
| Java | Java 6 ili Java 7 | Java 8 ili Java 11 |
Sve ostalo u ovom vodiču ponaša se na isti način na Hadoopu 3: namjenski račun, SSH ključ, četiri konfiguracijske datoteke te skripte za pokretanje i zaustavljanje.
Dio 1) Preuzmite i instalirajte Hadoop
Korak 1) Dodajte korisnika Hadoop sustava
Dodajte korisnika Hadoop sustava pomoću donje naredbe.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
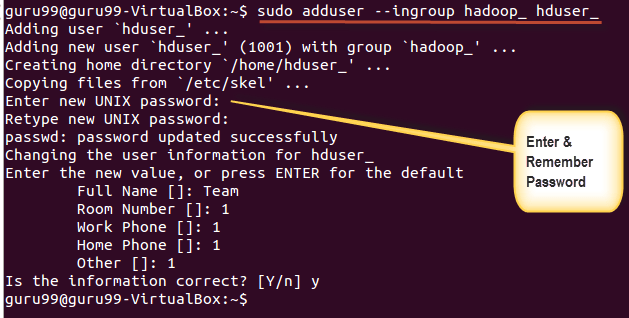
Unesite svoju lozinku, ime i ostale podatke.
NAPOMENA: Postoji mogućnost dolje navedene pogreške u ovom postupku postavljanja i instalacije.
“hduser nije u datoteci sudoers. Ovaj incident će biti prijavljen.”

Ovu grešku možete riješiti prijavom kao root korisnik.
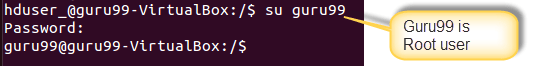
Izvršite naredbu
sudo adduser hduser_ sudo

Re-login as hduser_

Korak 2) Konfigurirajte SSH
Za upravljanje čvorovima u klasteru, Hadoopu je potreban SSH pristup.
Prvo promijenite korisnika, unesite sljedeću naredbu
su - hduser_

Ova naredba će stvoriti novi ključ.
ssh-keygen -t rsa -P ""

Omogućite SSH pristup lokalnom računalu pomoću ovog ključa.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

Sada testirajte SSH postavke povezivanjem na localhost kao korisnik 'hduser_'.
ssh localhost

Bilješka: Ako vidite grešku ispod kao odgovor na 'ssh localhost', tada postoji mogućnost da SSH nije dostupan na ovom sustavu.

Da biste to riješili –
Očisti SSH pomoću,
sudo apt-get purge openssh-server
Dobra je praksa pročistiti prije početka instalacije.

Instalirajte SSH pomoću naredbe-
sudo apt-get install openssh-server

Korak 3) Preuzmite Hadoop
Sljedeći korak je preuzimanje Hadoop-a s Stranica s izdanjima Apache Hadoop-a.

Odaberite Stabilno

Odaberite datoteku tar.gz (ne datoteku koja završava na src).

Nakon što je preuzimanje završeno, idite do direktorija koji sadrži tar datoteku.

Ulaz,
sudo tar xzf hadoop-2.2.0.tar.gz

Sada preimenujte hadoop-2.2.0 u hadoop.
sudo mv hadoop-2.2.0 hadoop

Na kraju, predajte mapu novom računu.
sudo chown -R hduser_:hadoop_ hadoop

Zamijenite verziju koju ste zapravo preuzeli hadoop-2.2.0 u tri gore navedene naredbe.
Dio 2) Konfigurirajte Hadoop
Korak 1) Izmijenite datoteku ~/.bashrc
Dodajte sljedeće retke na kraj datoteke ~/.bashrc.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
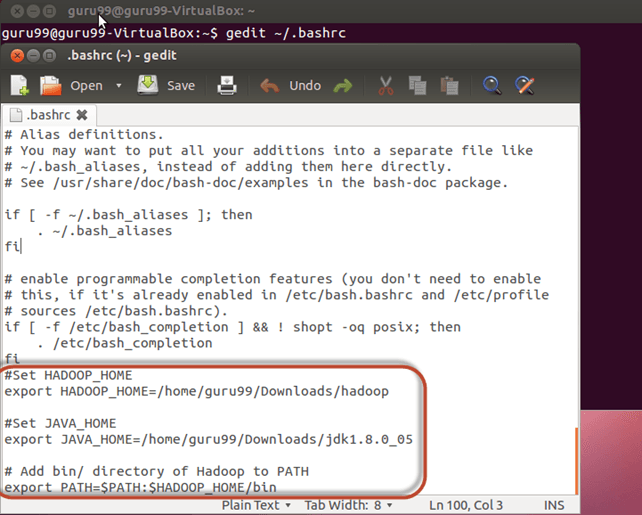
Sada, pronađite ovu konfiguraciju okruženja pomoću naredbe u nastavku.
. ~/.bashrc

Korak 2) Konfiguracije povezane s HDFS-om
Postavite JAVA_HOME unutar datoteke $HADOOP_HOME/etc/hadoop/hadoop-env.sh, prikazane dolje.


Kontakt

U $HADOOP_HOME/etc/hadoop/core-site.xml postoje dva parametra koja je potrebno postaviti -
1. 'hadoop.tmp.dir' – Koristi se za određivanje direktorija koji će Hadoop koristiti za pohranu svojih podatkovnih datoteka.
2. 'fs.defaultFS' – Ovo određuje zadani datotečni sustav. Stariji naziv za isto svojstvo, 'fs.default.name', je zastario.
Za postavljanje ovih parametara otvorite core-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

Kopirajte donje retke između oznake.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

Idite do direktorija $HADOOP_HOME/etc/hadoop.

Sada stvorite direktorij naveden u core-site.xml.
sudo mkdir -p <Path of Directory used in above setting>

Dodijelite dozvole direktoriju.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

Korak 3) Konfiguracija MapReducea
Prije nego što započnemo s ovim konfiguracijama, postavimo putanju HADOOP_HOME.
sudo gedit /etc/profile.d/hadoop.sh
I Enter
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

Zatim unesite
sudo chmod +x /etc/profile.d/hadoop.sh

Izađite iz Terminala i ponovno pokrenite.
Upišite echo $HADOOP_HOME za provjeru putanje.

Sada kopirajte datoteke
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

Otvorite datoteku mapred-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

Dodajte postavke u nastavku između i oznake.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

Otvorite $HADOOP_HOME/etc/hadoop/hdfs-site.xml kao što je prikazano u nastavku,
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

Dodajte postavke u nastavku između i oznake.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

Stvorite direktorij naveden u gornjoj postavci.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

Zatim dodijelite vlasništvo i dozvole za njega.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

Korak 4) Formatiranje HDFS-a
Prije nego što prvi put pokrenemo Hadoop, formatirajte HDFS pomoću naredbe u nastavku.
$HADOOP_HOME/bin/hdfs namenode -format

Korak 5) Pokretanje Hadoop klastera s jednim čvorom
Pokrenite Hadoop klaster s jednim čvorom pomoću donje naredbe.
$HADOOP_HOME/sbin/start-dfs.sh
Izlaz gornje naredbe prikazan je u nastavku.

Zatim pokrenite YARN daemone.
$HADOOP_HOME/sbin/start-yarn.sh

Pomoću alata 'jps' provjerite jesu li pokrenuti svi procesi povezani s Hadoopom.
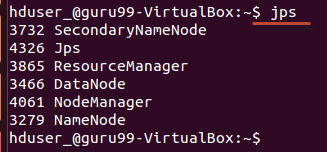
Ako je Hadoop uspješno pokrenut, jps izlaz bi trebao navesti NameNode, NodeManager, ResourceManager, SecondaryNameNode i DataNode.
Korak 6) Zaustaviteping Hadoop
Isključite klaster obrnutim redoslijedom.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

Kako provjeriti radi li Hadoop i ispraviti uobičajene pogreške
Izlaz jps-a potvrđuje da su procesi pokrenuti, ali ne i da je klaster upotrebljiv. Četiri dodatne provjere rješavaju to pitanje.
- Otvorite web sučelje NameNode na
http://localhost:9870(port 50070 na Hadoopu 2.x) i potvrdite sažetak izvješća o jednom aktivnom čvoru. - Otvorite sučelje ResourceManagera na
http://localhost:8088kako bi se potvrdilo da je YARN prihvatio NodeManager. - trčanje
hdfs dfsadmin -reportza kapacitet, aktivne podatkovne čvorove i sve nedovoljno replicirane blokove. - Napiši nešto:
hdfs dfs -mkdir /testnakon čega slijedihdfs dfs -ls /dokazuje da imenski prostor prihvaća promjene.
Većina neuspjeha u prvom pokušaju spada u jednu od pet kategorija.
| Simptom | Izazvati | Popraviti |
|---|---|---|
| JAVA_HOME nije postavljen i nije pronađen | Varijabla se izvozi u .bashrc, ali ne i u hadoop-env.sh | Također postavite apsolutnu JDK putanju unutar hadoop-env.sh |
| Dozvola odbijena (javni ključ, lozinka) na ssh localhostu | authorized_keys nedostaje ili je previše permisivan | Ponovno dodajte id_rsa.pub, a zatim pokrenite chmod 600 na ~/.ssh/authorized_keys |
| Veza odbijena na portu 22 | openssh-server nije instaliran ili ne radi | Instalirajte openssh-server i pokrenite ssh servis |
| DataNode nedostaje iz jps-a nakon ponovnog formatiranja | Cluster Neusklađenost ID-a između formatiranog NameNode-a i starog direktorija DataNode | Ispraznite mapu dfs.datanode.data.dir, a zatim je ponovno formatirajte |
| start-dfs.sh: naredba nije pronađena | HADOOP_HOME i PATH nikada nisu bili preuzeti u trenutnoj ljusci | Pokrenite . ~/.bashrc ili otvorite novi terminal |
