
Kako preuzeti i instalirati NLTK
 Uredništvo
⚡ Pametni sažetak
Preuzmite i instalirajte NLTK na Windows, Mac ili Linux instaliranjem Python prvo, a zatim dodavanje Prirodnog Language Toolkit putem pipa ili Anaconde i preuzimanje skupova podataka korpusa.
Instaliranje NLTK-a u Windows
Naučite kako postaviti NLTK na Windows iz naredbenog retka. Upute u nastavku pretpostavljaju Python još nije instaliran, pa je prvi korak instalacija Python.
Instaliranje Python in Windows
Korak 1) Otvorite vezu https://www.python.org/downloads/, i odaberite najnovije Windows objaviti.
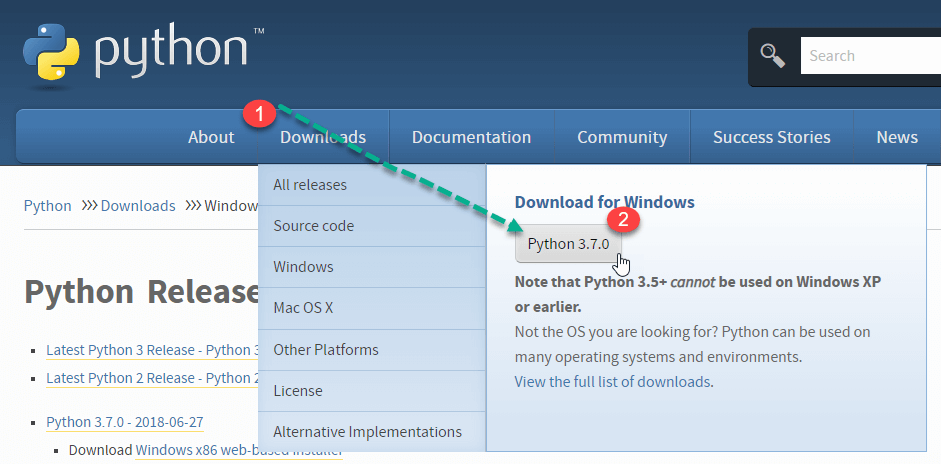
bilješkeZa stariju verziju posjetite karticu Preuzimanja kako biste vidjeli sva izdanja.

Korak 2) Kliknite preuzetu instalacijsku datoteku.
Korak 3) Odaberite Prilagodi instalaciju.
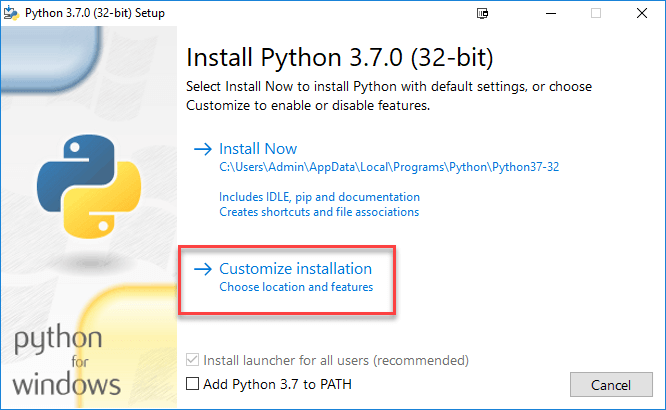
Korak 4) Kliknite DALJE.

Korak 5) Na sljedećem ekranu:
- Odaberite napredne opcije.
- Navedite prilagođenu lokaciju instalacije. U ovom primjeru, mapa na C disku je odabrana radi lakšeg pristupa.
- Kliknite Instaliraj.

Korak 6) Kliknite gumb Zatvori nakon što instalacija završi.

Korak 7) Kopirajte putanju svoje mape Skripte.

Korak 8) u Windows naredbeni redak:
- Idite do lokacije pip mape.
- Unesite naredbu za instalaciju NLTK-a:
pip3 install nltk
- Instalacija bi trebala biti uspješno završena.

BILJEŠKA: Za Python 2, koristite naredbu pip2 install nltk.
Korak 9) Od Windows Izbornik Start, potražite i otvorite Python Ljuska.

Korak 10) Provjerite radi li instalacija pokretanjem naredbe u nastavku:
import nltk

Ako se ne pojavi greška, instalacija je završena.
Instaliranje NLTK-a u Mac/Linux
Instaliranje NLTK-a na Mac ili Linux zahtijeva Python upravitelj paketa pip. Ako pip nije instaliran, slijedite upute u nastavku za dovršetak postupka.
Korak 1) Ažuriraj indeks paketa od strane typing naredba u nastavku:
sudo apt update
Korak 2) Instalirajte pip za Python 3:
sudo apt install python3-pip
Pip možete instalirati i putem easy_install-a:
sudo apt-get install python-setuptools python-dev build-essential
Nakon što je easy_install instaliran, pokrenite sljedeću naredbu za instalaciju pip-a:
sudo easy_install pip
Korak 3) Za instalaciju NLTK-a koristite sljedeću naredbu:
sudo pip install -U nltk
sudo pip3 install -U nltk
Instaliranje NLTK-a kroz Anacondu
Korak 1) Instalirajte Anacondu posjetom https://www.anaconda.com/products/individual i odabirom Python verzija koja vam je potrebna.

Napomena: Pogledajte ovaj vodič za detaljne korake za instaliraj Anacondu.
Korak 2) U Anaconda promptu:
- Unesite naredbu:
conda install -c anaconda nltk
- RevPogledajte informacije o nadogradnji, smanjenju verzije i instalaciji paketa, a zatim unesite da.
- NLTK je preuzet i instaliran.

Skup podataka NLTK
NLTK modul dolazi s mnogim skupovima podataka koje trebate preuzeti prije upotrebe. Tehnički, svaki skup podataka naziva se zbirkaUobičajeni primjeri uključuju zaustavne riječi, Gutenberg, framenet_v15, velike_gramatike, smeđi wordnet.
Kako preuzeti sve pakete NLTK-a
Korak 1) Pokreni Python tumač in Windows ili Linux.
Korak 2)
- Unesite naredbe:
import nltk
nltk.download ()
- Otvara se prozor programa za preuzimanje NLTK-a. Kliknite gumb Preuzmi za preuzimanje skupa podataka. Ovaj postupak traje neko vrijeme ovisno o vašoj internetskoj vezi.

NAPOMENA: Lokaciju preuzimanja možete promijeniti klikom na Datoteka > Promijeni direktorij za preuzimanje.

Korak 3) Za testiranje instaliranih podataka upotrijebite sljedeći kod:
>>> from nltk.corpus import brown
>>>brown.words()
['The', 'Fulton', 'County', 'Grand', 'Jury', 'said', …]

Pokretanje NLP skripte
Ovaj odjeljak objašnjava kako se NLP skripta izvodi na lokalnom računalu. Izbor prave biblioteke ovisi o vašim zahtjevima. Pogledajte službeni popis NLP knjižnice za alternative kao što su spaCy, gensim i TextBlob.
Kako pokrenuti NLTK skriptu
Korak 1) U svom omiljenom uređivaču koda kopirajte kod i spremite datoteku kao NLTKsample.py:
from nltk.tokenize import RegexpTokenizer
tokenizer = RegexpTokenizer(r'\w+')
filterdText=tokenizer.tokenize('Hello Guru99, You have build a very good site and I love visiting your site.')
print(filterdText)

Code Objašnjenje:
- Cilj ovog programa je ukloniti svaku vrstu interpunkcije iz zadanog teksta. Uvezli smo „RegexpTokenizer“, modul od NLTK koji uklanja bilo koji izraz, simbol, znak ili numeričku vrijednost koju odaberete.
- Regularni izraz se prosljeđuje modulu „RegexpTokenizer“.
- Tekst se tokenizira pomoću metode „tokenize“, a izlaz se pohranjuje u varijablu „filterdText“.
- Rezultat se ispisuje pomoću funkcije "print()".
Korak 2) U naredbenom retku:
- Idite do mjesta gdje ste spremili datoteku.
- Pokrenite naredbu
python NLTKsample.py.

Izlaz je:
['Pozdrav', 'Guru99', 'Vi', 'imate', 'izgraditi', 'jedan', 'vrlo', 'dobar', 'mjesto', 'i', 'ja', 'volim', 'posjećujem', 'vaš', 'mjesto']
