
Što je Data Mart u skladištu podataka? Vrste i primjer
 Uredništvo
⚡ Pametni sažetak
Dizajn skladišta podataka pruža fokusirani podskup informacija iz skladišta podataka jednom odjelu, obuhvaćajući tri vrste skladišta podataka, pet faza od dizajna do upravljanja i najbolje prakse koje osiguravaju brzu, sigurnu i isplativu isporuku.
Podatkovno tržište donosi analitičku moć skladište podataka jednom timu. Fokusiranjem na jedno područje omogućuje se odjelu brza analiza vlastitih podataka bez čekanja na radna opterećenja cijelog poduzeća. U odjeljcima u nastavku objašnjava se što je podatkovni skladišni prostor, zašto ga organizacije koriste, tri dostupne vrste te kako ga implementirati i upravljati njime.
Što je Data Mart?
Data mart je usmjeren na jedno funkcionalno područje organizacije i sadrži podskup podataka pohranjenih u Skladište podatakaTo je sažeta verzija skladišta podataka, dizajnirana za korištenje od strane određenog odjela, jedinice ili skupine korisnika - na primjer, marketinga, prodaje, ljudskih resursa ili financija.
Budući da služi jednoj funkciji, podatkovnim skladištem obično upravlja jedan odjel unutar organizacije. Taj fokus održava njegov opseg uskim, a vlasništvo jasnim.
Data mart također crpi podatke iz samo nekoliko izvora, za razliku od skladišta podataka koje integrira mnogo njih. Kao rezultat toga, data martovi su male veličine i daleko fleksibilniji od potpunog skladišta podataka.
Zašto nam je potreban Data Mart?
Organizacije se oslanjaju na podatkovne skladišta iz nekoliko praktičnih razloga:
- Podatkovni centar poboljšava vrijeme odziva korisnika smanjenjem količine podataka koje pretražuju.
- Omogućuje jednostavan pristup često traženim podacima.
- Implementacija podatkovnog skladišta je jednostavnija i jeftinija od implementacije korporativnog skladišta podataka.
- Agilan je: kada se model promijeni, manje podatkovno skladište može se brzo obnoviti.
- Data mart definira jedan stručnjak za određeno područje, dok data warehouse definira interdisciplinarni tim, pa je data mart otvoreniji za promjene.
- Podaci su particionirani, što omogućuje vrlo granularne privilegije kontrole pristupa.
- Podaci se mogu segmentirati i pohraniti na različitim hardverskim ili softverskim platformama.
Ukratko, budući da podatkovno skladište obrađuje manji, dobro definirani dio podataka, brže ga je izgraditi, jeftinije ga je pokrenuti i lakše ga je osigurati od skladišta podataka poduzeća.
Međutim, podatkovni skladišta nisu sva izgrađena na isti način. Izvor iz kojeg skladište crpi podatke određuje s kojom od tri vrste radite.
Vrste Data Marta
Postoje tri glavne vrste podatkovnih skladišta, koje se razlikuju prema izvoru podataka:
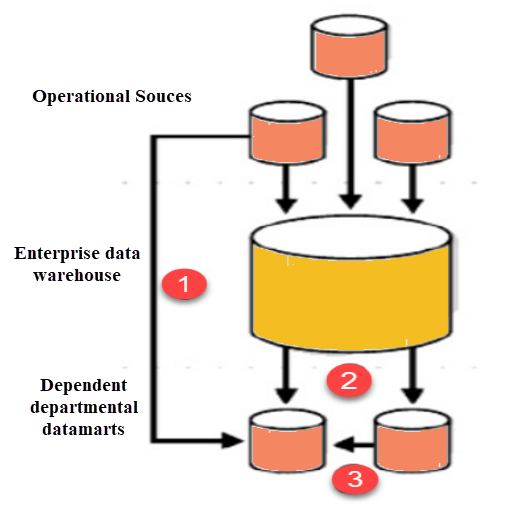
- Ovisno: Ovisni podatkovni skladišta crpe podatke izravno iz operativnih izvora, vanjskih izvora ili oboje.
- Neovisno: Neovisno podatkovno skladište stvara se bez centralnog skladišta podataka.
- Hibrid: Hibridni podatkovni mart može uzimati podatke iz skladišta podataka ili operativnih sustava.
Zavisna baza podataka
Ovisno skladište podataka prikuplja podatke organizacije iz jednog skladišta podataka, što mu daje prednost centralizacije. Ako trebate izgraditi jedno ili više fizičkih skladišta podataka, konfigurirate ih kao ovisna skladišta podataka.
Ovisno skladište podataka može se izgraditi na dva načina: jedan gdje korisnici pristupaju i skladištu podataka i skladištu podataka ovisno o potrebi, i drugi gdje je pristup ograničen samo na skladište podataka. Drugi pristup nije optimalan jer može stvoriti „smetlište podataka“ - podatke koji počinju iz zajedničkog izvora, ali se zatim odbacuju i uglavnom se ne koriste.

Neovisna baza podataka
Neovisno skladište podataka stvara se bez središnjeg skladišta podataka. Ova vrsta skladišta podataka idealna je opcija za manje grupe unutar organizacije.
Neovisno skladište podataka nema nikakve veze s poslovnim skladištem podataka ili bilo kojim drugim skladištem podataka. Njegovi se podaci samostalno učitavaju i analiziraju. Ovaj pristup suprotan je glavnom razlogu za izgradnju skladišta podataka: konzistentnoj, centraliziranoj pohrani poslovnih podataka koju mnogi korisnici s različitim interesima mogu analizirati.

Hybrid Data Mart
Hibridno skladište podataka kombinira ulazne podatke iz izvora izvan skladišta podataka. To pomaže kada vam je potrebna ad-hoc integracija - na primjer, nakon što se organizaciji doda nova grupa ili proizvod.
Dobro je prilagođen okruženjima s više baza podataka i nudi brzu implementaciju uz najmanje napora čišćenja podataka. Hibridni podatkovni mart također podržava velike strukture pohrane i dobro funkcionira za manje aplikacije usmjerene na podatke.
Koraci u implementaciji Datamarta

Implementacija podatkovnog skladišta je nagrađujući, ali detaljan proces. Prolazi kroz pet faza - projektiranje, izgradnju, popunjavanje, pristup i upravljanje - a svaka je opisana u nastavku.
Projektiranje
Dizajniranje je prva faza implementacije skladišta podataka. Obuhvaća svaki zadatak od početnog zahtjeva za skladište podataka do prikupljanja zahtjeva, a završava logičkim i fizičkim dizajnom skladišta podataka.
Korak dizajna uključuje sljedeće zadatke:
- Prikupljanje poslovnih i tehničkih zahtjeva te identificiranje izvora podataka.
- Odabir odgovarajućeg podskupa podataka.
- Projektiranje logičke i fizičke strukture podatkovne vitrine.
Podaci se mogu particionirati na temelju sljedećih kriterija:
- Datum
- Poslovna ili funkcionalna jedinica
- Geografija
- Bilo koja kombinacija gore navedenog
Podaci se mogu particionirati na razini aplikacije ili DBMS-a, iako se particioniranje na razini aplikacije preporučuje jer omogućuje drugačiji model podataka svake godine kako se poslovno okruženje mijenja. Većina podatkovnih skladišta izgrađena je na dimenzionalni model, kao što je zvjezdasta shema, kako bi upiti bili brzi.
Koji su vam proizvodi i tehnologije potrebni?
U ovoj fazi bit će dovoljni jednostavna olovka i papir. Alati koji vam pomažu u izradi UML ili dijagrama entitet-veza također mogu dodati metapodatke vašim logičkim i fizičkim dizajnima.
Izgradnja
Konstruiranje je druga faza implementacije. Uključuje stvaranje fizičke baze podataka i logičkih struktura.
Ovaj korak uključuje sljedeći zadatak:
- Implementacija fizičke baze podataka dizajnirane u ranijoj fazi - na primjer, stvaranje objekata sheme kao što su tablice, indeksi i prikazi.
Koji su vam proizvodi i tehnologije potrebni?
Za izgradnju skladišta podataka potreban vam je sustav za upravljanje relacijskim bazama podataka (RDBMS). RDBMS pruža nekoliko značajki koje su ključne za uspjeh skladišta podataka:
- Upravljanje pohranom: RDBMS pohranjuje i upravlja podacima, omogućujući vam stvaranje, dodavanje i brisanje zapisa.
- Brzi pristup podacima: Pomoću SQL upita možete jednostavno dohvatiti podatke na temelju određenih uvjeta ili filtera.
- Zaštita podataka: RDBMS se može oporaviti od sistemskih kvarova poput nestanka struje i vratiti podatke iz sigurnosnih kopija ako dođe do kvara diska.
- Podrška za više korisnika: Nudi istovremeni pristup, tako da više korisnika može čitati i mijenjati podatke bez prepisivanja promjena jedni drugih.
- Sigurnost: Regulira koji korisnici mogu pristupiti kojim objektima i koje operacije mogu izvoditi.
Punjenje
U trećoj fazi, podaci se unose u podatkovno skladište.
Korak popunjavanja uključuje sljedeće zadatke:
- Kartaping izvornih podataka do ciljnih podataka.
- Extracobrada izvornih podataka.
- Čišćenje i transformacija podataka.
- Učitavanje podataka u podatkovno skladište.
- Stvaranje i pohranjivanje metapodataka.
Koji su vam proizvodi i tehnologije potrebni?
Ove zadatke izvršavate s ETL-om (npr.tract, Transform, Load) alat. Ispituje izvore podataka, izvodi mapiranje izvora u ciljping, a zatim extracts, transformira, čisti i učitava podatke u podatkovno skladište.
Usput, alat također stvara metapodatke - detalje poput podrijetla podataka, njihove nedavne strukture, promjena koje su napravljene i primijenjene razine sažimanja.
Pristup
Pristup je četvrti korak i on stavlja podatke u upotrebu: ispitivanje podataka, izradu izvješća i grafikona te njihovo objavljivanje. Krajnji korisnici šalju upite i pregledavaju rezultate, često putem OLAP alata.
Korak pristupanja uključuje sljedeće zadatke:
- Postavljanje meta sloja koji prevodi strukture baze podataka i nazive objekata u poslovne termine, tako da netehnički korisnici mogu lako pristupiti skladištu podataka.
- Postavljanje i održavanje struktura baze podataka.
- Postavljanje API-ja i sučelja ako je potrebno.
Koji su vam proizvodi i tehnologije potrebni?
Data martu možete pristupiti pomoću naredbenog retka ili grafičkog korisničkog sučelja (GUI). Grafičko korisničko sučelje (GUI) se obično preferira jer lako generira grafove i jednostavnije je za korištenje od naredbenog retka.
Upravljanje
Upravljanje je završna faza procesa implementacije skladišta podataka. Koristeći grafičko korisničko sučelje ili komandnu liniju, timovi obavljaju tekuće zadatke upravljanja kao što su:
- Stalno upravljanje korisničkim pristupom.
- Optimizacija i fino podešavanje sustava za bolje performanse.
- Dodavanje i upravljanje novim podacima u podatkovnom skladištu.
- Planiranje scenarija oporavka kako bi sustav ostao dostupan u slučaju kvara.
- Oporavak od kvarova hardvera i softvera uz očuvanje podataka.
Najbolji primjeri iz prakse za implementaciju podatkovnih martova
Slijedite ove najbolje prakse tijekom cijelog procesa implementacije skladišta podataka:
- Strukturirajte izvor podatkovnog skladišta po odjelima.
- Mjerite ciklus implementacije u tjednima, a ne u mjesecima ili godinama.
- Uključite sve dionike u fazu planiranja i dizajna, jer implementacija podatkovnog skladišta može biti složena.
- Točno planirajte proračun za hardver, softver, umrežavanje i troškove implementacije podatkovnog skladišta.
- Čak i kada podatkovno skladište dijeli hardver, možda će mu trebati drugačiji softver za obradu korisničkih upita; procijenite dodatnu procesorsku snagu i pohranu potrebnu za brze odgovore.
- Kada se podatkovno skladište nalazi na drugoj lokaciji od skladišta podataka, osigurajte dovoljan mrežni kapacitet za premještanje potrebnih količina podataka.
- Proračun za vrijeme učitavanja, koji raste s povećanjem složenosti transformacija.
Prednosti i nedostaci Data Marta
Kao i svaki arhitektonski izbor, podatkovno skladište donosi jasne prednosti uz nekoliko nedostataka.
Prednosti
- Data mart sadrži podskup podataka na razini cijele organizacije koji su vrijedni određenoj skupini korisnika.
- To je isplativa alternativa skladištu podataka, čija izgradnja može biti skupa.
- Data mart omogućuje brži pristup podacima.
- Jednostavan je za korištenje jer je dizajniran za specifične potrebe svojih korisnika, što može ubrzati poslovne procese.
- Data mart zahtijeva manje vremena za implementaciju od data warehousea, budući da se usredotočujete samo na podskup podataka.
- Sadrži povijesne podatke koji pomažu analitičarima u prepoznavanju trendova.
Nedostaci
- Poduzeća ponekad stvaraju previše različitih, nepovezanih podatkovnih skladišta, koja je teško održavati.
- Data mart ne može pružiti analizu podataka cijele tvrtke jer je njegov skup podataka ograničen.
