
Hive ETL: učitavanje JSON, XML, primjeri tekstualnih podataka
 David Carter
⚡ Pametni sažetak
Hive ETL pretvara tekstualne, XML i JSON datoteke u tablice za upite učitavanjem istih u Hive i extracpretvaranje vrijednosti pomoću xpath() i get_json_object(), dajući analitičarima SQL sučelje preko polustrukturiranih Hadoop podataka.

Hive kao ETL i alat za skladištenje podataka na vrhu Hadoop Ekosustav pruža funkcionalnosti poput modeliranja podataka, manipulacije podacima, obrade podataka i upita podataka. Data extracUpravljanje u Hiveu znači stvaranje tablica u Hiveu i učitavanje strukturiranih i polustrukturiranih podataka, kao i ispitivanje podataka na temelju zahtjeva.
Za skupnu obradu, pisat ćemo prilagođene definirane skripte koristeći prilagođene map i reduce skripte u skriptnom jeziku. To pruža SQL poput okruženja i podrške za jednostavno postavljanje upita.
Rad sa strukturiranim podacima pomoću Hive-a
Strukturirani podaci znače da su podaci u ispravnom formatu redaka i stupaca. To je više kao RDBMS podatke s odgovarajućim redovima i stupcima.
Ovdje ćemo učitati strukturirane podatke prisutne u tekstualnim datotekama u Hiveu.
Korak 1) U ovom koraku stvaramo tablicu "employees_guru" s nazivima stupaca kao što su Id, Ime, Dob, Adresa, Plaća i Odjel zaposlenika s tipovima podataka.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Izrada tablice “employees_guru”
- Učitavanje podataka iz Employees.txt u tablicu „employees_guru“
Korak 2) U ovom koraku prikazujemo sadržaj pohranjen u ovoj tablici pomoću naredbe "Select". Sadržaj tablice možemo vidjeti na sljedećoj snimci zaslona.

Primjer isječka koda
Upiti koje treba izvršiti
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
Rad s polustrukturiranim podacima pomoću Hivea (XML, JSON)
Hive obavlja ETL funkcionalnosti u Hadoop ekosustavu djelujući kao ETL alatIzvođenje MapReduce-a u nekim vrstama aplikacija može biti teško; Hive može smanjiti tu složenost i pruža najbolje rješenje za IT aplikacije u sektoru skladištenja podataka.
Polustrukturirani podaci poput XML-a i JSON-a mogu se obraditi s manje složenosti pomoću Hivea. Prvo ćemo vidjeti kako možemo koristiti Hive za XML.
XML u tablicu košnice
U ovom ćemo učitati XML podatke u Hive tablice i dohvatit ćemo vrijednosti pohranjene unutar XML oznaka.
Korak 1) Izrada tablice „xmlsample_guru“ sa stupcem tipa string podataka tipa string.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Izrada tablice “xmlsample_guru”
- Učitavanje podataka iz datoteke test.xml u tablicu „xmlsample_guru“
Korak 2) Korištenje XPath Metodom xpath() moći ćemo dohvatiti podatke pohranjene unutar XML oznaka.
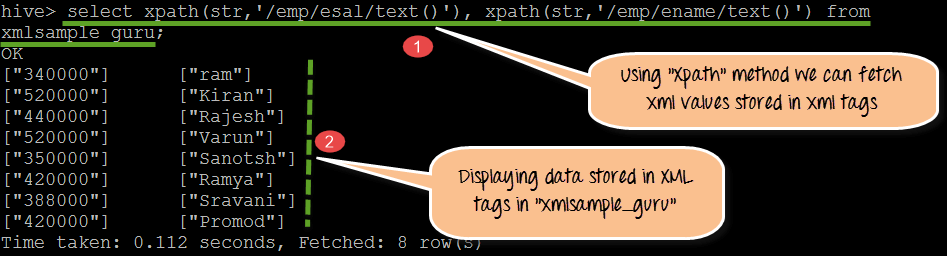
Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Pomoću metode xpath() dohvaćamo vrijednosti pohranjene u /emp/esal/ i /emp/ename/
- Vrijednosti prisutne unutar XML oznaka. U ovom koraku prikazujemo stvarne vrijednosti pohranjene pod XML oznakama u tablici „xmlsample_guru“.
Imajte na umu da xpath() vraća niz stringova; xpath_string(), xpath_int() i xpath_double() vraćaju jednu tipiziranu vrijednost.
Korak 3) U ovom koraku dohvatit ćemo i prikazati sirovi XML tablice „xmlsample_guru“.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Stvarni XML podaci koji se prikazuju s oznakama
- Ako promatramo jednu oznaku, ona ima "emp" kao roditeljsku oznaku s "ename" i "esal" kao podređenim oznakama.
Code isječak:
Upiti koje treba izvršiti
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
JSON (Javazapis objekta skripte)
Podaci društvenih mreža i web-mjesta obično se pohranjuju u JSON formatu. Kad god pokušamo dohvatiti podatke s online poslužitelja, vratit će se JSON datoteke. Korištenjem Hivea kao pohrane podataka možemo učitati JSON podatke u Hive tablice stvaranjem shema.
JSON u Hive tablicu
U ovom ćemo radu učitati JSON podatke u Hive tablice i dohvatit ćemo vrijednosti pohranjene u JSON shemi.
Korak 1) U ovom koraku ćemo stvoriti JSON tablicu pod nazivom „json_guru“. Nakon što je stvorimo, učitavamo i prikazujemo sadržaj stvarne sheme.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Izrada tablice “json_guru”
- Učitavanje podataka iz test.json datoteke u tablicu „json_guru“
- Prikaz stvarne sheme JSON datoteke pohranjene u tablici json_guru
Korak 2) Pomoću metode get_json_object() možemo dohvatiti vrijednosti podataka pohranjene u JSON hijerarhiji.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Korištenjem get_json_object(str,'$.ecode') može se dohvatiti ecode vrijednosti iz tablice json_guru. Slično tome, korištenjem get_json_object(str,'$.ename') i get_json_object(str,'$.sal') dohvatit će se vrijednosti ename i sal iz tablice json_guru.
- Vrijednosti pohranjene unutar JSON hijerarhije u json_guru
Budući da get_json_object() parsira dokument jednom po pozivu, json_tuple() je jeftiniji kada je potrebno nekoliko ključeva, a JSON SerDe mapira dokument na tipizirane stupce prilikom učitavanja.
Code isječak
Upiti koje treba izvršiti
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
Složena JSON u Hive tablicu
U ovom radu ćemo učitati složene JSON podatke u Hive tablice i dohvatit ćemo vrijednosti pohranjene u JSON shemi.
Korak 1) Izrada complexjson_guru s jednim poljem stupca.

Iz gornje snimke zaslona možemo vidjeti sljedeće:
- Izrada tablice complexjson_guru s jednim stupcem kao tipom podataka string
- Učitavanje podataka u complexjson_guru iz emp.json complex JSON datoteke
Korak 2) Korištenjem get_json_object možemo dohvatiti stvarni sadržaj koji je pohranjen unutar hijerarhije JSON datoteka.
Na sljedećoj snimci zaslona možemo vidjeti izlaz podataka pohranjenih u complexjson_guru.
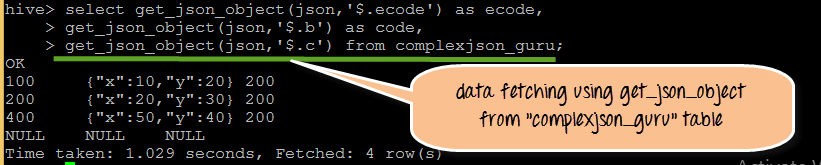
Korak 3) U ovom koraku, korištenjem naredbe "Select" možemo vidjeti složene JSON podatke pohranjene unutar tablice "complexjson_guru".

Primjer isječka koda
Upiti koje treba izvršiti
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
Hive u projektima u stvarnom vremenu – kada i gdje ga koristiti
Kada i gdje koristiti Hive u Hadoop ekosustavu:
Kada
- Pri radu s jakim i moćnim statističkim funkcijama na Hadoop ekosustavu
- Pri radu sa strukturiranom i polustrukturiranom obradom podataka
- Kao alat za skladištenje podataka s Hadoopom
- Unos podataka u stvarnom vremenu pomoću HBase-a, gdje se može koristiti Hive
Gdje
- Za jednostavno korištenje kao ETL i alat za skladištenje podataka
- Za pružanje SQL okruženja i za upite poput SQL-a pomoću HiveQL-a
- Za korištenje i implementaciju prilagođenih specificiranih skripti za mapiranje i reducer za specifične zahtjeve klijenta
