
Vodič za Apache Flume: Što je, Archiprimjer teksture i Hadoopa
 Prafulla Ranadive
⚡ Pametni sažetak
Apache Flume je distribuirana usluga za prikupljanje, agregiranje i premještanje velikih količina podataka zapisnika u HDFS, izgrađena oko agenata koji povezuju izvor, kanal i odvod.
Što je Apache Flume u Hadoopu?
Apache Flume je pouzdan i distribuiran sustav za prikupljanje, agregiranje i premještanje ogromnih količina podataka zapisnika. Ima jednostavnu, ali fleksibilnu arhitekturu temeljenu na strujanju podataka. Apache Flume se koristi za prikupljanje podataka zapisnika prisutnih u datotekama zapisnika s web poslužitelja i njihovo agregiranje u HDFS za analizu.
Flume u Hadoopu podržava više izvora, uključujući:
- 'tail' (koji prenosi podatke iz lokalne datoteke i zapisuje ih u HDFS putem Flumea, slično Unix naredbi 'tail')
- Dnevnici sustava
- Apache log4j (što omogućuje Java aplikacije za pisanje događaja u datoteke u HDFS putem Flumea).
Trenutno izdanje je Flume 1.11.0, objavljeno 25. listopada 2022. i dostupno od Stranica za preuzimanje Apache FlumeaOvaj vodič je napisan za verziju 1.4.0, tako da nekoliko koraka u nastavku nosi napomenu gdje se trenutno izdanje ponaša drugačije.
Žlijeb Architektura
Flume agent je JVM proces s tri komponente – izvorom cijevne cijevi, kanalom cijevne cijevi i ponorom cijevne cijevi – kroz koje se događaji šire nakon što su pokrenuti na vanjskom izvoru. Donji dijagram prikazuje kako su povezani.
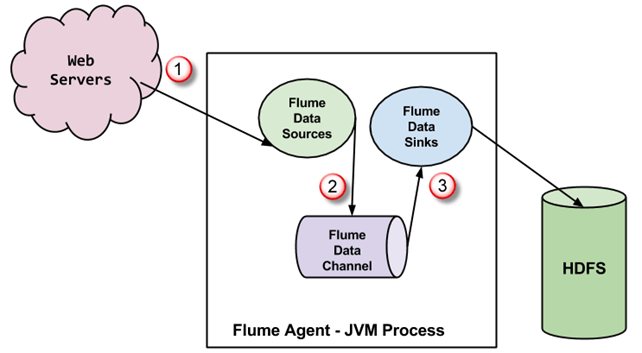
- Događaje koje generira vanjski izvor (web poslužitelj) koristi Flume izvor. Vanjski izvor šalje događaje Flume izvoru u formatu koji ciljni izvor prepoznaje.
- Flume izvor prima događaj i pohranjuje ga u jedan ili više kanala. Kanal djeluje kao spremište koje čuva događaj dok ga Flume sink ne iskoristi. Ovaj kanal može koristiti lokalni datotečni sustav za pohranu tih događaja.
- Flume sink uklanja događaj iz kanala i pohranjuje ga u vanjsko spremište kao što je HDFS. Može postojati više Flume agenata, u kojem slučaju Flume sink prosljeđuje događaj Flume izvoru sljedećeg agenta u toku.
Neke važne značajke Flumea
- Flume ima fleksibilan dizajn temeljen na streamingu podataka. Toleran je na greške i robustan, s više mehanizama za prebacivanje u slučaju kvara i oporavak. Flume nudi različite razine pouzdanosti, uključujući 'najbolja isporuka' i 'dostava od kraja do kraja'. Najbolja isporuka ne tolerira nikakav kvar čvora Flume, dok isporuka od kraja do kraja jamči isporuku čak i u slučaju kvara više čvorova.
- Flume prenosi podatke između izvora i odvoda. Ovo prikupljanje podataka može biti zakazano ili vođeno događajima. Flume ima vlastiti mehanizam za obradu upita, što olakšava transformaciju svake nove serije podataka prije nego što se premjesti u namijenjeni odvod.
- Moguć Žlijebni umivaonici uključuju HDFS i HBaseFlume također može prenositi podatke o događajima kao što su podaci o mrežnom prometu, podaci generirani web stranicama društvenih medija i e-poruke.
Postavljanje kanala, biblioteke i izvornog koda
Prije nego što započnemo sa stvarnim postupkom, provjerite imate li instaliran Hadoop; ako nije, prođite kroz kako instalirati Hadoop Prvo. Promijenite korisnika u 'hduser' (id koji se koristi prilikom konfiguriranja Hadoop-a; možete se prebaciti na korisnički ID koji se koristi tijekom vlastite konfiguracije Hadoop-a).

Korak 1) Izradite novi direktorij s nazivom 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Dajte dozvole za čitanje, pisanje i izvršavanje.
sudo chmod -R 777 FlumeTutorial
- Kopirajte datoteke MyTwitterSource.java i MyTwitterSourceForFlume.java u ovaj direktorij.
Preuzmite ulazne datoteke odavde
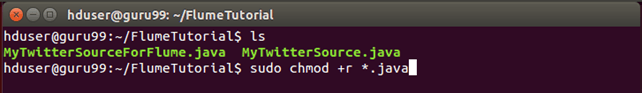
Provjerite dozvole za sve te datoteke, kao što je prikazano u nastavku, i dodijelite dozvolu za 'čitanje' ako nedostaje.
Korak 2) Preuzmite 'Apache Flume' s https://flume.apache.org/download.html.
Apache Flume 1.4.0 korišten je u ovom vodiču za Flume.

Zatim kliknite na ogledalo.

Korak 3) Kopirajte preuzetu tarball datoteku u direktorij po vašem izboru i extracsadržaj pomoću sljedeće naredbe.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Ovim se stvara novi direktorij pod nazivom apache-flume-1.4.0-bin i extracts datoteke u njega. Taj se direktorij naziva u ostatku članka.
Korak 4) Postavljanje Flume biblioteke. Kopirajte twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar i flume-ng-sdk-1.4.0.jar u
/lib/
Jedan ili svi kopirani JAR-ovi mogu imati postavljeno dopuštenje za izvršavanje, što može uzrokovati problem s kompajliranjem koda, stoga ga poništite. U mom slučaju, twitter4j-core-4.0.1.jar je imao dopuštenje za izvršavanje. Poništio sam ga kao što je prikazano u nastavku.
sudo chmod -x twitter4j-core-4.0.1.jar

Nakon toga, naredba u nastavku daje svima dopuštenje za 'čitanje' na twitter4j-core-4.0.1.jar.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Imajte na umu da sam preuzeo twitter4j-core-4.0.1.jar sa Maven repozitoriji sve Flume JAR-ove, tj. flume-ng-*-1.4.0.jar, iz artefakti org.apache.flume.
Učitajte podatke s Twittera pomoću Flumea
Korak 1) Idite u direktorij koji sadrži datoteke izvornog koda.
Korak 2) Postavi CLASSPATH da sadrži /lib/* i ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Korak 3) Kompajlirajte izvorni kod pomoću naredbe u nastavku.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Korak 4) Izradite JAR. Prvo stvorite datoteku Manifest.txt pomoću uređivača teksta po vašem izboru i dodajte joj redak ispod.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Ovdje je flume.mytwittersource.MyTwitterSourceForFlume naziv glavne klase. Imajte na umu da morate pritisnuti tipku Enter na kraju ovog retka, kao što je prikazano dolje.

Sada stvorite JAR 'MyTwitterSourceForFlume.jar' na sljedeći način.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

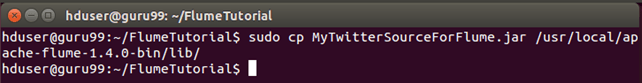
Korak 5) Kopiraj ovaj JAR u /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Korak 6) Idite u konfiguracijski direktorij Flumea, /konf.
Ako datoteka flume.conf ne postoji, kopirajte datoteku flume-conf.properties.template i preimenujte je u flume.conf.
sudo cp flume-conf.properties.template flume.conf

Ako flume-env.sh ne postoji, kopirajte flume-env.sh.template i preimenujte ga u flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Izrada Twitter aplikacije
Prvo pročitajte ovo. Streaming v1.1 statuses/filter Krajnja točka koja je potrebna twitter4j 4.0.1 ukinuta je 9. ožujka 2023., a filtrirani stream API v2 koji ju je zamijenio, sada je na developer.x.com, nalazi se iza plaćene razine. Tretirajte zaslone u nastavku kao uzorak prilagođenog izvora, a zatim usmjerite istog agenta na datoteku, izvršnu datoteku ili Kafka izvor.
Korak 1) Izradite Twitter aplikaciju prijavom na portal za razvojne programere.


Korak 2) Idite na 'Moje aplikacije' (ova se opcija otvara klikom na gumb 'Jaje' u gornjem desnom kutu).

Korak 3) Izradite novu aplikaciju klikom na 'Izradi novu aplikaciju'.
Korak 4) Ispunite podatke o aplikaciji navodeći naziv aplikacije, opis i web-stranicu. Možete se pozvati na napomene ispod svakog polja za unos.
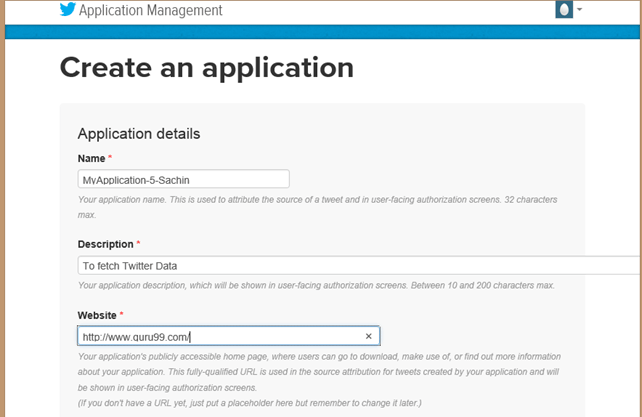
Korak 5) Pomaknite se prema dolje po stranici, prihvatite uvjete označavanjem 'Da, slažem se' i kliknite gumb 'Izradite svoju Twitter aplikaciju'.

Korak 6) U prozoru novostvorene aplikacije idite na karticu 'API ključevi', pomaknite se prema dolje po stranici i kliknite gumb 'Kreiraj moj pristupni token'.


Korak 7) Osvježite stranicu.
Korak 8) Kliknite na 'Testiraj OAuth'. Prikazat će se postavke 'OAuth' aplikacije.

Korak 9) Izmijenite 'flume.conf' pomoću ovih OAuth postavki. Koraci za izmjenu 'flume.conf' navedeni su u nastavku.

Moramo kopirati ključ potrošača, tajnu potrošača, pristupni token i tajnu pristupnog tokena kako bismo ažurirali 'flume.conf'.
Napomena: Ove vrijednosti pripadaju korisniku i stoga su povjerljive, stoga ih ne treba dijeliti.
Izmijenite datoteku 'flume.conf'
Korak 1) Otvorite 'flume.conf' u načinu pisanja i postavite vrijednosti za dolje navedene parametre.
sudo gedit flume.conf
Kopirajte sadržaj ispod.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Korak 2) Također, postavite TwitterAgent.sinks.HDFS.hdfs.path kao što je prikazano u nastavku.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/tweetovi/

Pronaći , i , pogledajte vrijednost parametra 'fs.defaultFS' postavljenog u $HADOOP_HOME/etc/hadoop/core-site.xml, prikazanu u nastavku.

Korak 3) Kako biste podatke prebacili na HDFS čim stignu, izbrišite donji unos ako postoji.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Primjer: Streaming Twitter podataka pomoću Flumea
Korak 1) Otvorite 'flume-env.sh' u načinu pisanja i postavite vrijednosti za dolje navedene parametre.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Korak 2) Pokrenite Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Korak 3) Dvije JAR datoteke iz Flume tarballa nisu kompatibilne s Hadoopom 2.2.0, pa u ovom primjeru Apache Flumea slijedimo dolje navedene korake kako bismo Flume učinili kompatibilnim s Hadoopom 2.2.0. Ova JAR zamjena je ispravak iz ere 1.4.0; Flume 1.11.0 već isporučuje trenutne protobuf i Guava verzije, tako da modernom tarballu obično nije potrebno ništa od toga.
a. Premjestite protobuf-java-2.4.1.jar iz ' /lib'. Prvo idite u taj direktorij.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Pronađite JAR datoteku 'guava' kao što je prikazano dolje.
find . -name "guava*"

Premjestite guava-10.0.1.jar iz mape ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Preuzmite guava-17.0.jar s Maven repozitorij, prikazano ispod.

Sada kopirajte ovu preuzetu JAR datoteku u ' /lib'.
Korak 4) Idi na ' /bin' i pokrenite Flume na sljedeći način.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Prozor naredbenog retka u kojem Flume dohvaća tweetove izgleda ovako.

Iz poruke naredbenog prozora možemo vidjeti da se izlaz zapisuje u direktorij /user/hduser/flume/tweets/. Sada otvorite taj direktorij pomoću web preglednika.
Korak 5) Za pregled rezultata učitavanja podataka, otvorite http://localhost:50070/ u pregledniku, pregledajte datotečni sustav, a zatim idite u direktorij u koji su učitani podaci, tj.
/flume/tweetovi/
Port 50070 je web sučelje NameNodea na Hadoopu 2; Hadoop 3 je premjestio istu stranicu na port 9870.

Žljeb je jedna polovica gutanja: Sqoop uvozi tablice u serijama, Flume struji događaje, a zatim Svinja or Košnica oblikujte datoteke i Oozie raspoređuje lanac. Vidi također alati za analizu velikih podataka, MapReduce spojevi i brojači i Talend.
