
SAP HANA Archiसंरचना: डेटाबेस का अवलोकन
 मेसन गार्सिया
⚡ स्मार्ट सारांश
SAP HANA ArchiSUSE Linux पर निर्मित इन-मेमोरी डेटा प्लेटफ़ॉर्म की नींव संरचना, परिदृश्य और आकार पर आधारित है। C++यह लेख इंडेक्स सर्वर, स्टोरेज इंजन, रो और कॉलम स्टोर, डेल्टा मर्ज और हार्डवेयर साइजिंग विधियों की व्याख्या करता है।
एचएमबी क्या है? SAP हाना डेटाबेस?
SAP HANA एक मुख्य मेमोरी-केंद्रित डेटा प्रबंधन प्लेटफॉर्म है। यह डेटाबेस SUSE Linux Enterprise Server (SLES) पर चलता है और Red Hat Enterprise Linux (आरएचईएल) और इसे लिखा गया है C++यह बहुत बड़े कार्यभार के लिए कई मशीनों पर विस्तारित हो सकता है।
के प्रमुख लाभ SAP हाना:
- अत्यंत तीव्र क्वेरी प्रदर्शन क्योंकि सारा डेटा मेमोरी में लोड हो जाता है, जिससे धीमे डिस्क I/O को महत्वपूर्ण पथ से हटा दिया जाता है।
- एक ही डेटाबेस पर मिश्रित OLAP (ऑनलाइन एनालिटिकल प्रोसेसिंग) और OLTP (ऑनलाइन ट्रांजैक्शन प्रोसेसिंग) का उपयोग करके डेटा परिदृश्य को सरल बनाया जा सकता है।
SAP HANA डेटाबेस इन-मेमोरी प्रोसेसिंग इंजनों के एक समूह से निर्मित है। कैलकुलेशन इंजन मुख्य इंजन है और यह अन्य इंजनों जैसे रिलेशनल इंजन (पंक्ति और स्तंभ भंडार), OLAP इंजन, टेक्स्ट इंजन और ग्राफ इंजन के साथ परस्पर क्रिया करता है। एक रिलेशनल टेबल या तो पंक्ति भंडार में या स्तंभ भंडार में रहती है, और अतिरिक्त इंजन मेमोरी उपलब्ध होने पर टेक्स्ट और ग्राफ डेटा को संभालते हैं।
SAP HANA Archiटेक्चर
कॉलम स्टोर में मौजूद डेटा को डिक्शनरी एन्कोडिंग, रन-लेंथ एन्कोडिंग, स्पार्स एन्कोडिंग, क्लस्टर एन्कोडिंग और इनडायरेक्ट एन्कोडिंग जैसी तकनीकों का उपयोग करके संपीड़ित किया जाता है। मुख्य मेमोरी की सीमा पूरी हो जाने पर, उपयोग में न आने वाली डेटाबेस वस्तुएं (टेबल, व्यू आदि) स्वचालित रूप से डिस्क पर स्थानांतरित कर दी जाती हैं और पुनः अनुरोध किए जाने पर पुनः लोड कर दी जाती हैं।
प्रशासक किसी भी टेबल पर राइट-क्लिक करके उसे मैन्युअल रूप से लोड या अनलोड कर सकते हैं। SAP हाना स्टूडियो और चुनने उतारना or भार.
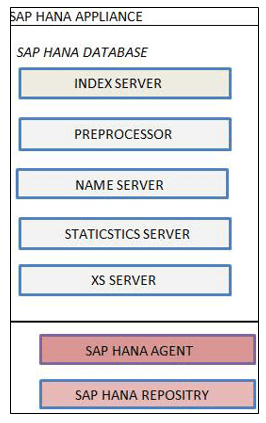
SAP HANA सर्वर में निम्नलिखित शामिल हैं:
- इंडेक्स सर्वर
- प्रीप्रोसेसर सर्वर
- नाम सर्वर
- सांख्यिकी सर्वर
- एक्सएस इंजन
1. SAP हाना इंडेक्स सर्वर
इंडेक्स सर्वर मुख्य है SAP HANA डेटाबेस घटक:
- यह इसका हृदय है SAP हाना डेटाबेस इंजन।
- इसमें वास्तविक डेटा भंडार और डेटा को संसाधित करने वाले इंजन शामिल हैं।
- यह आने वाले SQL और MDX स्टेटमेंट को निष्पादित करता है।
इंडेक्स सर्वर की वास्तुकला नीचे दर्शाई गई है।

SAP HANA इंडेक्स सर्वर अवलोकन
- सत्र और लेनदेन प्रबंधक: सेशन कंपोनेंट डेटाबेस के लिए कनेक्शन और सेशन का प्रबंधन करता है। ट्रांजैक्शन मैनेजर सभी लेनदेन का समन्वय और नियंत्रण करता है।
- SQL और MDX प्रोसेसर: SQL प्रोसेसर उपयुक्त इंजन (SQL / SQL स्क्रिप्ट / R / कैलकुलेशन इंजन) को क्वेरी भेजता है। MDX प्रोसेसर बहुआयामी क्वेरी (उदाहरण के लिए, एनालिटिक व्यू के विरुद्ध) को संभालता है।
- SQL / SQL स्क्रिप्ट / R / Calc इंजन: यह डेटा पर SQL, SQL स्क्रिप्ट, R और गणना मॉडल को निष्पादित करता है।
- भंडार: वर्ज़निंग को बनाए रखता है SAP HANA मेटाडेटा ऑब्जेक्ट जैसे कि एट्रीब्यूट व्यू, एनालिटिक व्यू और स्टोर्ड प्रोसीजर।
- परसिस्टेंस लेयर: यह डिस्क पर डेटा वॉल्यूम में सेवपॉइंट और लॉग लिखकर अंतर्निहित आपदा-पुनर्प्राप्ति क्षमता प्रदान करता है।
2. प्रीप्रोसेसर सर्वर
प्रीप्रोसेसर सर्वर का उपयोग टेक्स्ट एनालिसिस द्वारा किया जाता है।tracयह सर्च फंक्शन को कॉल किए जाने पर टेक्स्ट कंटेंट से डेटा तैयार करता है।
3. नाम सर्वर
नेम सर्वर संपूर्ण सिस्टम परिदृश्य के बारे में जानकारी रखता है। एक वितरित परिनियोजन में यह tracयह प्रत्येक चल रहे घटक और नोड्स में डेटा के स्थान को ट्रैक करता है, ताकि प्रश्नों को सही सर्वर पर भेजा जा सके।
4. सांख्यिकी सर्वर
सांख्यिकी सर्वर स्थिति, संसाधन आवंटन, खपत और प्रदर्शन संबंधी डेटा एकत्र करता है। SAP HANA सिस्टम। ध्यान दें: HANA SPS 7 और उसके बाद के संस्करणों में, एम्बेडेड सांख्यिकी सेवा एक स्टैंड-अलोन प्रक्रिया के बजाय इंडेक्स सर्वर के अंदर चलती है।
5. एक्सएस सर्वर
XS सर्वर XS इंजन को होस्ट करता है, जो बाहरी एप्लिकेशन और डेवलपर्स को इसका उपयोग करने की अनुमति देता है। SAP HANA डेटाबेस HTTP पर आधारित है। XS इंजन स्वयं एक हल्के HTTP सर्वर के रूप में कार्य करता है, जिससे ब्राउज़र-आधारित और REST क्लाइंट सीधे HANA से संवाद कर सकते हैं।
SAP हाना लैंडस्केप
“HANA” का अर्थ है उच्च प्रदर्शन विश्लेषणात्मक उपकरण और इसे हार्डवेयर और सॉफ्टवेयर के संयुक्त प्लेटफॉर्म के रूप में उपलब्ध कराया जाता है।
- आधुनिक हार्डवेयर में पुराने डेटाबेस सर्वरों की तुलना में कहीं अधिक सीपीयू कोर, रैम और स्टोरेज बैंडविड्थ उपलब्ध है, जिन्हें उपयोग करने के लिए डिज़ाइन किया गया था।
- SAP HANA इसका फायदा उठाकर इसे बनाए रखती है।ping सभी कार्यशील डेटा मुख्य मेमोरी में संग्रहीत होता है, जिससे डिस्क आई/ओ की वह बाधा दूर हो जाती है जो पारंपरिक डेटाबेस को सीमित करती है।
नीचे दिया गया आरेख संक्षेप में प्रस्तुत करता है SAP हाना हार्डवेयर और सॉफ्टवेयर नवाचार।

SAP HANA दो रिलेशनल डेटा स्टोर को सपोर्ट करता है: रो स्टोर और कॉलम स्टोर.
रो स्टोर
रो स्टोर एक पारंपरिक डेटाबेस की तरह व्यवहार करता है (Oracle(SQL सर्वर)। मुख्य अंतर यह है कि सभी पंक्तियाँ मुख्य मेमोरी में रहती हैं। SAP HANA में, पारंपरिक डेटाबेस उन्हें मुख्य रूप से डिस्क पर रखता है।
कॉलम स्टोर
कॉलम स्टोर मेमोरी में डेटा को कॉलम के रूप में रखता है। कॉलम टेबल यहीं स्टोर की जाती हैं और इंजन बेहतर राइट परफॉर्मेंस और ऑप्टिमाइज्ड रीड परफॉर्मेंस के बीच संतुलन बनाए रखता है। नीचे दिया गया आरेख उन दो संरचनाओं को दर्शाता है जो इस संतुलन को प्राप्त करती हैं।

मुख्य भंडारण
मुख्य संग्रहण में अधिकांश डेटा संग्रहित होता है। मेमोरी बचाने और खोजों को गति देने के लिए डिक्शनरी एन्कोडिंग, क्लस्टर एन्कोडिंग, स्पार्स एन्कोडिंग और रन-लेंथ एन्कोडिंग जैसी संपीड़न विधियों का उपयोग किया जाता है।
- मुख्य स्टोरेज में संपीड़ित डेटा को सीधे संशोधित करना महंगा होता है, इसलिए राइट ऑपरेशन मुख्य स्टोरेज को लक्षित नहीं करते हैं।
- इसके बजाय, प्रत्येक परिवर्तन को एक अलग क्षेत्र में लिखा जाता है जिसे कहा जाता है Delta भंडारणरीड ऑपरेशन मुख्य या डेल्टा स्टोरेज दोनों पर किए जा सकते हैं।
डेटा को मैन्युअल रूप से लोड या अनलोड किया जा सकता है। मेमोरी में लोड करें और मेमोरी से अनलोड करें नीचे विकल्प दिखाए गए हैं।

Delta भंडारण
Delta यह स्टोरेज राइट ऑपरेशन के लिए ऑप्टिमाइज़्ड है और हल्के कंप्रेशन का उपयोग करता है। कॉलम टेबल में किए गए सभी अनकमिटेड बदलाव यहीं रखे जाते हैं। जब बदलावों को वापस मेन स्टोरेज में मर्ज करने की आवश्यकता हो, तो निम्नलिखित कमांड चलाएँ। Delta मर्ज से संचालन SAP हाना स्टूडियो.

- डेल्टा मर्ज, डेल्टा स्टोरेज में एकत्रित परिवर्तनों को मुख्य स्टोरेज में स्थानांतरित करता है।
- विलय के बाद, नई मुख्य संग्रहण सामग्री को डिस्क पर स्थायी रूप से सहेजा जाता है और संपीड़न की पुनर्गणना की जाती है।
डेटा किस प्रकार स्थानांतरित होता है Delta मुख्य भंडारण के लिए

एक पंक्ति-संगठित बफर जिसे कहा जाता है एल1-Delta यह प्रत्येक कॉलम टेबल के सामने स्थित होता है, यही कारण है कि एक कॉलम टेबल उच्च-थ्रूपुट लेखन को अवशोषित कर सकता है।
- उपयोगकर्ता टेबल के विरुद्ध UPDATE या INSERT ऑपरेशन चलाता है।
- डेटा सबसे पहले L1 में आता है-Delta (अप्रतिबद्ध डेटा)।
- एक बार डेटा सबमिट हो जाने के बाद, उसे कॉलम-ओरिएंटेड L2 में स्थानांतरित कर दिया जाता है।Delta बफर.
- जब L2-Delta यदि स्टोरेज भर जाता है या मर्ज प्रक्रिया चलती है, तो डेटा मुख्य स्टोरेज में लिखा जाता है।
इसलिए कॉलम स्टोरेज राइट-ऑप्टिमाइज्ड (L1 और L2 डेल्टा के माध्यम से) और रीड-ऑप्टिमाइज्ड (मुख्य स्टोरेज के माध्यम से) दोनों है। प्रोसेसिंग के बाद, डेटा को परसिस्टेंस लेयर द्वारा डिस्क पर सेव किया जाता है।
पंक्ति-आधारित तालिका का उदाहरण:

स्टोर के प्रकार के आधार पर एक ही लॉजिकल टेबल को डिस्क पर अलग-अलग तरीके से स्टोर किया जाता है। रो स्टोर में, पंक्तियाँ लगातार लिखी जाती हैं:

कॉलम स्टोर में, एक ही कॉलम के मान एक साथ संग्रहीत किए जाते हैं:

क्योंकि कॉलम के मान एक ही डेटा प्रकार साझा करते हैं और अक्सर दोहराए जाते हैं, इसलिए कॉलम लेआउट बहुत अच्छी तरह से संपीड़ित हो जाता है - जो कॉलम स्टोर का मुख्य मेमोरी लाभ है।

SAP हाना आकार
साइजिंग एक ऐसी प्रक्रिया है जिसके द्वारा किसी कंप्यूटर के लिए आवश्यक हार्डवेयर संसाधनों — रैम, डिस्क और सीपीयू — का निर्धारण किया जाता है। SAP हाना सिस्टम। मेमोरी सबसे महत्वपूर्ण कारक है, सीपीयू दूसरे स्थान पर है, और डिस्क पहले दो कारकों से व्युत्पन्न होती है।
में SAP HANA को लागू करते समय, व्यावसायिक कार्यभार के लिए सही सर्वर आकार का चयन करना सबसे महत्वपूर्ण कार्यों में से एक है। पारंपरिक DBMS की तुलना में, HANA का आकार तीन क्षेत्रों में भिन्न होता है:
- मुख्य मेमोरी: यह मेटाडेटा के साथ-साथ मेमोरी में मौजूद लेनदेन संबंधी और विश्लेषणात्मक डेटा की मात्रा से संचालित होता है।
- सीपीयू: पूर्वानुमान क्वेरी और लोड पैटर्न के आधार पर, मापा नहीं जाता बल्कि अनुमान लगाया जाता है।
- डिस्क: इसका आकार डेटा की स्थिरता और लॉग वॉल्यूम के लिए निर्धारित किया गया है, न कि ऑनलाइन क्वेरी डेटा के लिए।
एप्लिकेशन सर्वर का सीपीयू और मेमोरी पिछले डेटाबेस की तुलना में अपरिवर्तित रहता है, क्योंकि हाना केवल डेटाबेस टियर को प्रतिस्थापित करता है।
SAP सही आकार की गणना करने के लिए कई तरीके प्रदान करता है:
- ABAP रिपोर्ट (लेनदेन कोड) का उपयोग करके आकार निर्धारण ST03 डेटा और रिपोर्ट /एसडीएफ/एचडीबी_साइज़िंग).
- गैर-ABAP सिस्टम के लिए डेटाबेस स्क्रिप्ट का उपयोग करके आकार निर्धारण करना।
- साइजिंग का उपयोग करके SAP क्विक साइज़र उपकरण पर SAP सेवा बाज़ार।
क्विक साइजर टूल का उपयोग करने पर, आवश्यकता नीचे दिए गए प्रारूप में प्रदर्शित होती है।

