
डेटाबेस मैनेजमेंट सिस्टम में रिलेशनल डेटा मॉडल: Concepts & उदाहरण
 फियोना ब्राउन
⚡ स्मार्ट सारांश
रिलेशनल मॉडल डेटाबेस को संबंधों के संग्रह के रूप में दर्शाता है, जहाँ प्रत्येक संबंध पंक्तियों और स्तंभों की एक तालिका होती है। यह उन मूलभूत अवधारणाओं, अखंडता संबंधी बाधाओं और अद्यतन संक्रियाओं को परिभाषित करता है जो रिलेशनल डेटा को सुसंगत और क्वेरी करने में आसान बनाए रखती हैं।
संबंधपरक मॉडल क्या है?
रिलेशनल मॉडल (आरएम) डेटाबेस को संबंधों के संग्रह के रूप में दर्शाता है। संबंध कुछ और नहीं बल्कि मूल्यों की एक तालिका है। तालिका में प्रत्येक पंक्ति संबंधित डेटा मानों के संग्रह का प्रतिनिधित्व करती है। तालिका में ये पंक्तियाँ वास्तविक दुनिया की इकाई या संबंध को दर्शाती हैं।
तालिका और स्तंभों के नाम प्रत्येक पंक्ति में मौजूद मानों का अर्थ समझने में सहायक होते हैं। डेटा को संबंधों के एक समूह के रूप में दर्शाया जाता है। संबंधपरक मॉडल में, डेटा को तालिकाओं के रूप में संग्रहित किया जाता है। हालांकि, डेटा का भौतिक भंडारण, डेटा के तार्किक संगठन से स्वतंत्र होता है।
इस मॉडल का प्रस्ताव ईएफ कॉड ने 1970 में दिया था और यह आज भी उपयोग में आने वाले लगभग हर मुख्यधारा के डेटाबेस का आधार बना हुआ है। कुछ लोकप्रिय रिलेशनल डेटाबेस मैनेजमेंट सिस्टम इस प्रकार हैं:
- DB2 और इन्फॉर्मिक्स डायनेमिक सर्वर – IBM
- Oracle और आरडीबी – Oracle
- SQL सर्वर और एक्सेस – Microsoft
संबंधपरक मॉडल Concepts डीबीएमएस में
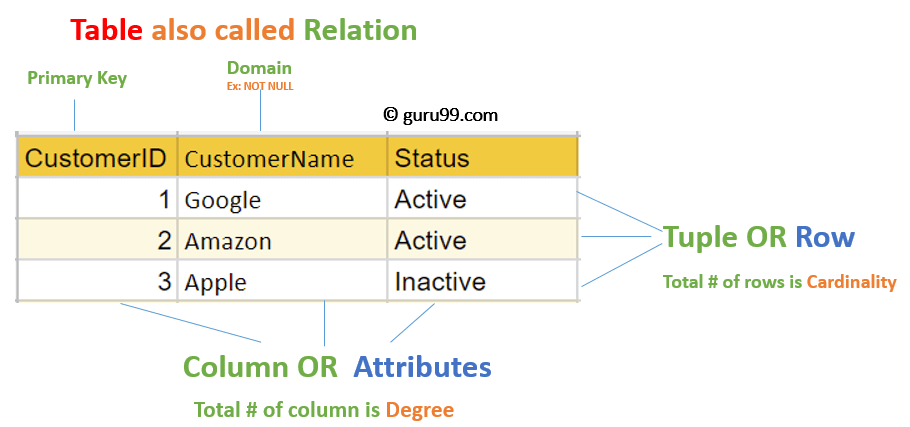
- विशेषता: तालिका में प्रत्येक स्तंभ। विशेषताएँ वे गुण हैं जो संबंध को परिभाषित करते हैं, जैसे, छात्र का नाम संख्या, नाम, आदि।
- टेबल्स: रिलेशनल मॉडल में, रिलेशंस को टेबल फॉर्मेट में सहेजा जाता है। इसे इसकी एंटिटीज़ के साथ स्टोर किया जाता है। एक टेबल में दो प्रॉपर्टीज़ होती हैं, पंक्तियाँ और कॉलम। पंक्तियाँ रिकॉर्ड्स को दर्शाती हैं और कॉलम एट्रीब्यूट्स को।
- टपल: यह टेबल की एक पंक्ति मात्र है, जिसमें एक ही रिकॉर्ड होता है।
- संबंध स्कीमा: संबंध स्कीमा संबंध के नाम को उसकी विशेषताओं के साथ प्रदर्शित करती है।
- डिग्री: संबंध में मौजूद विशेषताओं की कुल संख्या को संबंध की डिग्री कहा जाता है।
- कार्डिनैलिटी: तालिका में मौजूद पंक्तियों की कुल संख्या।
- स्तंभ: स्तंभ किसी विशिष्ट विशेषता के लिए मानों के समूह को दर्शाता है।
- संबंध उदाहरण: रिलेशन इंस्टेंस, RDBMS सिस्टम में टुपल्स का एक सीमित समूह होता है। रिलेशन इंस्टेंस में कभी भी डुप्लिकेट टुपल्स नहीं होते हैं।
- संबंध कुंजी: प्रत्येक पंक्ति में एक, दो या एक से अधिक विशेषताएँ होती हैं, जिसे संबंध कुंजी कहा जाता है।
- विशेषता डोमेन: प्रत्येक विशेषता का एक पूर्वनिर्धारित मान और दायरा होता है, जिसे विशेषता डोमेन के रूप में जाना जाता है।
शब्दावली तैयार हो जाने के बाद, अगली चिंता इसे बनाए रखना है।ping उन संबंधों में मौजूद डेटा वैध है, जो कि अखंडता संबंधी बाधाओं का काम है।
संबंधपरक Integrity की कमी
डेटाबेस मैनेजमेंट सिस्टम (DBMS) में संबंध अखंडता संबंधी बाधाएँ उन शर्तों को संदर्भित करती हैं जो एक वैध संबंध के लिए आवश्यक हैं। ये संबंध संबंधी बाधाएँ डेटाबेस द्वारा दर्शाए गए लघु-जगत के नियमों से प्राप्त होती हैं।
अखंडता संबंधी बाधाओं के कई प्रकार होते हैं। रिलेशनल डेटाबेस प्रबंधन प्रणाली पर बाधाओं को मुख्य रूप से तीन श्रेणियों में विभाजित किया जाता है:
- डोमेन प्रतिबंध
- प्रमुख बाधाएं
- संदर्भ Integrity की कमी
डोमेन प्रतिबंध
डोमेन संबंधी बाधाओं का उल्लंघन तब हो सकता है जब किसी विशेषता का मान संबंधित डोमेन में मौजूद न हो, या यदि वह उपयुक्त डेटा प्रकार का न हो।
डोमेन प्रतिबंध यह निर्दिष्ट करते हैं कि प्रत्येक टपल के भीतर प्रत्येक विशेषता का मान परमाणु होना चाहिए और सही डोमेन से लिया जाना चाहिए। डोमेन को डेटा प्रकारों के रूप में निर्दिष्ट किया जाता है, जिनमें पूर्णांक, वास्तविक संख्याएँ, वर्ण, बूलियन और परिवर्तनीय लंबाई वाली स्ट्रिंग जैसे मानक प्रकार शामिल होते हैं।
उदाहरण:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
दिखाए गए उदाहरण में एक डोमेन बाधा बनाने का तरीका दर्शाया गया है ताकि CustomerName NULL न हो।
प्रमुख बाधाएं
एक विशेषता जो किसी संबंध में टपल को विशिष्ट रूप से पहचान सकती है उसे तालिका की कुंजी कहा जाता है। संबंध में विभिन्न टपल के लिए विशेषता का मान अद्वितीय होना चाहिए।
उदाहरण:
दी गई तालिका में, CustomerID, Customer तालिका का एक प्रमुख विशेषता है। संभवतः एक ग्राहक के लिए एक ही कुंजी होगी; CustomerID = 1 केवल "गूगल" नाम के ग्राहक के लिए है। विभिन्न प्रकार की कुंजियों का विस्तृत विवरण गाइड में दिया गया है। डीबीएमएस कुंजी.
| ग्राहक आईडी | ग्राहक का नाम | स्थिति |
|---|---|---|
| 1 | गूगल | सक्रिय |
| 2 | Amazon | सक्रिय |
| 3 | Apple | निष्क्रिय |
संदर्भ Integrity की कमी
डेटाबेस मैनेजमेंट सिस्टम (DBMS) में रेफरेंशियल इंटीग्रिटी कंस्ट्रेंट फॉरेन की की अवधारणा पर आधारित होते हैं। फॉरेन की किसी रिलेशन का एक महत्वपूर्ण एट्रीब्यूट होता है जिसे अन्य रिलेशंस में संदर्भित किया जाना चाहिए। रेफरेंशियल इंटीग्रिटी कंस्ट्रेंट तब लागू होता है जब कोई रिलेशन किसी भिन्न या समान रिलेशन के की एट्रीब्यूट को संदर्भित करता है। वह की एलिमेंट संदर्भित टेबल में मौजूद होना चाहिए।
उदाहरण:

उपरोक्त उदाहरण में, हमारे पास दो संबंध हैं, ग्राहक और Billआईएनजी.
CustomerID = 1 के लिए टपल को संबंध में दो बार संदर्भित किया गया है। Billतो हमें पता है कि ग्राहक का नाम "गू" है और बिलिंग राशि $300 है।
Operaसंबंधपरक मॉडल में स्थितियाँ
रिलेशनल डेटाबेस मॉडल पर चार बुनियादी अपडेट ऑपरेशन किए जाते हैं: इंसर्ट, अपडेट, डिलीट और सेलेक्ट।
- इंसर्ट फ़ंक्शन का उपयोग रिलेशन में डेटा डालने के लिए किया जाता है।
- डिलीट का प्रयोग तालिका से ट्यूपल्स को हटाने के लिए किया जाता है।
- संशोधित करें आपको मौजूदा ट्यूपल्स में कुछ विशेषताओं के मान बदलने की अनुमति देता है।
- चयन आपको डेटा की एक विशिष्ट श्रेणी चुनने की अनुमति देता है।
जब भी इनमें से कोई भी ऑपरेशन लागू किया जाता है, तो रिलेशनल डेटाबेस स्कीमा पर निर्दिष्ट अखंडता संबंधी बाधाओं का कभी भी उल्लंघन नहीं किया जाना चाहिए।
सम्मिलित करें Operaउत्पादन
इन्सर्ट ऑपरेशन एक नए टपल के एट्रिब्यूट के मान देता है जिसे एक रिलेशन में इन्सर्ट किया जाना चाहिए।

अपडेट Operaउत्पादन
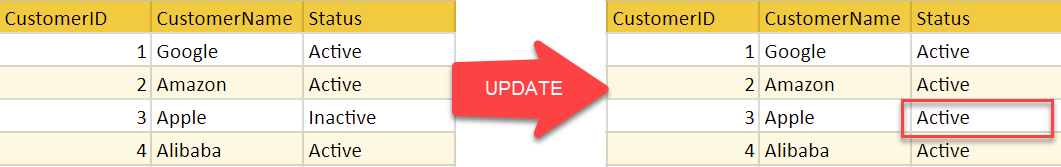
नीचे दी गई संबंध तालिका में आप देख सकते हैं कि ग्राहक का नाम 'Apple' निष्क्रिय से सक्रिय में अपडेट हो गया है।
मिटाना Operaउत्पादन
विलोपन निर्दिष्ट करने के लिए, संबंध की विशेषताओं पर एक शर्त हटाए जाने वाले टपल का चयन करती है।

उपरोक्त उदाहरण में, ग्राहक का नाम "Apple" तालिका से हटा दिया गया है।
डिलीट ऑपरेशन रेफरेंशियल इंटीग्रिटी का उल्लंघन कर सकता है यदि डिलीट किए जा रहे टपल को उसी टपल में मौजूद अन्य टपल्स की फॉरेन कीज़ द्वारा रेफरेंस किया गया हो। डेटाबेस.
चुनते हैं Operaउत्पादन

उपरोक्त उदाहरण में, ग्राहक का नाम “Amazon" चयनित है।
संबंधपरक मॉडल बनाम पदानुक्रमित और नेटवर्क मॉडल
संबंधपरक मॉडल ने दो पूर्व दृष्टिकोणों का स्थान ले लिया, और यह अंतर बताता है कि यह प्रमुख क्यों बन गया। नीचे दी गई तालिका में तीनों को साथ-साथ दिखाया गया है।
| पहलू | संबंधपरक मॉडल | पदानुक्रमिक मॉडल | नेटवर्क मॉडल |
|---|---|---|---|
| संरचना | तालिकाएँ (संबंध) | वृक्ष, जनक से संतान तक | ग्राफ, अनेक से अनेक |
| डेटा प्राप्त करना | घोषणात्मक, मूल्य द्वारा | पथ द्वारा नौवहन | पॉइंटर द्वारा नेविगेशन |
| रिश्ते | विदेशी कुंजी | माता-पिता-बच्चे के संबंध | सेट और पॉइंटर |
| पूछताछ भाषा | एसक्यूएल | प्रक्रियात्मक कोड | प्रक्रियात्मक कोड |
| लचीलापन | हाई | निम्न | मध्यम |
क्योंकि रिलेशनल मॉडल भौतिक लिंक को नेविगेट करने के बजाय मूल्य के आधार पर डेटा को संबोधित करता है, इसलिए एक उच्च-स्तरीय भाषा जैसे एसक्यूएल डेटा कैसे संग्रहीत किया जाता है, यह जाने बिना भी प्रश्न पूछा जा सकता है।
संबंधपरक मॉडल बनाने के लिए सर्वोत्तम अभ्यास
- डेटा को संबंधों के संग्रह के रूप में प्रस्तुत किया जाना चाहिए।
- तालिका में प्रत्येक संबंध को स्पष्ट रूप से दर्शाया जाना चाहिए।
- पंक्तियों में किसी इकाई के उदाहरणों के बारे में डेटा होना चाहिए।
- कॉलम में इकाई की विशेषताओं से संबंधित डेटा होना चाहिए।
- टेबल के प्रत्येक सेल में केवल एक ही मान होना चाहिए।
- प्रत्येक कॉलम को एक अद्वितीय नाम दिया जाना चाहिए।
- कोई भी दो पंक्तियाँ एक जैसी नहीं हो सकतीं।
- किसी एट्रिब्यूट के मान एक ही डोमेन से होने चाहिए।
रिलेशनल डेटाबेस मॉडल के लाभ
- सरलता: डेटाबेस मैनेजमेंट सिस्टम (DBMS) में रिलेशनल डेटा मॉडल, पदानुक्रमित और नेटवर्क मॉडल की तुलना में सरल होता है।
- संरचनात्मक स्वतंत्रता: रिलेशनल डेटाबेस का संबंध केवल डेटा से होता है, संरचना से नहीं, जिससे मॉडल के प्रदर्शन में सुधार हो सकता है।
- उपयोग करने के लिए आसान है: रिलेशनल मॉडल का उपयोग करना आसान है, क्योंकि पंक्तियों और स्तंभों से बनी तालिकाएँ स्वाभाविक और समझने में सरल होती हैं।
- क्वेरी क्षमता: यह SQL जैसी उच्च-स्तरीय क्वेरी भाषा को जटिल डेटाबेस नेविगेशन से बचने में सक्षम बनाता है।
- डेटा स्वतंत्रता: रिलेशनल डेटाबेस की संरचना को किसी भी एप्लिकेशन को बदले बिना बदला जा सकता है।
- मापनीय: रिकॉर्ड या पंक्तियों की संख्या और फ़ील्ड की संख्या के संदर्भ में, डेटाबेस को उसकी उपयोगिता बढ़ाने के लिए विस्तारित किया जा सकता है।
संबंधपरक मॉडल की कमियाँ
- कुछ रिलेशनल डेटाबेस में फ़ील्ड की लंबाई पर सीमाएं होती हैं, जिन्हें पार नहीं किया जा सकता है।
- डेटा की मात्रा बढ़ने और डेटा के विभिन्न भागों के बीच संबंध अधिक जटिल होने के कारण रिलेशनल डेटाबेस कभी-कभी जटिल हो सकते हैं।
- जटिल संबंधपरक डेटाबेस प्रणालियाँ पृथक डेटाबेस को जन्म दे सकती हैं जहाँ एक प्रणाली से दूसरी प्रणाली में जानकारी साझा नहीं की जा सकती है।
