
उदाहरण के साथ Informatica में रैंक परिवर्तन
 डेविड कार्टर
⚡ स्मार्ट सारांश
इनफॉर्मेटिका में रैंक ट्रांसफॉर्मेशन एक सक्रिय, कनेक्टेड ऑब्जेक्ट है जो प्रत्येक समूह की केवल शीर्ष या नीचे की N पंक्तियों को रखता है, और प्रत्येक शेष पंक्ति को अपने स्वचालित RANKINDEX आउटपुट पोर्ट के माध्यम से एक स्थिति प्रदान करता है।
रैंक परिवर्तन क्या है?
रैंक रूपांतरण एक सक्रिय और परस्पर जुड़ा रूपांतरण है जो समूह और रैंक के आधार पर डेटा को फ़िल्टर करता है। उदाहरण के लिए, यदि आप सबसे अधिक वेतन पाने वाले कर्मचारियों के दस रिकॉर्ड प्राप्त करना चाहते हैं, तो इस प्रकार की फ़िल्टरिंग रैंक रूपांतरण द्वारा की जा सकती है।
रैंक रूपांतरण समूहों के आधार पर रैंकिंग करने की सुविधा भी प्रदान करता है। उदाहरण के लिए, यदि आप विभागवार शीर्ष दस सबसे अधिक वेतन पाने वाले कर्मचारियों को प्राप्त करना चाहते हैं, तो वह समूहping इस रूपांतरण से यह किया जा सकता है।
रैंक रूपांतरण एक सक्रिय रूपांतरण है, क्योंकि यह आउटपुट पंक्तियों की संख्या को प्रभावित करता है।
रैंक ट्रांसफॉर्मेशन में एक आउटपुट पोर्ट होता है जिसके द्वारा यह पंक्तियों को रैंक प्रदान करता है। उस पोर्ट का नाम RANKINDEX है, और डिज़ाइनर ट्रांसफॉर्मेशन को जोड़ते ही इसे स्वचालित रूप से बना देता है। नक्शाping.
क्योंकि रैंकिंग को विजेता का निर्णय लेने से पहले समूह की प्रत्येक पंक्ति की तुलना करनी होती है, इसलिए इंटीग्रेशन सर्विस आने वाले डेटा को कैश में स्टोर करती है। समूह के मान इंडेक्स कैश में जाते हैं और शेष पंक्ति डेटा डेटा कैश में जाता है, ठीक उसी तरह जैसे कैश किया गया डेटा। जॉइनर परिवर्तन इसमें इसकी मास्टर पाइपलाइन है।
रैंक परिवर्तन में बंदरगाह
उदाहरण को समझने से पहले, यह जानना उपयोगी होगा कि पोर्ट्स टैब पर प्रत्येक पोर्ट फ्लैग वास्तव में क्या करता है, क्योंकि उनमें से दो इस रूपांतरण का वास्तविक कार्य करते हैं।
| पोर्ट प्रकार | यह क्या करता है |
|---|---|
| इनपुट (I) | अपस्ट्रीम ट्रांसफॉर्मेशन से एक कॉलम प्राप्त करता है। रैंक ट्रांसफॉर्मेशन से जुड़ा प्रत्येक कॉलम एक इनपुट पोर्ट होता है। |
| आउटपुट (O) | यह कॉलम को अगले रूपांतरण या लक्ष्य तक पहुंचाता है। |
| चर (V) | यह रूपांतरण के भीतर एक स्थानीय गणना को समाहित करता है, ठीक उसी तरह जैसे एक एक्सप्रेशन रूपांतरण में होता है। |
| रैंक (आर) | यह उस कॉलम को दर्शाता है जिसके आधार पर रैंकिंग की गणना की जाती है। रूपांतरण में केवल एक ही पोर्ट इस चिह्न को धारण कर सकता है। |
| समूह द्वारा | यह प्रत्येक विशिष्ट मान के लिए रैंकिंग को पुनः आरंभ करता है, इसलिए शीर्ष तीन फ़िल्टर कुल मिलाकर तीन पंक्तियों के बजाय प्रति समूह तीन पंक्तियाँ लौटाता है। |
| रैंकइंडेक्स | डिजाइनर द्वारा बनाया गया एक आउटपुट पोर्ट। यह अपने समूह के भीतर प्रत्येक पंक्ति की रैंकिंग स्थिति को संग्रहीत करता है और इसे बिना कनेक्ट किए भी छोड़ा जा सकता है। |
रैंकिंग केवल एक ही पोर्ट पर की जा सकती है, इसलिए "उच्चतम वेतन, फिर सबसे लंबी सेवा" जैसी आवश्यकता के लिए टाई-ब्रेकिंग मूल्य को दूसरे रैंक पोर्ट के बजाय पहले से तैयार करने की आवश्यकता होती है।
इनफॉर्मेटिका में रैंक ट्रांसफॉर्मेशन का उपयोग कैसे करें
हमारी आवश्यकता प्रत्येक विभाग के शीर्ष 3 सबसे अधिक वेतन पाने वाले कर्मचारियों को सूचीबद्ध करना है; हम इसे रैंक रूपांतरण का उपयोग करके लागू करेंगे। कृपया मानचित्र में नीचे दिए गए आठ चरणों का पालन करें।ping डिजाइनर।
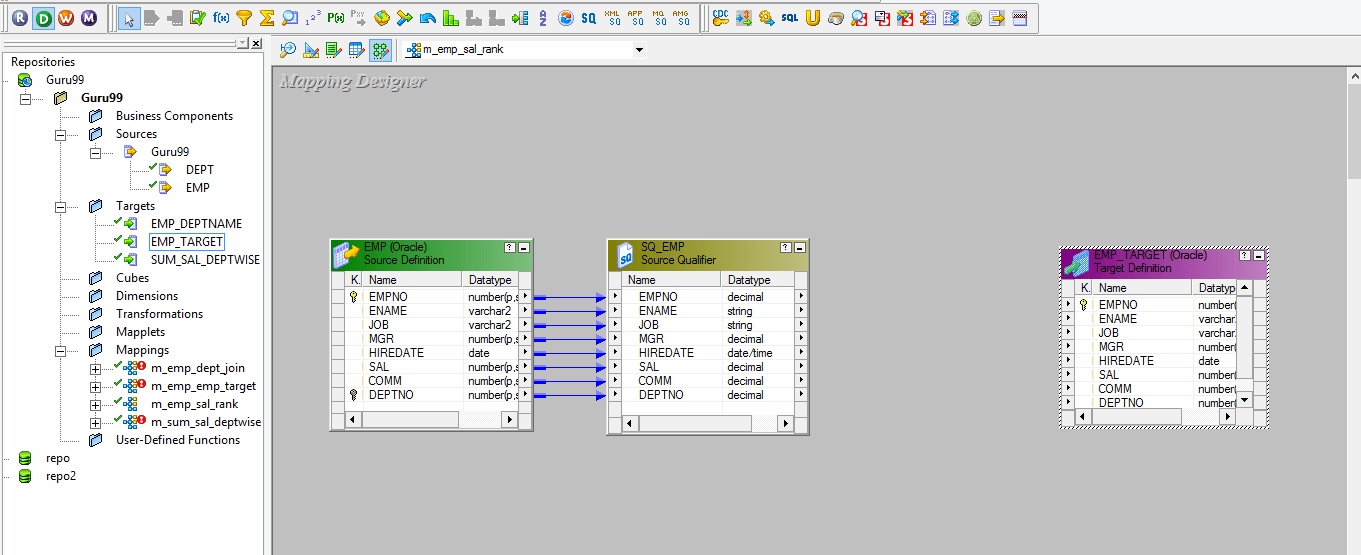
चरण 1) मानचित्र बनाएँping स्रोत EMP और लक्ष्य EMP_TARGET हैं। दोनों परिभाषाएँ अब कैनवास पर मौजूद हैं, जैसा कि नीचे दिखाया गया है।
चरण 2) फिर मानचित्र मेंping
- परिवर्तन मेनू चुनें
- बनाएँ विकल्प चुनें
इसके बाद क्रिएट विकल्प के साथ ट्रांसफॉर्मेशन मेनू दिखाया गया है।

चरण 3) परिवर्तन निर्माण विंडो में
- रैंक परिवर्तन चुनें
- परिवर्तन नाम “rnk_salary” दर्ज करें
- बनाएँ बटन चुनें

चरण 4) मानचित्र में रैंक परिवर्तन बनाया जाएगाpingविंडो में मौजूद 'हो गया' बटन को चुनें। अब कैनवास पर खाली rnk_salary ऑब्जेक्ट दिखाई देगा।

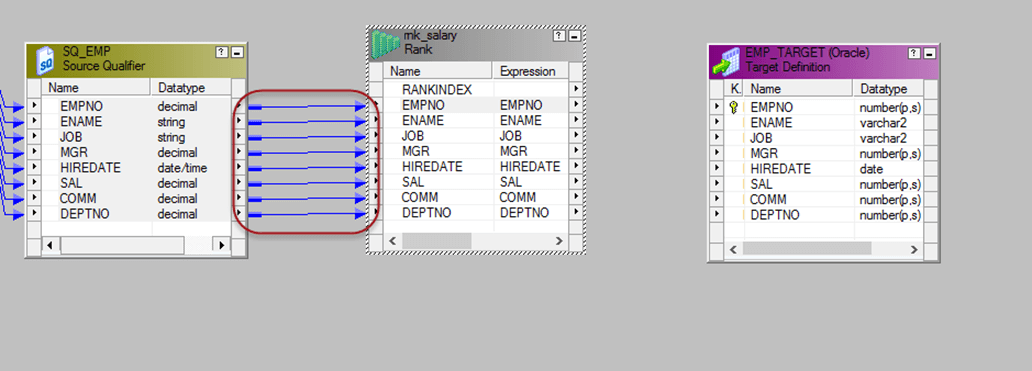
चरण 5) सभी पोर्ट्स को कनेक्ट करें स्रोत क्वालिफायर रैंक रूपांतरण के लिए, ताकि प्रत्येक कर्मचारी कॉलम रैंकिंग के लिए उपलब्ध हो।
चरण 6) Double रैंक ट्रांसफॉर्मेशन पर क्लिक करें, इससे "ट्रांसफॉर्मेशन संपादित करें" विंडो खुल जाएगी। इस विंडो में
- गुण मेनू चुनें
- शीर्ष/नीचे प्रॉपर्टी से “शीर्ष” विकल्प चुनें
- रैंक की संख्या में 3 दर्ज करें
अब प्रॉपर्टीज़ टैब में तीन रैंक के साथ 'टॉप' लिखा हुआ है, जैसा कि स्क्रीनशॉट में दिखाया गया है।

चरण 7) “परिवर्तन संपादित करें” विंडो में पुनः
- पोर्ट टैब चुनें
- विभाग संख्या कॉलम के लिए विकल्प द्वारा समूह का चयन करें
- वेतन कॉलम में रैंक चुनें
- ओके बटन का चयन करें
पोर्ट्स टैब में अब विभाग संख्या पर समूह ध्वज और वेतन पर R ध्वज प्रदर्शित होता है।

चरण 8) रैंक रूपांतरण से लक्ष्य तालिका तक पोर्ट कनेक्ट करें। मानचित्रping अब यह EMP से rnk_salary के माध्यम से EMP_TARGET में जाता है।

अब, मानचित्र को सहेजें।ping और इसे बनाने के बाद निष्पादित करें सत्र और वर्कफ़्लोसोर्स क्वालिफायर सभी रिकॉर्ड प्राप्त करेगा, लेकिन रैंक ट्रांसफॉर्मेशन प्रत्येक विभाग के लिए केवल तीन उच्चतम वेतन वाले रिकॉर्ड ही पास करेगा।
रैंक रूपांतरण गुण
चरण 6 में उपयोग किए गए प्रॉपर्टीज़ टैब में उदाहरण में किए गए दो बदलावों से कहीं अधिक सेटिंग्स होती हैं। नीचे दी गई सेटिंग्स यह नियंत्रित करती हैं कि कितनी पंक्तियाँ सुरक्षित रहेंगी, स्ट्रिंग्स की तुलना कैसे की जाएगी और कैश फ़ाइलें कहाँ लिखी जाएंगी।
| संपत्ति | यह क्या नियंत्रित करता है? |
|---|---|
| ऊपर से नीचे | रैंक किए गए कॉलम के लिए उच्चतम या निम्नतम मान रखे जाते हैं या नहीं। उदाहरण में 'शीर्ष' का उपयोग किया गया है। |
| रैंकों की संख्या | प्रति समूह कितनी पंक्तियाँ लौटाई जाती हैं? उदाहरण में 3 का उपयोग किया गया है, इसलिए प्रत्येक विभाग तीन कर्मचारियों को लौटाता है। |
| केस-संवेदनशील स्ट्रिंग तुलना | क्या रैंकिंग करते समय स्ट्रिंग तुलनाओं में अक्षर के केस का ध्यान रखा जाता है? यह केवल तभी मायने रखता है जब रैंक पोर्ट में टेक्स्ट हो। |
| कैश निर्देशिका | वह निर्देशिका जिसमें इंडेक्स और डेटा कैश फाइलें बनाई जाती हैं। डिफ़ॉल्ट मान $PMCacheDir प्रोसेस वेरिएबल है। |
| रैंक डेटा कैश आकार | पंक्ति डेटा को रखने वाले डेटा कैश का आकार। डिफ़ॉल्ट मान ऑटो है, जिससे इंटीग्रेशन सर्विस इसे निर्धारित कर सकती है। |
| रैंक इंडेक्स कैश आकार | समूह मानों को रखने वाले इंडेक्स कैश का आकार। डिफ़ॉल्ट मान ऑटो है। |
| परिवर्तन का दायरा | यह रैंकिंग प्रत्येक लेनदेन या सभी आने वाले डेटा पर लागू होती है। |
| Tracइंग स्तर | सेशन लॉग में लिखी जाने वाली जानकारी की मात्रा: संक्षिप्त, सामान्य, विस्तृत आरंभीकरण या विस्तृत डेटा। |
बड़े स्रोतों पर कैश साइजिंग सेटिंग पर दोबारा विचार करना ज़रूरी है। जब कैश बहुत छोटा होता है, तो इंटीग्रेशन सर्विस डिस्क पर पेजिंग करती है, जो कि सबसे पहले जाँची जाने वाली चीज़ों में से एक है। प्रदर्शन सुधारना मानचित्र काping.
रैंक रूपांतरण बनाम एग्रीगेटर रूपांतरण
दोनों रूपांतरण सक्रिय हैं, दोनों अपने इनपुट को कैश करते हैं और दोनों ग्रुप बाय पोर्ट प्रदान करते हैं, इसलिए गलत रूपांतरण का चयन करना आसान है। अंतर केवल उनसे प्राप्त होने वाले परिणाम में है।
| तुलना का बिंदु | रैंक परिवर्तन | एग्रीगेटर रूपांतरण |
|---|---|---|
| उद्देश्य | यह प्रत्येक समूह की शीर्ष या नीचे की N पूर्ण पंक्तियों को लौटाता है। | यह योग जैसे परिकलित मान लौटाता है। AVGप्रति समूह अधिकतम या न्यूनतम |
| पंक्तियाँ वापस आ गईं | प्रत्येक समूह में रैंकों की संख्या तक, उनके सभी स्तंभों को बरकरार रखते हुए। | सामान्यतः प्रति समूह एक सारांश पंक्ति |
| अतिरिक्त पोर्ट जोड़ा गया | RANKINDEX, जो प्रत्येक पंक्ति की स्थिति को दर्शाता है | कोई नहीं |
| रैंक किया गया या एकत्रित स्तंभ | एक बंदरगाह को रैंक पोर्ट के रूप में चिह्नित किया गया है | एग्रीगेट एक्सप्रेशन ले जाने वाले किसी भी संख्या के पोर्ट |
सीधे शब्दों में कहें तो, ए एग्रीगेटर रूपांतरण यह प्रश्न पूछता है कि "इस विभाग में सबसे अधिक वेतन कितना है", जबकि रैंक रूपांतरण यह उत्तर देता है कि "कौन से कर्मचारी इसे कमाते हैं"। जब केवल पंक्तियों के एक उपसमूह को एक सरल शर्त पर हटाया जाना होता है और कोई क्रम शामिल नहीं होता है, तो एक फ़िल्टर रूपांतरण यह सस्ता विकल्प है, क्योंकि इसमें किसी भी प्रकार की कैशिंग की आवश्यकता नहीं होती है।
