
R में मैट्रिक्स फ़ंक्शन: कॉलम और स्लाइस बनाएँ, प्रिंट करें, जोड़ें
 एवलिन क्लार्क
⚡ स्मार्ट सारांश
R में मैट्रिक्स एक द्वि-आयामी सरणी है जो m पंक्तियों और n स्तंभों में एक ही प्रकार का डेटा रखती है, जिसे matrix() फ़ंक्शन से बनाया जाता है, cbind() और rbind() से विस्तारित किया जाता है, और वर्ग कोष्ठक के माध्यम से पहुँचा जा सकता है।
आर में मैट्रिक्स फ़ंक्शन
R में मैट्रिक्स फ़ंक्शन एक 2-आयामी सरणी है जिसमें m संख्या में पंक्तियाँ और n संख्या में कॉलम होते हैं। दूसरे शब्दों में, R प्रोग्रामिंग में मैट्रिक्स एक ही डेटा प्रकार वाले दो या अधिक वैक्टर का संयोजन है।
असल में, मैट्रिक्स एक वेक्टर होता है जिसमें दो लंबाई का एक dim एट्रीब्यूट होता है। यही कारण है कि प्रत्येक तत्व का एक ही प्रकार होना आवश्यक है: जैसे ही कोई कैरेक्टर मान संख्याओं से जुड़ता है, पूरा मैट्रिक्स कैरेक्टर में बदल जाता है। R मानों को एक ही कॉलम-वार क्रम में संग्रहीत करता है और प्रत्येक पंक्ति के अंत का निर्धारण करने के लिए dim का उपयोग करता है, इसलिए चयन डाटा प्रकार यह एक ही बार में पूरी वस्तु पर लागू होता है।
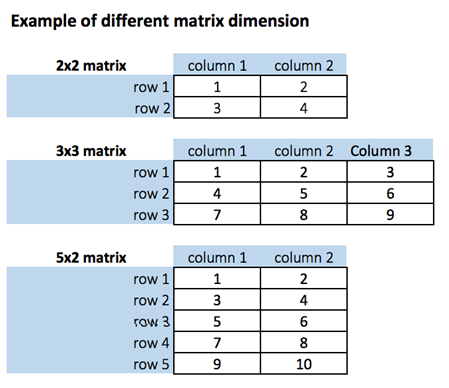
नोट: matrix() फ़ंक्शन हमेशा दो आयाम लौटाता है। R में तीन या अधिक आयामों वाली संरचना बनाने के लिए, dim वेक्टर के साथ array() फ़ंक्शन का उपयोग करें, या सीधे dim() फ़ंक्शन को असाइन करें। नीचे दिया गया आरेख प्रत्येक मैट्रिक्स द्वारा अपनाए जाने वाले पंक्ति और स्तंभ लेआउट को दर्शाता है।
आर में मैट्रिक्स कैसे बनाएं
हम फ़ंक्शन का उपयोग करके एक मैट्रिक्स बना सकते हैं। आव्यूह()मूल R सिग्नेचर पाँच आर्गुमेंट लेता है, और यहाँ सबसे अधिक उपयोग किए जाने वाले तीन आर्गुमेंट दिखाए गए हैं:
matrix(data, nrow, ncol, byrow = FALSE)
तर्क:
- तिथि: वे तत्व जिन्हें R मैट्रिक्स की पंक्तियों और स्तंभों में व्यवस्थित करेगा।
- nrowपंक्तियों की संख्या।
- एनकोलो: स्तंभों की संख्या।
- बायरो: एक तार्किक चिह्न। डिफ़ॉल्ट रूप से byrow = FALSE होने पर मैट्रिक्स को कॉलम दर कॉलम, ऊपर से नीचे तक भरा जाता है। byrow = TRUE होने पर इसे पंक्ति दर पंक्ति, बाएं से दाएं तक भरा जाता है।
- आयामी नाम: दो पंक्तियों के नाम और स्तंभों के नाम प्रदान करने वाली एक वैकल्पिक सूची।
पहले उदाहरण से पहले, R के मूल संदर्भ से दो बातें जानना ज़रूरी हैं। यदि nrow और ncol में से केवल एक ही दिया गया हो, तो R डेटा की लंबाई से दूसरे का अनुमान लगा लेता है। और यदि डेटा में आपके द्वारा मांगे गए आकार को भरने के लिए पर्याप्त तत्व नहीं हैं, तो मानों को अस्वीकार करने के बजाय पुनः उपयोग किया जाता है।
आइए, 1 से 10 तक की संख्याओं के अनुक्रम से दो 5×2 मैट्रिक्स बनाएं, एक में byrow = TRUE और दूसरे में byrow = FALSE हो, ताकि अंतर देखा जा सके।
# Construct a matrix with 5 rows that contain the numbers 1 up to 10 and byrow =  TRUE
matrix_a <-matrix(1:10, byrow = TRUE, nrow = 5)
matrix_a
आउटपुट:
क्योंकि byrow = TRUE का उपयोग किया गया था, इसलिए कंसोल पहली पंक्ति को 1 और 2 से, दूसरी पंक्ति को 3 और 4 से, और इसी तरह आगे भरता है।
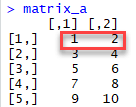
dim() फ़ंक्शन का उपयोग करके matrix_a का आयाम प्रिंट करें।
अब, dim() के साथ R में मैट्रिक्स का आयाम प्रिंट करते हैं। dim() का उपयोग करके R में मैट्रिक्स प्रिंट करने का सिंटैक्स है:
# Print dimension of the matrix with dim()
dim(matrix_a)
आउटपुट:
## [1] 5 2
dim() फ़ंक्शन पहले पंक्तियों की संख्या और फिर स्तंभों की संख्या लौटाता है, जिससे 5×2 आकार की पुष्टि होती है।
कॉलम द्वारा मैट्रिक्स भरें, जहां पंक्ति = FALSE हो।
वही दस संख्याएँ और वही पंक्ति, भरने की दिशा बदलने पर एक अलग व्यवस्था उत्पन्न करती हैं।ping बायरो डिफ़ॉल्ट रूप से दूसरे कॉलम के शुरू होने से पहले पहले कॉलम में मान भेजता है।
# Construct a matrix with 5 rows that contain the numbers 1 up to 10 and byrow =  FALSE
matrix_b <-matrix(1:10, byrow = FALSE, nrow = 5)
matrix_b
आउटपुट:
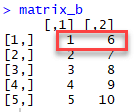
dim() फ़ंक्शन का उपयोग करके matrix_b का आयाम प्रिंट करें।
फिर से, dim() का उपयोग करके मैट्रिक्स के आयाम को प्रिंट करें। नीचे R प्रिंट मैट्रिक्स आयाम का सिंटैक्स दिया गया है:
# Print dimension of the matrix with dim()
dim(matrix_b)
आउटपुट:
## [1] 5 2
5×2 पर आकार अपरिवर्तित रहता है, क्योंकि बायरो भरने के क्रम को बदलता है, आयामों को कभी नहीं।
नोट: कमांड matrix_b <-matrix(1:10, byrow = FALSE, ncol = 2) का उपयोग करने से ऊपर जैसा ही प्रभाव पड़ेगा, क्योंकि R दिए गए दस मानों से nrow = 5 का अनुमान लगाता है।
आप ncol का उपयोग करके 4×3 मैट्रिक्स भी बना सकते हैं। R तीन कॉलम बनाएगा और प्रत्येक कॉलम को ऊपर से नीचे तक भरेगा। एक उदाहरण देखें।
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
matrix_c
आउटपुट:
##       [,1] [,2] [,3]
## [1,]    1    5    9
## [2,]    2    6   10
## [3,]    3    7   11
## [4,]    4    8   12
कॉलम हेडर [,1] से [,3] और पंक्ति लेबल [1,] से [4,] R के डिफ़ॉल्ट प्लेसहोल्डर हैं। जैसे ही वास्तविक आयाम नाम दिए जाते हैं, ये गायब हो जाते हैं, जैसा कि इस ट्यूटोरियल में आगे दिखाया गया है।
उदाहरण:
dim(matrix_c)
आउटपुट:
## [1] 4 3
cbind() के साथ मैट्रिक्स में एक कॉलम जोड़ें
आप cbind() कमांड का उपयोग करके मैट्रिक्स R में कॉलम जोड़ सकते हैं। cbind() का अर्थ है कॉलम बाइंडिंग, और यह निर्दिष्ट संख्या में मैट्रिक्स या कॉलम को जोड़ सकता है। उदाहरण के लिए, हमारे पिछले उदाहरण ने 5×2 का मैट्रिक्स बनाया था। हमने इसमें तीसरा कॉलम जोड़ा और यह सत्यापित किया कि इसका आयाम 5×3 है।
उदाहरण:
# concatenate c(1:5) to the matrix_a
matrix_a1 <- cbind(matrix_a, c(1:5))
# Check the dimension
dim(matrix_a1)
आउटपुट:
## [1] 5 3
उदाहरण:
matrix_a1
उत्पादन
##       [,1] [,2] [,3]
## [1,]    1    2    1
## [2,]    3    4    2
## [3,]    5    6    3
## [4,]    7    8    4
## [5,]    9   10    5
उदाहरण:
हम एक साथ एक से अधिक कॉलम को भी जोड़ सकते हैं। अगला ब्लॉक matrix_a2 बनाता है, जो 13 से 24 तक की संख्याओं को रखने वाला 4×3 मैट्रिक्स है, ताकि इसे 4×3 मैट्रिक्स_c के साथ जोड़ा जा सके और 1 से 24 तक की संख्याओं को कवर करने वाला 4×6 परिणाम प्राप्त हो सके।
matrix_a2 <-matrix(13:24, byrow = FALSE, ncol = 3)
आउटपुट:
##      [,1] [,2] [,3]
## [1,]   13   17   21
## [2,]   14   18   22
## [3,]   15   19   23
## [4,]   16   20   24
उदाहरण:
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
matrix_d <- cbind(matrix_a2, matrix_c)
dim(matrix_d)
आउटपुट:
## [1] 4 6
ध्यान देंR में मैट्रिक्स की पंक्तियों की संख्या बराबर होनी चाहिए तभी cbind() काम करेगा। यदि पंक्तियों की संख्या भिन्न होती है, तो R या तो कम पंक्तियों वाली मैट्रिक्स का उपयोग करता है या त्रुटि उत्पन्न करता है, इसलिए पहले दोनों ऑब्जेक्ट पर dim() की जाँच करना अधिक सुरक्षित है।
जहां cbind() कॉलम को जोड़ता है, वहीं rbind() पंक्तियों को जोड़ता है। आइए अपनी matrix_c मैट्रिक्स में एक पंक्ति जोड़कर यह सत्यापित करें कि इसका आयाम 5×3 है।
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
# Create a vector of 3 columns
add_row <- c(1:3)
# Append to the matrix
matrix_c <- rbind(matrix_c, add_row)
# Check the dimension
dim(matrix_c)
आउटपुट:
## [1] 5 3
ध्यान दें कि add_row जैसे नाम वाले वेक्टर को बाइंड करने से नई पंक्ति को भी वही नाम मिल जाता है, जो आगे बताए गए लेबल वाली मैट्रिक्स की ओर पहला कदम है।
मैट्रिक्स को स्लाइस करें
हम एक मैट्रिक्स से एक या अनेक तत्वों का चयन कर सकते हैं। आर प्रोग्रामिंग वर्गाकार कोष्ठकों [ ] का उपयोग करके। कोष्ठकों के अंदर, पहले पंक्ति चयनकर्ता और फिर स्तंभ चयनकर्ता आता है, जो अल्पविराम से अलग होते हैं। यहीं पर स्लाइसिंग का महत्व सामने आता है।
उदाहरण के लिए:
- मैट्रिक्स_सी[1,2] पहली पंक्ति और दूसरे कॉलम में तत्व का चयन करता है।
- matrix_c[1:3,2:3] के परिणामस्वरूप एक R स्लाइस मैट्रिक्स प्राप्त होता है जिसमें डेटा पंक्तियों 1, 2, 3 और स्तंभ 2 और 3 पर होता है।
- मैट्रिक्स_सी[,1] पहले कॉलम के सभी तत्वों का चयन करता है।
- मैट्रिक्स_सी[1,] पहली पंक्ति के सभी तत्वों का चयन करता है।
अल्पविराम के एक तरफ को खाली छोड़ने का मतलब है उस तरफ के सभी मानों का चयन करना। इसका एक परिणाम शुरुआती लोगों को भ्रमित कर सकता है: जब एक पंक्ति या स्तंभ का चयन किया जाता है, तो R खाली आयाम को हटा देता है और एक साधारण वेक्टर लौटा देता है। drop = FALSE जोड़ने से, जैसे matrix_c[1, , drop = FALSE], परिणाम एक मैट्रिक्स ही रहता है।
उपरोक्त कोड के लिए आपको जो आउटपुट मिलेगा वह इस प्रकार है
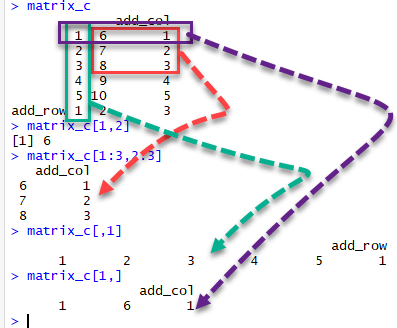
R में मैट्रिक्स की पंक्तियों और स्तंभों के नाम बताइए।
मैट्रिक्स का वास्तविक अर्थ सामने आते ही [,1] और [3,] जैसे डिफ़ॉल्ट लेबल आउटपुट को पढ़ना मुश्किल बना देते हैं। dimnames आर्गुमेंट और rownames() और colnames() रिप्लेसमेंट फ़ंक्शन टेक्स्ट लेबल जोड़ते हैं जो cbind(), t() और हर स्लाइसिंग ऑपरेशन के दौरान मैट्रिक्स के साथ चलते हैं।
# Name the rows and columns while the matrix is built
sales <- matrix(1:6, nrow = 2, ncol = 3,
                dimnames = list(c('north', 'south'), c('q1', 'q2', 'q3')))

# Or attach the names afterwards
rownames(sales) <- c('north', 'south')
colnames(sales) <- c('q1', 'q2', 'q3')

# Read the names back as a list of two character vectors
dimnames(sales)

# Names make label based slicing possible
sales['north', 'q2']
| समारोह | पुस्तकें | सेट |
|---|---|---|
| dimnames(m) | दोनों आयामों को दो सदिशों की सूची के रूप में दर्शाया गया है। | dimnames(m) <- list(rows, cols) |
| पंक्ति नाम(एम) | पंक्ति लेबल | rownames(m) <- rows |
| कॉलनाम(एम) | स्तंभ लेबल | colnames(m) <- cols |
| मंद(एम) | पंक्तियों और स्तंभों को दो पूर्णांकों के रूप में दर्शाया गया है। | dim(m) <- c(nrow, ncol) |
एक बार लेबल मौजूद हो जाने पर, sales['north', 'q2'] sales[1, 2] की तुलना में कहीं अधिक स्पष्ट होता है और पंक्तियों के पुनर्व्यवस्थापन के बाद भी बना रहता है। dimnames घटक को NULL पर सेट करने से लेबलों का वह सेट फिर से हट जाता है, और as.data.frame() के साथ परिवर्तित मैट्रिक्स अपनी पंक्ति और स्तंभ नामों को सीधे स्थानांतरित कर देता है। डेटा ढांचा.
मैट्रिक्स OperaR में क्रियाएँ: अंकगणित, स्थानान्तरण और गुणन
मैट्रिक्स पर अंकगणित में सिंगल-टाइप नियम का लाभ मिलता है। बेस R बिना किसी अतिरिक्त पैकेज के पूरे सेट को संभाल लेता है, लेकिन दो ऑपरेटरों को लेकर भ्रम हो सकता है: * तत्व-दर-तत्व गुणा करता है, जबकि %*% वास्तविक मैट्रिक्स गुणन करता है और इसके लिए आवश्यक है कि बाएँ ऑपरेंड के कॉलम दाएँ ऑपरेंड की पंक्तियों से मेल खाते हों।
m1 <- matrix(1:4, nrow = 2)
m2 <- matrix(5:8, nrow = 2)

m1 + m2          # element by element addition
m1 * m2          # element by element product, NOT matrix multiplication
m1 %*% m2        # true matrix multiplication
t(m1)            # transpose: rows become columns
solve(m1)        # inverse, for a square matrix that is not singular

rowSums(m1)      # one total per row
colMeans(m1)     # one mean per column
apply(m1, 1, max)   # any function, applied row by row
- टी(एम): मैट्रिक्स को ट्रांसपोज़ करता है, जिससे तत्व [i, j] बदलकर [j, i] हो जाता है। आयामों के नाम बरकरार रहते हैं।
- हल करें(एम): यह एक वर्ग, गैर-विलक्षण मैट्रिक्स का व्युत्क्रम लौटाता है, और solve(a, b) एक रैखिक प्रणाली को हल करता है।
- पंक्ति योग / स्तंभ योग / पंक्ति माध्य / स्तंभ माध्य: इसे sum या mean के साथ apply() के समकक्ष प्रलेखित किया गया है, लेकिन यह काफी तेज है।
- लागू करें(एम, मार्जिन, फन): MARGIN = 1 पंक्तियों को और MARGIN = 2 स्तंभों को प्रभावित करता है, चाहे आप कोई भी फ़ंक्शन प्रदान करें।
- निदान, निर्धारण, क्रॉसप्रोडक्शन: t(x) %*% y का विकर्ण, निर्धारक और तेज़ रूप।
क्योंकि ये ऑपरेशन वेक्टर रूप में हैं, इसलिए ये लूप के अंदर होने के बजाय उन्हें प्रतिस्थापित करते हैं। एक सारांश जो हजारों सेल्स पर नेस्टेड फॉर लूप लेता, वह अब एक सिंगल colMeans() कॉल में बदल जाता है, जो डेटा बढ़ने पर महत्वपूर्ण हो जाता है।
R में मैट्रिक्स, डेटा फ्रेम और ऐरे का उपयोग
कंसोल में मैट्रिक्स, डेटा फ्रेम और एरे सभी आयताकार दिखाई देते हैं, फिर भी वे अलग-अलग प्रश्नों के उत्तर देते हैं। यह तालिका उन्हें साथ-साथ दर्शाती है।
| संपत्ति | मैट्रिक्स | डेटा फ़्रेम | ऐरे |
|---|---|---|---|
| आयाम | वास्तव में २ | वास्तव में २ | कोई संख्या |
| कॉलम प्रकार | पूरी वस्तु के लिए एक ही प्रकार | प्रत्येक कॉलम के लिए एक अलग प्रकार | पूरी वस्तु के लिए एक ही प्रकार |
| के साथ बनाया गया | आव्यूह() | डेटा.फ्रेम() | सरणी () |
| विशिष्ट उपयोग | संख्यात्मक गणना और रैखिक बीजगणित | मिश्रित अवलोकन डेटा | स्टैक्ड टेबल, जैसे कि वर्षवार गणना। |
| पंक्ति लेबल | वैकल्पिक आयाम नाम | पंक्ति के नाम हमेशा मौजूद होते हैं | वैकल्पिक आयाम नाम |
# A matrix holds one type only, so mixing coerces everything to character
mixed <- matrix(c(1, 2, 'a', 'b'), nrow = 2)
class(mixed[1, 1])

# Convert between the structures
as.data.frame(matrix_c)
as.matrix(mtcars)

# A matrix is the two dimensional case of an array
is.matrix(matrix_c)
inherits(matrix_c, 'array')
जब प्रत्येक सेल में एक ही प्रकार की संख्या हो और काम अंकगणितीय हो, तो मैट्रिक्स का उपयोग करें। डेटा ढांचा जब कॉलम अलग-अलग प्रकार के डेटा रखते हैं, उदाहरण के लिए एक अक्षर का नाम, एक संख्यात्मक मूल्य के बगल में और एक कारकएक के लिए पहुँचें सूची जब भागों की लंबाई अलग-अलग होती है, और किसी ऐरे के लिए जब समय या क्षेत्र जैसे तीसरा इंडेक्स वास्तव में मौजूद होता है। as.matrix() और as.data.frame() का उपयोग करके दोनों दिशाओं में रूपांतरण सस्ता है, इसलिए संरचना कार्य का अनुसरण कर सकती है, न कि इसके विपरीत।
