
Python XML फ़ाइल – कैसे पढ़ें, लिखें और पार्स करें
 अन्ना ब्लेक
⚡ स्मार्ट सारांश
Python XML प्रोसेसिंग आपको बिल्ट-इन minidom और ElementTree मॉड्यूल का उपयोग करके XML दस्तावेज़ों को पढ़ने, लिखने और पार्स करने की सुविधा देता है। minidom क्लास एक फ़ाइल को DOM के रूप में मेमोरी में लोड करता है, जबकि ElementTree एक तेज़ और अधिक कुशल प्रक्रिया प्रदान करता है। Pythonआईसी ट्री एपीआई।
नीचे दिए गए अनुभाग XML फ़ाइलों को पार्स करने, लिखने और पढ़ने के बारे में जानकारी देते हैं। Python.
एक्सएमएल क्या है?
XML का मतलब है एक्सटेंसिबल मार्कअप लैंग्वेज। इसे छोटे से मध्यम मात्रा में डेटा को स्टोर और ट्रांसपोर्ट करने के लिए डिज़ाइन किया गया था और इसका व्यापक रूप से संरचित जानकारी साझा करने के लिए उपयोग किया जाता है।
Python यह आपको XML दस्तावेज़ों को पार्स और संशोधित करने में सक्षम बनाता है। किसी XML दस्तावेज़ को पार्स करने के लिए, आपको संपूर्ण XML दस्तावेज़ को मेमोरी में रखना होगा। इस ट्यूटोरियल में, हम देखेंगे कि हम XML minidom क्लास का उपयोग कैसे कर सकते हैं। Python XML फ़ाइलों को लोड और पार्स करने के लिए.
मिनीडोम का उपयोग करके XML को पार्स कैसे करें
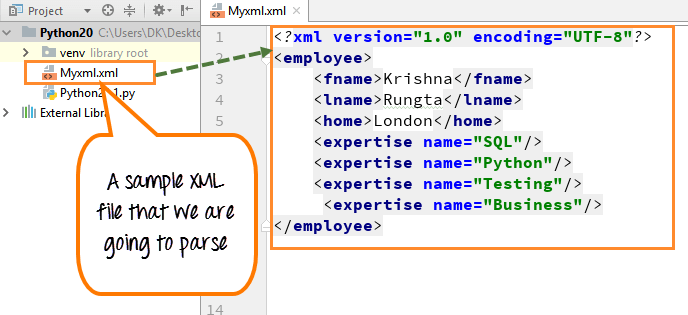
हमने एक नमूना XML फ़ाइल बनाई है जिसे हम पार्स करने जा रहे हैं।
चरण 1) नमूना XML फ़ाइल बनाएँ
फ़ाइल के अंदर, हम पहला नाम, अंतिम नाम, घर और विशेषज्ञता का क्षेत्र (SQL, Python(परीक्षण और व्यवसाय)।
चरण 2) XML फ़ाइल को लोड और पार्स करने के लिए पार्स फ़ंक्शन का उपयोग करें
दस्तावेज़ को पार्स करने के बाद, हम दस्तावेज़ के रूट का "नोड नाम" और "फर्स्टचाइल्ड टैगनाम" प्रिंट करेंगे। टैगनाम और नोडनाम XML फ़ाइल की मानक प्रॉपर्टीज़ हैं।
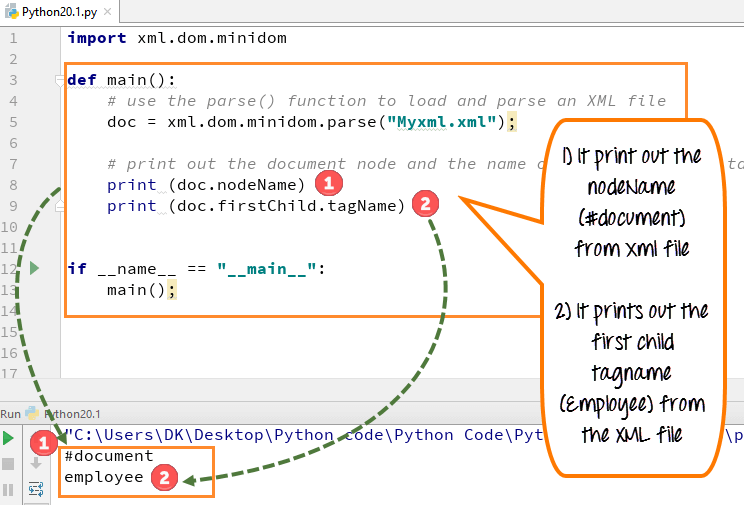
- xml.dom.minidom मॉड्यूल को आयात करें और उस फ़ाइल को घोषित करें जिसे पार्स किया जाना है (myxml.xml)।
- इस फ़ाइल में कर्मचारी के बारे में कुछ बुनियादी जानकारी होती है जैसे पहला नाम, अंतिम नाम, घर, विशेषज्ञता आदि।
- हम XML फ़ाइल को लोड करने और पार्स करने के लिए XML मिनीडोम पर पार्स फ़ंक्शन का उपयोग करते हैं
- हमारे पास एक वेरिएबल doc है, और doc को parse फ़ंक्शन का परिणाम मिलता है।
- हम फ़ाइल से नोडनाम और चाइल्ड टैगनाम प्रिंट करना चाहते हैं, इसलिए हम इसे प्रिंट फ़ंक्शन में घोषित करते हैं।
- कोड चलाएँ- यह XML फ़ाइल से नोडनाम (#document) और XML फ़ाइल से प्रथम चाइल्ड टैगनाम (कर्मचारी) प्रिंट करता है
नोटनोडनाम और चाइल्ड टैगनाम XML DOM के मानक नाम या गुण हैं।
चरण 3) XML दस्तावेज़ से XML टैग की सूची को कॉल करें और उसे प्रिंट करें।
इसके बाद, हम XML दस्तावेज़ से XML टैग की सूची भी निकाल सकते हैं और उसे प्रिंट कर सकते हैं। यहाँ हमने SQL जैसे कौशलों का सेट प्रिंट किया है। Python, परीक्षण और व्यापार.

- विशेषज्ञता नामक चर घोषित करें, जिससे हम निष्कर्ष निकालेंगे।tracकर्मचारी के पास मौजूद सभी विशेषज्ञता के नाम।
- “getElementsByTagName” नामक डोम मानक फ़ंक्शन का उपयोग करें
- इससे कौशल नाम के सभी तत्व प्राप्त हो जाएंगे
- प्रत्येक कौशल टैग पर एक लूप घोषित करें
- कोड चलाएँ - यह चार कौशलों की सूची देगा।
XML नोड कैसे लिखें
हम “createElement” फ़ंक्शन का उपयोग करके एक नई विशेषता बना सकते हैं और फिर इस नई विशेषता या टैग को मौजूदा XML टैग में जोड़ सकते हैं। हमने अपनी XML फ़ाइल में एक नया टैग “BigData” जोड़ा है।
- आपको मौजूदा XML टैग में नया एट्रिब्यूट (BigData) जोड़ने के लिए कोड लिखना होगा।
- फिर, आपको मौजूदा XML टैग में नया एट्रिब्यूट जोड़कर XML टैग को प्रिंट करना होगा।
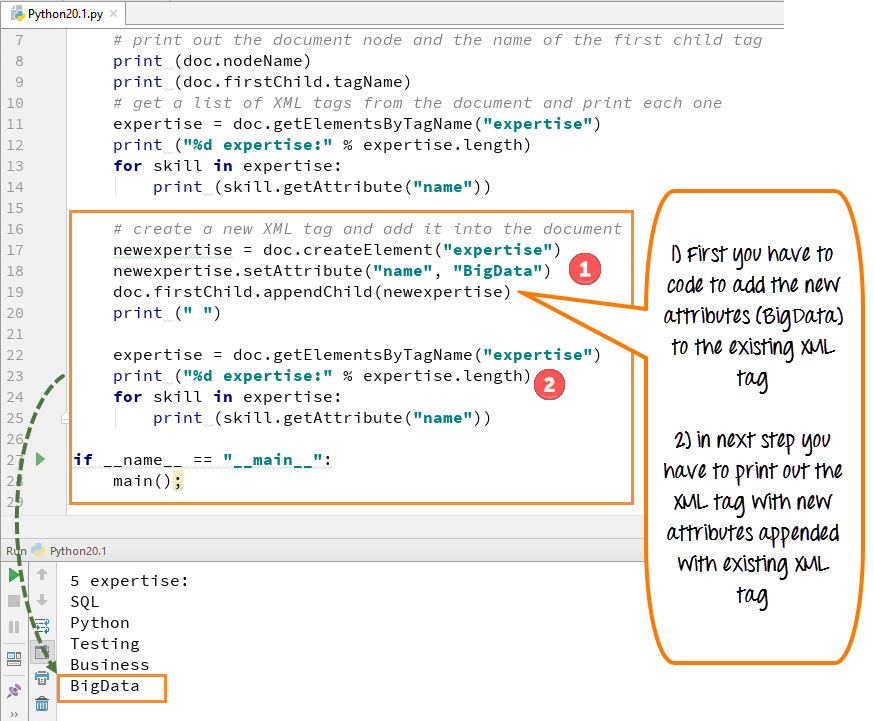
- किसी नए XML टैग को जोड़ने और उसे दस्तावेज़ में शामिल करने के लिए, हम "doc.createElement" कोड का उपयोग करते हैं।
- यह कोड हमारे नए एट्रीब्यूट "बिग डेटा" के लिए एक नया स्किल टैग बनाएगा।
- इस स्किल टैग को डॉक्यूमेंट के पहले चाइल्ड (कर्मचारी) में जोड़ें।
- कोड चलाएँ - "बिग डेटा" नाम का नया टैग विशेषज्ञता की अन्य सूची के साथ दिखाई देगा।
XML पार्सर उदाहरण
Python 2 उदाहरण
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 उदाहरण
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
एलिमेंटट्री का उपयोग करके XML को पार्स कैसे करें
ElementTree XML को प्रोसेस करने के लिए एक API है। ElementTree XML फ़ाइलों को प्रोसेस करने का एक आसान तरीका है।
हम नमूना डेटा के रूप में निम्नलिखित XML दस्तावेज़ का उपयोग कर रहे हैं:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
ElementTree का उपयोग करके XML पढ़ना:
हमें सबसे पहले xml.etree.ElementTree मॉड्यूल को इम्पोर्ट करना होगा।
import xml.etree.ElementTree as ET
अब आइए मूल तत्व को प्राप्त करें:
root = tree.getroot()
उपरोक्त XML डेटा को पढ़ने के लिए संपूर्ण कोड निम्नलिखित है:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
आउटपुट:
Expertise Data:
SQL
Python
