
हाडोप पिग ट्यूटोरियल: अपाचे पिग क्या है? Archiटेकचर, उदाहरण
 प्रफुल्ल रणदिवे
⚡ स्मार्ट सारांश
Apache Pig, Hadoop पर बड़े डेटा सेट का विश्लेषण करने के लिए एक उच्च-स्तरीय प्लेटफ़ॉर्म है, जो Pig Latin डेटा-फ़्लो भाषा को एक रनटाइम के साथ जोड़ता है जो प्रत्येक स्क्रिप्ट को MapReduce, Tez या अन्य प्रारूपों में संकलित करता है। Spark नौकरियां स्वचालित रूप से।
यह ट्यूटोरियल अपाचे पिग के पीछे के विचार से शुरू होता है, फिर इसे स्थापित करने और एक संपूर्ण पिग लैटिन स्क्रिप्ट को शुरू से अंत तक चलाने की प्रक्रिया को विस्तार से बताता है।
अपाचे पिग क्या है?
सुअर एक उच्च स्तरीय है प्रोग्रामिंग भाषा बड़े डेटा सेटों के विश्लेषण के लिए उपयोगी। पिग याहू! के विकास प्रयासों का परिणाम है।
मैप रिड्यूस फ्रेमवर्क में, प्रोग्राम को मैप और रिड्यूस चरणों की एक श्रृंखला में अनुवादित करने की आवश्यकता होती है। हालाँकि, यह एक ऐसा प्रोग्रामिंग मॉडल नहीं है जिससे डेटा विश्लेषक परिचित हों। इसलिए, इस अंतर को पाटने के लिए, एक पूर्ण रूप से संशोधित (abs) विधि का उपयोग किया जाता है।tracपिग नामक संरचना का निर्माण इसके ऊपर किया गया था। Hadoop.
अपाचे पिग लोगों को बड़े डेटा सेट के विश्लेषण पर अधिक ध्यान केंद्रित करने और मैप रिड्यूस प्रोग्राम लिखने में कम समय बिताने में सक्षम बनाता है। सूअरों की तरह, जो कुछ भी खा लेते हैं, अपाचे पिग प्रोग्रामिंग भाषा को किसी भी प्रकार के डेटा पर काम करने के लिए डिज़ाइन किया गया है। इसीलिए इसका नाम पिग रखा गया है! नीचे दिया गया प्रोजेक्ट मैस्कॉट भी इसी बात को दर्शाता है।

यह प्रोजेक्ट अभी भी सक्रिय है। अपाचे पिग 0.18.0 इसे 15 सितंबर 2025 को जारी किया गया था और इसमें Hadoop 3, Tez 0.10, Hive 3 के लिए समर्थन जोड़ा गया है। Spark 3, एचबेस 2 और Python 3 के अनुसार अपाचे पिग रिलीज़ पेजनीचे दिया गया विस्तृत विवरण मूल रूप से बहुत पुराने 0.12.1 संस्करण के लिए लिखा गया था, इसलिए कुछ चरणों में यह उल्लेख किया गया है कि वर्तमान संस्करण अलग तरह से व्यवहार करता है।
सुअर Archiटेक्चर
पिग की वास्तुकला में दो घटक शामिल हैं:
- पिग लैटिन, जो एक भाषा है
- एक रनटाइम वातावरण, पिग लैटिन कार्यक्रम चलाने के लिए।
पिग लैटिन प्रोग्राम में कई ऑपरेशन या रूपांतरण होते हैं जो इनपुट डेटा पर लागू होकर आउटपुट उत्पन्न करते हैं। ये ऑपरेशन डेटा प्रवाह का वर्णन करते हैं, जिसे हैडूप पिग निष्पादन वातावरण द्वारा निष्पादन योग्य रूप में परिवर्तित किया जाता है। मूल रूप से, इन रूपांतरणों के परिणाम कई आउटपुट होते हैं। मानचित्र छोटा करना ऐसे कार्य जिनके बारे में प्रोग्रामर को जानकारी नहीं होती। इसलिए, एक तरह से, Hadoop में Pig प्रोग्रामर को निष्पादन की प्रकृति के बजाय डेटा पर ध्यान केंद्रित करने की अनुमति देता है।
पिग लैटिन एक अपेक्षाकृत कठोर भाषा है जो डेटा प्रोसेसिंग से परिचित कीवर्ड का उपयोग करती है, जैसे कि जॉइन, ग्रुप और फ़िल्टर। नीचे दिया गया आरेख tracयह ग्रंट शेल से एक स्क्रिप्ट को पार्सर, ऑप्टिमाइज़र और कंपाइलर के माध्यम से निष्पादन इंजन तक पहुंचाता है।

निष्पादन मोड
Hadoop में Pig के दो निष्पादन मोड हैं, और नीचे दिए गए इंस्टॉलेशन विवरण में इन दोनों का उपयोग किया गया है:
- स्थानीय मोड: इस मोड में, हैडूप पिग भाषा एक ही ड्राइव में चलती है। JVM और यह स्थानीय फ़ाइल सिस्टम का उपयोग करता है। यह मोड केवल Hadoop में Pig का उपयोग करके छोटे डेटासेट के विश्लेषण के लिए उपयुक्त है।
- मैप रिड्यूस मोड: इस मोड में, पिग लैटिन में लिखी गई क्वेरीज़ को मैप रिड्यूस जॉब्स में अनुवादित किया जाता है और उन्हें हैडूप क्लस्टर पर चलाया जाता है (क्लस्टर स्यूडो-डिस्ट्रिब्यूटेड या पूरी तरह से डिस्ट्रिब्यूटेड हो सकता है)। पूरी तरह से डिस्ट्रिब्यूटेड क्लस्टर वाला मैप रिड्यूस मोड बड़े डेटासेट पर पिग चलाने के लिए उपयोगी है।
ये दोनों क्लासिक जोड़ी हैं। वर्तमान रिलीज़ में वास्तव में छह निष्पादन प्रकार या एक्ज़ीक्यूशनटाइप उपलब्ध हैं, जिनमें से प्रत्येक को एक ही तरीके से चुना जाता है। -x ध्वज, जैसा कि प्रलेखित है Pig 0.18.0 आरंभ करने की मार्गदर्शिका.
| एक्जीटाइप | आदेश | जहां काम चलता है |
|---|---|---|
| स्थानीय | सुअर -x स्थानीय | स्थानीय फ़ाइल प्रणाली के विरुद्ध एक एकल JVM |
| तेज़ लोकल | सुअर -x तेज़_स्थानीय | टेज़ रनटाइम का उपयोग करने वाला एक एकल जेवीएम (प्रायोगिक) |
| Spark स्थानीय | सुअर -x स्पार्क_लोकल | एक सिंगल जेवीएम का उपयोग करते हुए Spark रनटाइम (प्रायोगिक) |
| मानचित्र छोटा करना | सुअर या सुअर -x मैप रिड्यूस | एचडीएफएस के साथ एक हैडूप क्लस्टर; यह डिफ़ॉल्ट सेटिंग है। |
| तेज | सुअर -x तेज | टेज़ इंजन चलाने वाला एक हैडूप क्लस्टर |
| Spark | सुअर -x स्पार्क | A SparkYARN या Mesos क्लस्टर के साथ HDFS |
पिग लैटिन डेटा प्रकार और Operaमरोड़
स्क्रिप्ट लिखने से पहले यह जानना ज़रूरी है कि Pig क्या-क्या डेटा संभाल सकता है और उस पर क्या-क्या कर सकता है। इसका डेटा मॉडल पूरी तरह से नेस्टेड है, जिसकी वजह से Pig लॉग फ़ाइलें और अन्य ऐसे इनपुट पढ़ सकता है जिन्हें रिलेशनल टेबल अस्वीकार कर देती है।
पिग लैटिन में टाइप के दो परिवार होते हैं:
- स्केलर प्रकार:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerऔरbigdecimalउदाहरण स्क्रिप्ट बाद में प्रत्येक कॉलम को इस प्रकार घोषित करती है।chararray. - जटिल प्रकार: a टपल यह फ़ील्ड का एक क्रमबद्ध सेट है और एक पंक्ति की तरह व्यवहार करता है; बैग यह टुपल्स का एक अव्यवस्थित संग्रह है और एक टेबल की तरह व्यवहार करता है; नक्शा यह कुंजी और मान युग्मों का एक समूह है जिसकी कुंजी एक होनी चाहिए
chararray.
ऑपरेटर कुछ ही नौकरियों में विभाजित हैं, और उनमें से मुट्ठी भर लोग लगभग हर पाइपलाइन का संचालन करते हैं:
| Operaटो | यह क्या करता है |
|---|---|
| लोड करें / स्टोर करें | फाइल सिस्टम से एक संबंध पढ़ें और परिणाम वापस लिखें |
| फ़िल्टर | केवल उन्हीं टुपल्स को रखें जो किसी शर्त से मेल खाते हों। |
| प्रत्येक के लिए… उत्पन्न करें | नए फ़ील्ड बनाते हुए, कॉलम दर कॉलम काम करें |
| समूह / सह-समूह | एक कुंजी के आधार पर एक संबंध, या दो या अधिक संबंधों को समूहबद्ध करें |
| शामिल हों | आंतरिक या बाहरी जोड़ के साथ संबंधों को संयोजित करें |
| संघ / विभाजन | संबंधों को आपस में मिलाएं, या एक संबंध को कई भागों में विभाजित करें। |
| क्रमबद्ध करें / विशिष्ट / सीमा | टुपल्स की संख्या को क्रमबद्ध करें, डुप्लिकेट हटाएं और सीमित करें। |
| सारांश प्रस्तुत करें / वर्णन करें / समझाएं / उदाहरण दें | परिणामों, स्कीमाओं, निष्पादन योजनाओं और नमूना रन का निरीक्षण करें |
चारों निरीक्षण ऑपरेटरों के पास ग्रंट शॉर्टकट भी हैं, जिससे समय की बचत होती है।ping डीबगिंग के दौरान: \d डंप के लिए, \de वर्णन करने के लिए, \e व्याख्या के लिए और \i उदाहरण के लिए।
.. पूर्वापेक्षाएँ
Pig एक क्लाइंट-साइड टूल है। यह स्क्रिप्ट को पार्स करता है, काम की योजना बनाता है और जॉब सबमिट करता है, लेकिन यह अपना खुद का स्टोरेज या क्लस्टर प्रदान नहीं करता है, इसलिए पहले एक कार्यशील Hadoop इंस्टॉलेशन होना आवश्यक है। Apache की आवश्यकताएँ संक्षिप्त हैं।
| घटक | आवश्यकता | इसकी आवश्यकता क्यों है |
|---|---|---|
| Hadoop | Hadoop 2.x या 3.x, जिसमें HADOOP_HOME निर्यात किया गया हो | यह HDFS और निष्पादन इंजन प्रदान करता है। HADOOP_HOME के बिना, Pig 0.18.0 एम्बेडेड Hadoop 2.7.3 पर वापस चला जाता है। |
| Java | Java 1.7 या उसके बाद के संस्करण में, JAVA_HOME को इंस्टॉलेशन रूट पर सेट किया गया हो। | पिग और हैडूप डेमन हैं Java कार्यक्रमों |
| Python (वैकल्पिक) | Python 2.7 | स्ट्रीमिंग के लिए ही आवश्यक है Python उपयोगकर्ता परिभाषित कार्य |
| चींटी (वैकल्पिक) | चींटी 1.8 | Pig को स्रोत से बनाते या पुनः संकलित करते समय ही इसकी आवश्यकता होती है। |
उस सूची के साथ दो व्यावहारिक बिंदु भी हैं। पहला, सब कुछ एक ऐसे लिनक्स उपयोगकर्ता के रूप में चलाएँ जिसके पास पहले से ही एक होम डायरेक्टरी हो। एचडीएफएस और इस पर लिखने की अनुमति; यह ट्यूटोरियल उपयोग करता है hduserHadoop सेटअप के दौरान बनाया गया खाता। दूसरा, MapReduce मोड में Pig लॉन्च करने से पहले क्लस्टर शुरू करें, क्योंकि NameNode और ResourceManager के बंद होने पर Pig तुरंत विफल हो जाता है। यदि Hadoop अभी तक स्थापित नहीं है, तो आगे की प्रक्रिया करें। Hadoop को कैसे स्थापित करें पहले।
पिग को कैसे डाउनलोड और इंस्टॉल करें
अब इस अपाचे पिग ट्यूटोरियल में, हम सीखेंगे कि पिग को कैसे डाउनलोड और इंस्टॉल किया जाए:
वास्तविक प्रक्रिया शुरू करने से पहले, सुनिश्चित करें कि आपके सिस्टम में Hadoop इंस्टॉल है। उपयोगकर्ता आईडी को 'hduser' में बदलें (यह वही आईडी है जिसका उपयोग Hadoop को कॉन्फ़िगर करते समय किया गया था; आप अपनी Hadoop कॉन्फ़िगरेशन के दौरान उपयोग की गई उपयोगकर्ता आईडी का उपयोग कर सकते हैं)।

चरण 1) Pig Hadoop का नवीनतम स्थिर संस्करण नीचे दिए गए किसी भी मिरर साइट से डाउनलोड करें।
https://pig.apache.org/releases.html
नीचे दिखाए अनुसार, डाउनलोड करने के लिए tar.gz फ़ाइल का चयन करें (src.tar.gz का नहीं)।

चरण 2) डाउनलोड पूरा होने के बाद, डाउनलोड की गई tar फ़ाइल वाली डायरेक्टरी में जाएं और tar फ़ाइल को उस स्थान पर ले जाएं जहां आप Pig Hadoop को सेटअप करना चाहते हैं। इस मामले में, हम इसे /usr/local में ले जाएंगे।

उस डायरेक्टरी में जाएं जिसमें पिग हैडूप फाइलें होंगी।
cd /usr/local
Extracटार फाइल की सामग्री नीचे दी गई है।
sudo tar -xvf pig-0.12.1.tar.gz

चरण 3) Pig से संबंधित पर्यावरण चर जोड़ने के लिए ~/.bashrc फ़ाइल को संशोधित करें।
अपनी पसंद के किसी भी टेक्स्ट एडिटर में ~/.bashrc फ़ाइल खोलें और नीचे दिए गए बदलाव करें।
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

चरण 4) अब, नीचे दिए गए कमांड का उपयोग करके इस पर्यावरण कॉन्फ़िगरेशन को सोर्स करें।
. ~/.bashrc

चरण 5) हमें Hadoop 2.2.0 को सपोर्ट करने के लिए Pig को पुनः कंपाइल करने की आवश्यकता है।
इसे करने के लिए ये चरण हैं।
पिग होम डायरेक्टरी पर जाएं।
cd $PIG_HOME
Ant इंस्टॉल करें।
sudo apt-get install ant

ध्यान दें: डाउनलोड शुरू हो जाएगा और आपकी इंटरनेट स्पीड के अनुसार इसमें समय लगेगा।
पिग को पुनः संकलित करें।
sudo ant clean jar-all -Dhadoopversion=23

कृपया ध्यान दें कि इस पुनर्संकलन प्रक्रिया में कई घटक डाउनलोड किए जाते हैं, इसलिए सिस्टम का इंटरनेट से कनेक्ट होना आवश्यक है।
इसके अलावा, यदि यह प्रक्रिया कहीं अटक जाती है और आपको 20 मिनट से अधिक समय तक कमांड प्रॉम्प्ट पर कोई गतिविधि दिखाई नहीं देती है, तो Ctrl + c दबाएं और उसी कमांड को दोबारा चलाएं।
हमारे मामले में, इसमें 20 मिनट लगते हैं।

यह पुनर्संकलन चरण 0.12.1 युग से संबंधित है, जब शिप किए गए जार हैडूप 1 के विरुद्ध बनाए गए थे और -Dhadoopversion=23 इस फ़्लैग ने एंट बिल्ड को हैडूप 0.23 और 2.x लाइन पर स्विच कर दिया है। अपाचे पिग 0.18.0 में ऐसे बाइनरी शामिल हैं जो पहले से ही हैडूप 2.7 और उससे ऊपर के संस्करणों के साथ-साथ हैडूप 3 पर भी चलते हैं, इसलिए वर्तमान रिलीज़ पर आप आमतौर पर टारबॉल को अनपैक कर सकते हैं और सीधे नीचे दिए गए परीक्षण पर जा सकते हैं।
चरण 6) कमांड का उपयोग करके पिग इंस्टॉलेशन का परीक्षण करें
pig -help

उदाहरण सुअर स्क्रिप्ट
Pig इंस्टॉल हो जाने के बाद, इस Apache Pig ट्यूटोरियल के बाकी हिस्से में एक पूरी स्क्रिप्ट चलाई जाएगी। हम Pig स्क्रिप्ट का उपयोग करके प्रत्येक देश में बेचे गए उत्पादों की संख्या ज्ञात करेंगे।
इनपुट: हमारा इनपुट डेटा सेट एक CSV फ़ाइल है। SalesJan2009.csv.
चरण 1) Hadoop शुरू करें।
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
चरण 2) बिग डेटा में पिग (Pig) मैप रिड्यूस मोड में एचडीएफएस से एक फाइल लेता है और परिणामों को वापस एचडीएफएस में संग्रहीत करता है।
स्थानीय फ़ाइल सिस्टम पर ~/input/SalesJan2009.csv पर संग्रहीत फ़ाइल SalesJan2009.csv को HDFS (Hadoop Distributed File System) होम डायरेक्टरी में कॉपी करें।
इस अपाचे पिग उदाहरण में, फ़ाइल इनपुट फ़ोल्डर में है। यदि फ़ाइल किसी अन्य स्थान पर संग्रहीत है, तो उस फ़ोल्डर का नाम दें।
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

जांचें कि फाइल वास्तव में कॉपी हुई थी या नहीं।
$HADOOP_HOME/bin/hdfs dfs -ls /

चरण 3) सुअर विन्यास।
सबसे पहले, $PIG_HOME/conf पर जाएं और मूल प्रॉपर्टीज़ फ़ाइल की एक प्रति सुरक्षित रखें।
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

अपनी पसंद के किसी टेक्स्ट एडिटर का उपयोग करके pig.properties फ़ाइल खोलें और pig.logfile का उपयोग करके लॉग फ़ाइल का पथ निर्दिष्ट करें।
sudo gedit pig.properties

लॉगर त्रुटियों को लॉग करने के लिए इस फ़ाइल का उपयोग करेगा।
चरण 4) 'pig' कमांड चलाएं, जिससे Pig कमांड प्रॉम्प्ट शुरू हो जाएगा, जो Pig क्वेरी के लिए एक इंटरैक्टिव शेल है।
pig

चरण 5) पिग के लिए ग्रंट कमांड प्रॉम्प्ट में, नीचे दिए गए पिग कमांड को क्रम से निष्पादित करें।
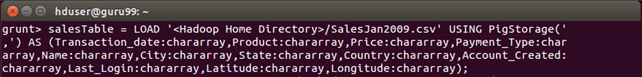
— A. डेटा युक्त फ़ाइल लोड करें.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
इस आदेश के बाद Enter दबाएँ।
— बी. डेटा को देश के आधार पर समूहित करें।
GroupByCountry = GROUP salesTable BY Country;

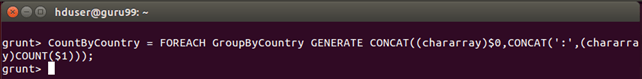
— C. 'GroupByCountry' में प्रत्येक टपल के लिए, देश का नाम: बेचे गए उत्पादों की संख्या के रूप में परिणामी स्ट्रिंग उत्पन्न करें।
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
इस आदेश के बाद Enter दबाएँ।
— डी. डेटा प्रवाह के परिणामों को एचडीएफएस पर 'pig_output_sales' निर्देशिका में संग्रहीत करें।
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

इस कमांड को निष्पादित होने में कुछ समय लगेगा। पूरा होने पर, आपको निम्न स्क्रीन दिखाई देगी।

चरण 6) परिणाम को कमांड इंटरफेस के माध्यम से देखा जा सकता है।
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

परिणाम वेब इंटरफेस के माध्यम से भी देखे जा सकते हैं।
वेब ब्राउज़र में http://localhost:50070/ खोलें।
पोर्ट 50070 हैडूप 2 पर नेमनोड वेब यूआई है। हैडूप 3 ने उसी पेज को पोर्ट 9870 पर स्थानांतरित कर दिया है, इसलिए यदि आपका क्लस्टर हैडूप 3 चला रहा है तो उस पते का उपयोग करें।

अब 'ब्राउज़ द फाइलसिस्टम' चुनें और /user/hduser/pig_output_sales पर जाएं।

स्क्रिप्ट द्वारा उत्पन्न देश और उत्पाद-गणना युग्मों को पढ़ने के लिए part-r-00000 खोलें।

अपाचे पिग बनाम हाइव बनाम मैप रिड्यूस
पिग का मूल्यांकन शायद ही कभी अकेले किया जाता है। आमतौर पर यह सवाल उठता है कि क्या कोई नौकरी पिग के अंतर्गत आती है या नहीं। करंड या फिर हाथ से लिखे गए मैप रिड्यूस प्रोग्राम में, क्योंकि ये तीनों ही अंततः एक ही क्लस्टर पर जॉब के रूप में समाप्त होते हैं।
| पहलू | मैप रिड्यूस (Java) | अपाचे सुअर | अपाचे हाइव |
|---|---|---|---|
| इंटरफेस | Java API | पिग लैटिन, एक डेटा-फ्लो स्क्रिप्टिंग भाषा | हाइवक्यूएलएक SQL बोली |
| पेट की मांसपेशियों का स्तरtracउत्पादन | निम्न | मध्यम | हाई |
| सामान्य उपयोगकर्ता | Java विकासक | डेटा इंजीनियर या शोधकर्ता | SQL में निपुण विश्लेषक |
| यह डेटा उपयुक्त है | कोई भी चीज़, मैन्युअल रूप से संभाली गई | संरचित और अर्ध-संरचित; लोड करते समय स्कीमा वैकल्पिक है | मेटास्टोर में पंजीकृत संरचित तालिकाएँ |
| Code आयतन | अधिकांश रेखाएँ | कम पंक्तियाँ | किसी क्वेरी के लिए सबसे कम पंक्तियाँ |
| इस रूप में चलता है | एक मैप रिड्यूस जॉब | यह MapReduce, Tez या किसी अन्य फॉर्मेट में कंपाइल होता है। Spark नौकरियों | यह MapReduce, Tez या किसी अन्य फॉर्मेट में कंपाइल होता है। Spark नौकरियों |
| सबसे अच्छा | पूर्ण नियंत्रण और अनुकूलित तर्क | बहु-चरणीय ईटीएल पाइपलाइन | तदर्थ पूछताछ और रिपोर्टिंग |
व्यवहार में विभाजन सीधा है। Hive का उपयोग तब करें जब डेटा पहले से ही एक टेबल जैसा दिखता हो और प्रश्न SQL से संबंधित हो। Pig का उपयोग तब करें जब इनपुट अव्यवस्थित हो, जब पाइपलाइन एक क्वेरी के बजाय रूपांतरणों की एक श्रृंखला हो, या जब एक ही स्क्रिप्ट को ब्रांच और रीजॉइन करना हो। MapReduce का उपयोग केवल तभी करें जब दोनों में से कोई भी पूर्ण रूप से मान्य न हो।tracक्योंकि पंक्तियों की संख्या तेजी से बढ़ती है, इसलिए तर्क को व्यक्त करना संभव नहीं है।
सुअर भी पारिस्थितिकी तंत्र के बाकी हिस्सों के साथ आराम से रहता है। स्क्वूप और फ्लूम कच्चे डेटा को लैंड करें, पिग या हाइव उसे आकार दें, और एक शेड्यूलर जैसे कि अपाचे ऊज़ी यह चरणों को एक दोहराने योग्य पाइपलाइन में पिरोता है। इन उपकरणों की व्यापक उपयोगिता को समझने के लिए, मार्गदर्शिका देखें। बड़ा डेटा और सारांश बड़े डेटा उपकरणहस्तलिखित स्क्रिप्ट के वाणिज्यिक ईटीएल विकल्प के लिए, देखें Talend.
