
Apprentissage automatique supervisé : Algorithms, types et exemples
 Evelyn Clarke
⚡ Résumé intelligent
L'apprentissage automatique supervisé entraîne un algorithme sur des exemples étiquetés afin qu'il puisse prédire les résultats pour des données qu'il n'a jamais vues auparavant, en utilisant la régression pour les cibles numériques et la classification pour les cibles catégorielles telles que le spam ou la fraude.
Qu'est-ce que l'apprentissage automatique supervisé ?
L'apprentissage automatique supervisé est un algorithme qui apprend à partir de données d'entraînement étiquetées afin de prédire les résultats pour des données imprévues. Dans l'apprentissage supervisé, la machine est entraînée à l'aide de données déjà bien étiquetées, c'est-à-dire comportant des réponses correctes. On peut le comparer à un apprentissage sous la supervision d'un enseignant.
La conception, la mise à l'échelle et le déploiement réussis de modèles d'apprentissage automatique supervisé précis exigent du temps et l'expertise technique d'une équipe de data scientists hautement qualifiés. Ces derniers doivent également reconstruire les modèles périodiquement afin que les informations qu'ils produisent restent pertinentes malgré l'évolution des données sous-jacentes.
Comment fonctionne l'apprentissage supervisé
L'apprentissage automatique supervisé utilise des ensembles de données de formation pour obtenir les résultats souhaités. Ces ensembles de données contiennent des entrées et la sortie correcte qui aident le modèle à apprendre plus rapidement. Par exemple, vous souhaitez former une machine pour vous aider à prédire combien de temps il vous faudra pour rentrer chez vous depuis votre lieu de travail.
Ici, vous commencez par créer un ensemble de données étiquetées. Ces données comprennent :
- Conditions météorologiques
- Moment de la journée
- Les Fêtes de Fin d'Année
- Itinéraire choisi
Tous ces détails constituent vos données d'entrée dans cet exemple d'apprentissage supervisé. La sortie correspond au temps de trajet retour ce jour-là, comme illustré ci-dessous.
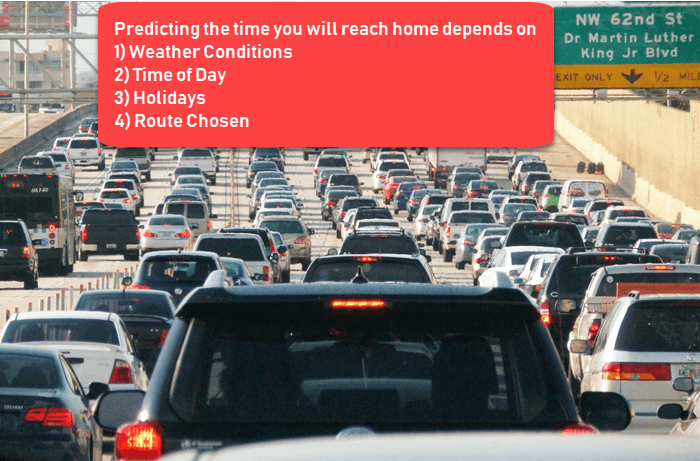
Vous savez instinctivement que s'il pleut, le trajet du retour sera plus long. Mais la machine a besoin de données et de statistiques.
La première étape consiste à créer un ensemble d'entraînement. Celui-ci contiendra la durée totale du trajet domicile-travail ainsi que des facteurs associés comme la météo, l'heure, etc. Grâce à cet ensemble d'entraînement, votre système pourra établir une corrélation directe entre la quantité de pluie et le temps de trajet.
Ainsi, il apparaît que plus il pleut, plus le trajet pour rentrer chez soi sera long. Il est également possible d'établir un lien entre l'heure de départ du travail et la durée du trajet : plus on se rapproche de 6 h, plus le retour à la maison est long.
Votre machine pourra peut-être identifier certaines corrélations avec vos données étiquetées. Cette phase d'apprentissage est illustrée ci-dessous.
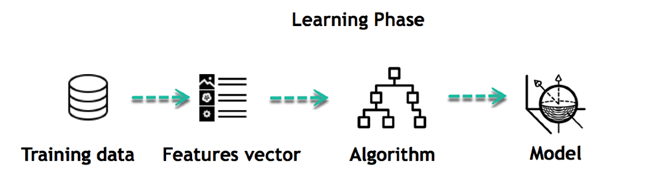
Voici le début de votre modèle de données. Il commence à enregistrer comment la pluie influence la conduite et que les déplacements sont plus fréquents à certaines heures de la journée.
Types d’apprentissage automatique supervisé Algorithms
Voici les types d’algorithmes d’apprentissage automatique supervisé :
Régression
La technique de régression prédit une seule valeur de sortie continue à partir de données d'apprentissage.
Exemple : vous pouvez utiliser la régression pour prédire le prix de l'immobilier à partir des données de formation. Les variables d'entrée seront la localité, la taille d'une maison, etc.
Points forts : Les résultats sont faciles à interpréter et l’algorithme peut être régularisé pour éviter le surapprentissage.
Points faibles : Un modèle linéaire manque de flexibilité et ne permet donc pas de saisir les relations complexes sans fonctionnalités supplémentaires.
Voici quelques types de régression Algorithms:
- Régression linéaire
- Régression polynomiale
- Régression Ridge et Lasso
- Régression logistique (pour la classification)
- Régression par arbre de décision et forêt aléatoire
- Prise en charge de la régression vectorielle
Régression logistique:
La régression logistique permet d'estimer des valeurs discrètes à partir d'un ensemble de variables indépendantes. Elle aide à prédire la probabilité d'occurrence d'un événement en ajustant les données à une fonction logit. C'est pourquoi on l'appelle aussi régression logistique. Comme elle prédit une probabilité, sa valeur de sortie se situe entre 0 et 1, et ses performances peuvent être moindres en présence de frontières de décision multiples ou non linéaires.
Classification
La classification consiste à regrouper les données de sortie au sein d'une classe. Si l'algorithme tente de classer les données d'entrée en deux classes distinctes, on parle de classification binaire. La sélection entre plus de deux classes est appelée classification multiclasse.
Exemple : Déterminer si une personne sera ou non en défaut de paiement de son prêt.
Points forts : Les arbres de classification donnent d'excellents résultats en pratique.
Faiblesses : Les arbres individuels non contraints sont sujets au surapprentissage.
Voici quelques types de classification Algorithms:
- Classificateurs bayésiens naïfs
- Arbres de décision
- Soutenir la machine vectorielle
- Les voisins les plus proches
- Forêt aléatoire et gradient boosting
Classificateurs bayésiens naïfs
Le Naïf Bayes Ce modèle est facile à construire et très utile pour les grands ensembles de données. Cette méthode repose sur des graphes acycliques orientés comportant un parent et plusieurs enfants. Elle suppose l'indépendance des nœuds enfants par rapport à leur parent.
Arbres de décision
Les arbres de décision classent une instance en la triant selon la valeur de ses caractéristiques. Dans cette méthode, chaque nœud représente une caractéristique de l'instance à classer, et chaque branche représente une valeur possible pour ce nœud. C'est une technique de classification largement utilisée.
La même structure s'applique à la régression : un arbre de régression permet d'estimer des valeurs réelles (coût d'achat d'une voiture, nombre d'appels, total des ventes mensuelles, etc.).
Soutenir la machine vectorielle
La machine à vecteurs de support (SVM) est un type d'algorithme d'apprentissage introduit dans les années 1990. Cette méthode est basée sur les résultats de la théorie de l'apprentissage statistique développée par Vladimir Vapnik et ses collègues.
Les SVM sont également étroitement liées aux fonctions noyau, un concept central pour la plupart des tâches d'apprentissage. Le cadre des noyaux et les SVM sont utilisés dans de nombreux domaines, notamment la recherche d'informations multimédias, la bioinformatique et la reconnaissance de formes. Chaque estimateur mentionné ci-dessus est documenté avec ses paramètres de réglage. scikit-apprendre référence.
Techniques d'apprentissage automatique supervisées et non supervisées
Placer la méthode à côté apprentissage non supervisé elle définit clairement ses limites.
| Basé sur | Technique d'apprentissage automatique supervisé | Technique d'apprentissage automatique non supervisé |
|---|---|---|
| Des données d'entrée | Algorithms sont formés à l’aide de données étiquetées. | Algorithms sont utilisés contre des données qui ne sont pas étiquetées |
| Complexité informatique | L'apprentissage supervisé est une méthode plus simple. | L'apprentissage non supervisé est complexe sur le plan informatique |
| Exactitude | Méthode très précise et fiable. | Less méthode précise et fiable. |
| Algorithmes typiques | Régression logistique, arbres de décision, SVM, Naive Bayes | K-means, clustering hiérarchique, PCA |
| Comment les résultats sont évalués | Évaluation par rapport aux réponses connues (exactitude, RMSE) | Évalué selon des critères internes et un examen humain |
Défis de l'apprentissage automatique supervisé
Voici les défis rencontrés dans l’apprentissage automatique supervisé :
- Des caractéristiques d'entrée non pertinentes dans les données d'entraînement peuvent produire des résultats inexacts
- La préparation et le prétraitement des données constituent toujours un défi.
- La précision se dégrade lorsque des valeurs impossibles, improbables ou incomplètes ont été saisies comme données d'entraînement.
- Si l'expert concerné n'est pas disponible, l'autre approche consiste à utiliser la méthode « par force brute ». Cela signifie qu'il faut deviner sur quelles caractéristiques (variables d'entrée) entraîner la machine, et cette supposition peut être inexacte.
Avantages de l'apprentissage supervisé
Face à ces défis, voici les avantages de l'apprentissage automatique supervisé :
- Apprentissage supervisé en Machine Learning vous permet de collecter des données ou de produire un résultat de données à partir d'expériences antérieures
- Vous aide à optimiser les critères de performance en utilisant l’expérience
- L'apprentissage automatique supervisé vous aide à résoudre différents types de problèmes de calcul réels.
Inconvénients de l’apprentissage supervisé
Voici les inconvénients de l'apprentissage automatique supervisé :
- La frontière de décision peut être sur-entraînée si votre ensemble d'entraînement ne contient pas d'exemples que vous souhaitez inclure dans une classe.
- Vous devez sélectionner de nombreux bons exemples dans chaque classe pendant que vous entraînez le classificateur.
- La classification des données massives peut s'avérer un véritable défi.
- La formation à l’apprentissage supervisé nécessite beaucoup de temps de calcul.
Meilleures pratiques pour l'apprentissage supervisé
La séquence suivante maintient un projet en cours. track:
- Avant toute chose, déterminez quel type de données sera utilisé comme ensemble d'entraînement.
- Déterminez la structure de la fonction apprise et l'algorithme d'apprentissage.
- Recueillir les résultats correspondants, soit auprès d'experts humains, soit à partir de mesures.
- Mettez de côté un ensemble de test que le modèle ne voit jamais, et indiquez le score obtenu.
