
SAP Vues de calcul HANA : types et procédure de création
 Équipe éditoriale
⚡ Résumé intelligent
Vue de calcul dans SAP HANA est la vue d'information la plus puissante. Elle combine des tables, des vues de colonnes, des vues analytiques et d'autres vues de calcul grâce à des nœuds de jointure, d'union, de projection, d'agrégation et de classement.
Qu’est-ce que la vue Calcul ?
SAP La vue Calcul HANA est une vue d’informations puissante.
SAP La mesure de la vue analytique HANA ne peut être sélectionnée qu'à partir d'une seule table de faits. Lorsqu'il est nécessaire d'ajouter une table de faits supplémentaire dans la vue d'informations, la vue de calcul entre en jeu. La vue de calcul prend en charge les calculs complexes.
La base de données de la vue de calcul peut inclure des tables, des vues de colonnes, des vues analytiques et des vues de calcul.
Nous pouvons créer Joint, Unions, Agrégation et Projections sur les sources de données.
La vue Calcul peut contenir plusieurs mesures et peut être utilisée pour des rapports multidimensionnels ou pour aucune mesure utilisée dans les rapports de type liste.
Caractéristique de SAP Vue du calcul HANA comme ci-dessous –
- Prise en charge des calculs complexes.
- Prend en charge les modèles OLTP et OLAP.
- Prise en charge de la gestion des clients, de la langue et de la conversion des devises.
- Union de support, projection, agrégation, rang, etc.
SAP Les vues de calcul HANA sont de deux types :
- SAP Vue de calcul graphique HANA (créée par SAP Éditeur graphique HANA Studio).
- SAP Vues de calculs basées sur des scripts HANA (créées par des scripts SQL par SAP Studio Hana).
Vue de calcul graphique vs vue de calcul par script
Les deux versions produisent le même type d'objet, mais leur fabrication et leur entretien sont très différents, et il est difficile de revenir en arrière une fois la production lancée.
| Paramètres | Graphique | Basé sur un script |
|---|---|---|
| Construit avec | Glissez-déposez les nœuds dans l'éditeur | SQLScript dans un bloc CE_ ou SQL |
| Optimisation | Le moteur peut supprimer les nœuds inutilisés lors de l'exécution. | S'exécute comme prévu, peu de marge d'optimisation |
| lisibilité | Le diagramme de scénario se documente lui-même | Cela dépend entièrement de l'auteur |
| Capability | Répond à la plupart des besoins | Gère la logique qu'aucune combinaison de nœuds ne peut exprimer |
| Entretien | N'importe quel modéliste peut le suivre. | Compétences SQLScript requises |
| Recommandation | Choix par défaut | Uniquement là où le graphique ne peut vraiment pas le faire |
Le critère déterminant est la performance. Une vue graphique permet à HANA d'ignorer les nœuds dont la sortie n'est pas nécessaire à la requête ; ainsi, une jointure inutilisée ne coûte rien. Une vue basée sur un script exécute systématiquement chaque instruction qu'elle contient. Privilégiez l'affichage graphique et ne passez à un script qu'en cas de besoin.
SAP Vue de calcul graphique HANA
In SAP Vue analytique HANA, nous ne pouvons sélectionner une mesure que dans une seule table.
Ainsi, lorsqu'il est nécessaire d'avoir une vue contenant des mesures provenant de différentes tables, elle ne peut pas être réalisée par une vue analytique mais par une vue de calcul.
Ainsi, dans ce cas, nous pouvons utiliser deux vues analytiques différentes pour chaque table et les joindre dans la vue calcul.
Nous allons créer une vue de calcul graphique « CA_FI_LEDGER » en joignant deux vues analytiques « AN_PURCHASE_ORDER » et « AN_FI_DOCUMENT ».
CA_FI_LEDGER affichera les détails du document financier lié à un bon de commande.
Étape 1) Dans cette étape,
- Allez dans le package (Ici Modélisation) et faites un clic droit.
- Sélectionnez Nouvelle option.
- Sélectionnez Vue de calcul.
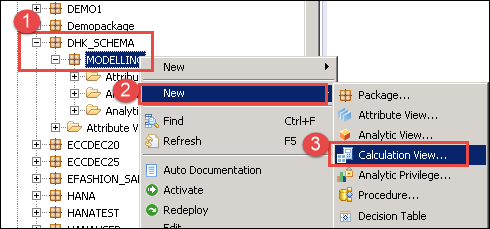
Un éditeur de vue de calcul s'affichera, dans lequel le panneau de scénario s'affichera comme ci-dessous :
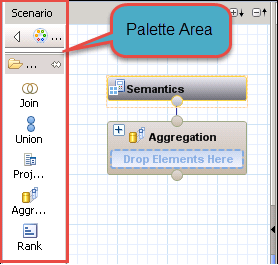
Le détail du panneau Scénario est le suivant :
Palette: Cette section contient les nœuds ci-dessous qui peuvent servir de source pour construire nos vues de calcul. Nous avons 5 types de nœuds différents :
- Inscription: Ce nœud est utilisé pour joindre deux objets source et transmettre le résultat au nœud suivant. Les types de jointure peuvent être une jointure interne, externe gauche, externe droite et texte. À noter: Nous ne pouvons ajouter que deux objets sources à un nœud de jointure.
- Syndicat: Ceci est utilisé pour effectuer l’union de toutes les opérations entre plusieurs sources. La source peut être un nombre n d’objets.
- Projection: Ceci est utilisé pour sélectionner des colonnes, filtrer les données et créer des colonnes supplémentaires avant de les utiliser dans les nœuds suivants comme une union, une agrégation et un classement. À noter: Nous ne pouvons ajouter qu’un seul objet source dans un nœud Projection.
- Agrégation: Ceci est utilisé pour effectuer une agrégation sur des colonnes spécifiques en fonction des attributs sélectionnés.
- Rang: C'est le remplacement exact de la fonction RANK dans SQL. Nous pouvons définir la partition et la clause order by en fonction des besoins.
Étape 2)
- Cliquez sur le nœud Projection dans la palette et faites glisser et déposez vers la zone de scénario à partir de la vue analytique du bon de commande. Renommé en « Projection_PO ».
- Cliquez sur le nœud Projection dans la palette et faites glisser et déposez vers la zone de scénario pour la vue analytique du document FI. Renommé en « Projection_FI ».
- Faites glisser et déposez les vues analytiques « AN_PURCHASE_ORDER » et « AN_FI_DOCUMENT » du dossier Content vers les nœuds « Projection_PO » et « Projection_FI » respectivement.
- Cliquez sur Rejoindre le nœud à partir de la palette et faites glisser et déposez vers la zone du scénario.
- Joignez le nœud Projection_PO au nœud Join_1.
- Joignez le nœud Projection_FI au nœud Join_1.
- Cliquez sur le nœud Agrégation dans la palette et faites glisser et déposez vers la zone du scénario.
- Joignez le nœud Join_1 au nœud Agrégation.
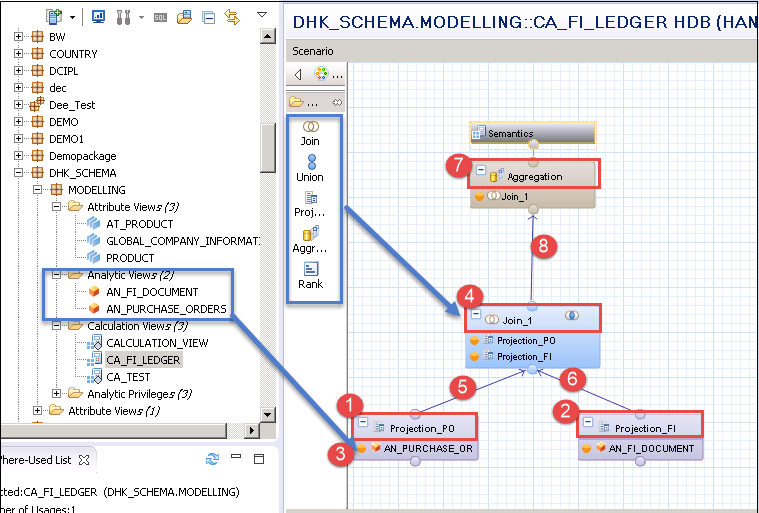
Nous avons ajouté deux vues analytiques, pour créer une vue de calcul.
Étape 3) Cliquez sur le nœud Join_1 sous agrégation et vous pouvez voir la section détaillée s'afficher.
- Sélectionnez toutes les colonnes du nœud Projection_PO pour la sortie.
- Sélectionnez toutes les colonnes du nœud Projection_FI pour la sortie.
- Joindre le nœud Projection_PO au nœud Projection_FI sur la colonne Projection_PO.PO_Number = Projection_FI.PO_NO.
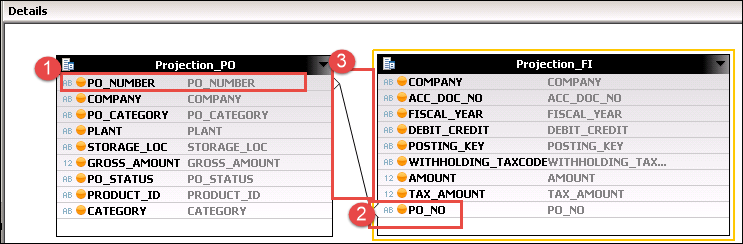
Étape 4) Dans cette étape,
- Cliquez sur le nœud Agrégation et les détails seront affichés sur le côté droit du volet.
- Sélectionnez Colonne pour la sortie à partir du Join_1 affiché sur le côté droit dans la fenêtre de détail.
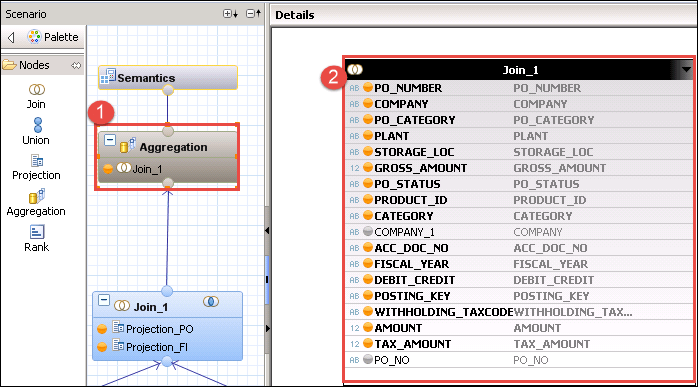
Étape 5) Maintenant, cliquez sur le nœud sémantique.
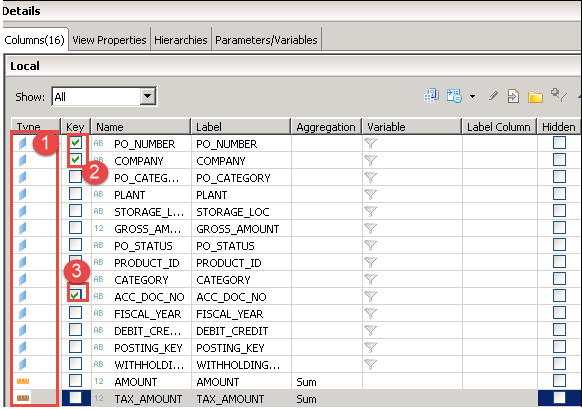
L’écran de détail s’affichera comme ci-dessous. Définissez l’attribut et le type de mesure pour la colonne et marquez également la clé pour cette sortie.
- Définir l'attribut et la mesure.
- Marquez PO_Number et COMPANY comme clé.
- Marquez ACC_DOC_NO comme clé.
Étape 6) Validez et activez la vue de calcul, depuis la barre supérieure de la fenêtre.
- Cliquez sur l'icône Valider.
- Cliquez sur Activer l'icône.
La vue de calcul sera activée et s'affichera sous le package de modélisation comme ci-dessous :
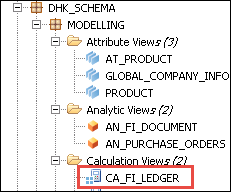
Sélectionnez la vue de calcul et cliquez avec le bouton droit -> Aperçu des données
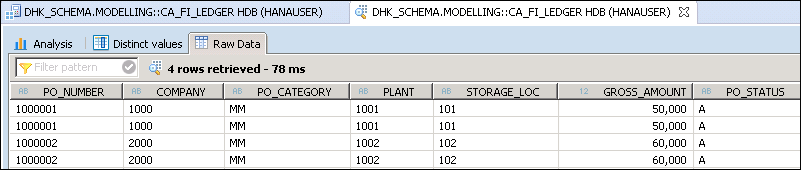
Nous avons ajouté deux vues analytiques et sélectionné la mesure (TAX_AMOUNT, GROSS_AMOUNT) dans les deux vues analytiques.
L’écran d’aperçu des données s’affichera comme ci-dessous –
Fonctions CE dans les vues basées sur des scripts
⚠️ Note de version : Les opérateurs de plan du moteur de calcul, les fonctions CE_ décrites ci-dessous, sont obsolètes. SAPCes instructions restent documentées ici car elles sont largement utilisées dans le code existant, mais les nouveaux développements devraient privilégier le SQL standard, désormais géré au moins aussi efficacement par l'optimiseur. L'utilisation simultanée de fonctions CE_ et de SQL dans une même requête est également une cause connue de plans d'exécution inefficaces.
Fonctions CE également connues sous le nom de plan de moteur de calcul Operator (CE Operators) sont des alternatives aux instructions SQL.
La fonction CE est de deux types –
Fonction d'accès à la source de données
Cette fonction lie une table de colonnes ou une vue de colonnes à une variable de table. Voici une liste de fonctions d'accès aux sources de données :
- CE_COLUMN_TABLE
- CE_JOIN_VIEW
- CE_OLAP_VIEW
- CE_CALC_VIEW
Relationnel OperaFonction de rotation
En utilisant le relationnel Operator, l'utilisateur peut contourner le SQL Le processeur effectue l'évaluation et communique directement avec le moteur de calcul. Voici quelques exemples de relations OperaListe des fonctions tor –
- CE_JOIN (Utilisé pour effectuer une jointure interne entre deux sources et lire les colonnes/données requises.)
- CE_RIGHT_OUTER_JOIN (Cette fonction permet d'effectuer une jointure externe droite entre les deux sources et d'afficher les colonnes interrogées dans le résultat.)
- CE_LEFT_OUTER_JOIN (Utilisé pour effectuer une jointure externe gauche entre les sources et afficher les colonnes interrogées dans la sortie).
- CE_PROJECTION (Cette fonction affiche les colonnes spécifiques de la source et applique des filtres pour restreindre les données. Elle offre également des fonctionnalités d'alias pour les noms de colonnes.)
- CE_CALC (Utilisé pour calculer des colonnes supplémentaires en fonction des besoins métier. Équivalent à une colonne calculée dans les modèles graphiques.)
Voici une liste de SQL avec fonction CE avec quelques exemples-
| Nom de la requête | Requête SQL | Fonction intégrée CE |
|---|---|---|
| Requête de sélection sur la table de colonnes | SELECT C, D Dans « COLUMN_TABLE ». | CE_COLUMN_TABLE("COLUMN_TABLE",[C,D]) |
| Sélectionner une requête sur la vue d'attribut | SELECT C, D à partir de « ATTRIBUTE_VIEW » | CE_JOIN_VIEW("ATTRIBUTE_VIEW",[C,D]) |
| Sélectionner une requête dans la vue analytique | SELECT C, D, SUM(E) à partir du groupe « ANALYTIC_VIEW » par C, D | CE_OLAP_VIEW("ANALYTIC_VIEW",[C,D]) |
| Sélectionner une requête dans la vue de calcul | SELECT C, D, SUM(E) à partir du groupe « CALCULATION_VIEW » par C,D | CE_CALC_VIEW("CALCULATION_VIEW",[C,D]) |
| Où avoir | SELECT C, D, SUM(E) FROM “ANALYTIC_VIEW” WHERE C = 'value' | var1 = CE_COLUMN_TABLE(“COLUMN_TABLE”); CE_PROJECTION(:var1,[C,D],'”C” = ”valeur”') |
Types de vues de calcul : Dimension, Cube et Cube avec jointure en étoile
Courant SAP Les versions HANA demandent une catégorie de données lors de la création d'une vue de calcul, et ce choix détermine les fonctionnalités de la vue et la manière dont les outils de reporting la traitent.
| Catégorie de données | Contient des mesures | Rejoignez Star disponible | Remplace |
|---|---|---|---|
| Dimension | Non | Non | Vue des attributs |
| Cube | Oui | Non | Scénarios analytiques simples |
| Cube avec étoile Joindre | Oui | Oui | vue analytique |
C’est pourquoi les projets actuels ne construisent souvent que des vues de calcul. Une vue de catégorie Dimension effectue le travail d’une vue de calcul. vue d'attributet Cube avec jointure en étoile fait le travail d'un vue analytiqueAinsi, un seul type d'objet couvre l'ensemble du modèle. Les vues d'attributs et analytiques existantes restent fonctionnelles, et les concepts correspondent directement aux catégories ci-dessus.
Conseils de performance pour la vue Calcul
Une vue de calcul est suffisamment flexible pour être mal conçue, et un même scénario peut s'exécuter en une seconde ou une minute selon la disposition des nœuds. Six règles permettent de couvrir la majeure partie de cette différence.
- Filtrer le plus tôt possible. Appliquez un filtre à la projection la plus proche de la source. Filtrer après une agrégation signifie que l'ensemble des données a d'abord été agrégé, puis que la majeure partie a été écartée.
- Regroupez les données avant de les fusionner, dans la mesure du possible. Joindre deux grands ensembles de détails et les agréger ensuite déplace beaucoup plus de lignes que d'agréger d'abord chaque côté.
- Sélectionnez uniquement les colonnes dont vous avez besoin. Chaque colonne transmise par un nœud est conservée en mémoire pendant toute l'exécution, et les colonnes inutilisées bloquent l'élagage des nœuds.
- Privilégiez l'union à la jointure pour combiner des données similaires. L'empilement des données réelles et prévisionnelles correspond à une union. L'exprimer sous forme de jointure multiplie les lignes et nécessite ensuite un filtre pour corriger le problème.
- Surveillez la cardinalité de jointure. Déclarer 1..1 alors que les données sont de 1..N duplique les lignes et gonfle chaque mesure, ce qui est la cause la plus courante de totaux erronés.
- Évitez d'empiler les vues trop profondément. Une vue de calcul imbriquée dans une autre vue de calcul, elle-même imbriquée dans une vue analytique, est autorisée, mais difficile à optimiser et encore plus difficile à déboguer. Deux niveaux suffisent généralement.
Utilisez les outils d'analyse des performances de l'éditeur plutôt que de deviner. Planifiez.Viz indique quel nœud a consommé le temps, et la réponse est fréquemment un filtre placé un nœud trop tard. L'approche plus large est décrite dans le SAP Modélisation HANA tutoriel et alternatives procédurales dans Script SQL.
