
SAP HANA ArchiStructure : Aperçu de la base de données
 Maçon García
⚡ Résumé intelligent
SAP HANA ArchiLa structure, le paysage et le dimensionnement constituent le fondement d'une plateforme de données en mémoire construite sur SUSE Linux et C++Cet article explique le serveur d'index, les moteurs de stockage, le stockage par lignes et par colonnes, la fusion delta et les méthodes de dimensionnement matériel.
Qu'est-ce que le SAP Base de données HANA ?
SAP HANA est une plateforme de gestion de données centrée sur la mémoire principale. La base de données s'exécute sur SUSE Linux Enterprise Server (SLES) et Red Hat Enterprise Linux (RHEL) et est écrit en C++Il peut s'étendre sur plusieurs machines pour gérer des charges de travail très importantes.
Principaux avantages de SAP HANA :
- Performances de requête extrêmement rapides car toutes les données sont chargées en mémoire, éliminant ainsi les E/S disque lentes du chemin critique.
- Combinaison d'OLAP (traitement analytique en ligne) et d'OLTP (traitement transactionnel en ligne) sur la même base de données, simplifiant ainsi le paysage des données.
SAP La base de données HANA est constituée d'un ensemble de moteurs de traitement en mémoire. Le moteur de calcul est le moteur principal et interagit avec d'autres moteurs tels que le moteur relationnel (stockage par lignes et par colonnes), le moteur OLAP, le moteur de texte et le moteur de graphes. Une table relationnelle réside soit dans le stockage par lignes, soit dans le stockage par colonnes, et des moteurs supplémentaires traitent les données textuelles et graphiques en fonction de la mémoire disponible.
SAP HANA Architecture
Les données stockées dans la base de données en colonnes sont compressées à l'aide de techniques telles que l'encodage par dictionnaire, l'encodage par plage, l'encodage clairsemé, l'encodage par cluster et l'encodage indirect. Lorsque la limite de mémoire vive est atteinte, les objets de base de données inutilisés (tables, vues, etc.) sont automatiquement déchargés sur le disque et rechargés lors d'une nouvelle requête.
Les administrateurs peuvent également charger ou décharger manuellement une table individuelle en cliquant avec le bouton droit sur la table. SAP Studio Hana et en choisissant décharger or Charge.
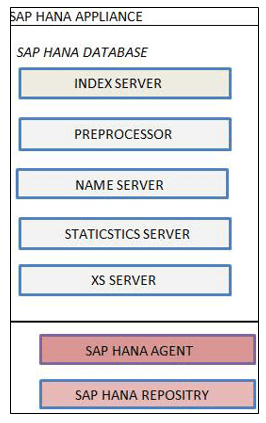
SAP Le serveur HANA se compose de :
- Serveur d'indexation
- Serveur de préprocesseur
- Nom du serveur
- Serveur de statistiques
- Moteur XS
1. SAP Serveur d'index HANA
Le serveur d'index est le principal SAP Composant de base de données HANA :
- C'est le cœur du SAP Moteur de base de données HANA.
- Il contient les bases de données proprement dites et les moteurs qui traitent ces données.
- Il exécute les instructions SQL et MDX entrantes.
L'architecture du serveur d'indexation est présentée ci-dessous.

SAP Présentation du serveur d'indexation HANA
- Gestionnaire de sessions et de transactions : Le composant Session gère les connexions et les sessions de la base de données. Le gestionnaire de transactions coordonne et contrôle toutes les transactions.
- Processeur SQL et MDX : Le processeur SQL envoie les requêtes au moteur approprié (SQL / SQL Script / R / moteur de calcul). Le processeur MDX traite les requêtes multidimensionnelles (par exemple, sur une vue analytique).
- SQL / Script SQL / R / Moteur Calc : Exécute des requêtes SQL, des scripts SQL, des modèles R et des modèles de calcul sur les données.
- Dépôt: Maintient le versionnage pour SAP Objets de métadonnées HANA tels que les vues d'attributs, les vues analytiques et les procédures stockées.
- Couche de persistance : Fournit une fonctionnalité intégrée de reprise après sinistre en écrivant des points de sauvegarde et des journaux sur le volume de données du disque.
2. Serveur de préprocesseur
Le serveur de prétraitement est utilisé par l'analyse de texte. Il extracts et prépare les données à partir du contenu textuel lorsque la fonction de recherche est invoquée.
3. Serveur de noms
Le serveur de noms contient des informations sur l'ensemble du paysage système. Dans un déploiement distribué, il tracks recense chaque composant en cours d'exécution et l'emplacement des données sur les différents nœuds, afin que les requêtes puissent être acheminées vers le serveur approprié.
4. Serveur de statistiques
Le serveur de statistiques collecte les données d'état, d'allocation des ressources, de consommation et de performance pour le SAP Système HANA. Remarque : dans HANA SPS 7 et versions ultérieures, le service de statistiques intégré s’exécute au sein du serveur d’index plutôt que comme un processus autonome.
5. Serveur XS
Le serveur XS héberge le moteur XS, qui permet aux applications externes et aux développeurs d'utiliser le SAP Base de données HANA via HTTP. Le moteur XS Engine fait office de serveur HTTP léger, permettant aux clients basés sur un navigateur et aux clients REST de communiquer directement avec HANA.
SAP Paysage HANA
« HANA » signifie Appareil analytique haute performance et est fournie sous la forme d'une plateforme matérielle et logicielle combinée.
- Le matériel moderne offre bien plus de cœurs de processeur, de RAM et de bande passante de stockage que ce pour quoi les serveurs de bases de données traditionnels ont été conçus.
- SAP HANA exploite cela en gardantping Toutes les données de travail sont stockées en mémoire principale, éliminant ainsi le goulot d'étranglement des entrées/sorties disque qui limite les bases de données traditionnelles.
Le diagramme ci-dessous résume SAP Innovations matérielles et logicielles HANA.

SAP HANA prend en charge deux magasins de données relationnels : Magasin en rangée et Magasin de colonnes.
Magasin en rangée
Row Store se comporte comme une base de données traditionnelle (Oracle, SQL Server). La principale différence réside dans le fait que toutes les lignes résident en mémoire vive dans SAP HANA, alors qu'une base de données traditionnelle les stocke principalement sur disque.
Magasin de colonnes
Column Store stocke les données en mémoire sous forme de colonnes. Les tables de colonnes y sont stockées et le moteur assure un bon équilibre entre performances d'écriture et performances de lecture optimisées. Le schéma ci-dessous illustre les deux structures qui permettent d'atteindre cet équilibre.

stockage principal
Le stockage principal contient la majeure partie des données. Des méthodes de compression telles que l'encodage par dictionnaire, l'encodage par cluster, l'encodage clairsemé et l'encodage par plage sont appliquées pour économiser de la mémoire et accélérer les recherches.
- La modification directe des données compressées dans le stockage principal est coûteuse, c'est pourquoi les écritures ne ciblent pas le stockage principal.
- Au lieu de cela, chaque modification est enregistrée dans une zone distincte appelée Delta Stockage Les lectures peuvent cibler soit le stockage principal, soit le stockage delta.
Les données peuvent être chargées ou déchargées manuellement à l'aide de Charger en mémoire et Décharger depuis la mémoire options présentées ci-dessous.

Delta Stockage
Delta Le stockage est optimisé pour les écritures et utilise une compression plus légère. Toutes les modifications non validées d'une table de colonnes sont conservées ici. Lorsque des modifications doivent être fusionnées avec le stockage principal, exécutez la commande suivante : Delta aller opération de SAP Hana Studio.

- La fusion delta déplace les modifications collectées dans le stockage delta vers le stockage principal.
- Après la fusion, le nouveau contenu du stockage principal est enregistré sur disque et la compression est recalculée.
Comment les données circulent depuis Delta vers le stockage principal

Un tampon organisé en lignes appelé L1-Delta elle se trouve devant chaque table de colonnes, ce qui explique pourquoi une table de colonnes peut absorber des écritures à haut débit.
- L'utilisateur exécute une requête UPDATE ou INSERT sur la table.
- Les données arrivent d'abord dans L1-Delta (données non validées).
- Une fois validées, les données sont déplacées vers le L2 orienté colonnes.Delta un tampon.
- Lorsque L2-Delta Si le stockage principal est plein ou si la fusion est en cours, les données sont écrites dans le stockage principal.
Le stockage par colonnes est donc optimisé à la fois pour l'écriture (via les blocs L1 et L2 delta) et pour la lecture (via le stockage principal). Après traitement, les données sont enregistrées sur disque par la couche de persistance.
Exemple de tableau organisé en lignes :

La même table logique est stockée sur disque différemment selon le type de stockage. En stockage par lignes, les lignes sont écrites de manière contiguë :

Dans Column Store, les valeurs d'une même colonne sont stockées ensemble :

Comme les valeurs des colonnes partagent le même type de données et se répètent souvent, la disposition en colonnes se compresse extrêmement bien, ce qui constitue le principal avantage en termes de mémoire du stockage en colonnes.

SAP Dimensionnement HANA
Le dimensionnement est le processus qui consiste à déterminer les ressources matérielles (RAM, disque et processeur) nécessaires à un système. SAP Système HANA. La mémoire est le facteur le plus important, le processeur vient en second, et le disque dépend des deux premiers.
Dans une SAP Lors de la mise en œuvre de HANA, le choix de la taille de serveur adaptée à la charge de travail métier est une tâche cruciale. Comparé à un SGBD traditionnel, le dimensionnement de HANA diffère sur trois points :
- Mémoire principale: piloté par les métadonnées et le volume de données transactionnelles et analytiques stockées en mémoire.
- CPU: Estimées plutôt que mesurées, sur la base des prévisions de requêtes et des modèles de charge.
- Disque: dimensionné pour la persistance des données et les volumes de journaux, et non pour les données de requêtes en ligne.
Le processeur et la mémoire du serveur d'applications restent inchangés par rapport à la base de données précédente, car HANA ne remplace que la couche de base de données.
SAP propose plusieurs méthodes pour calculer la taille correcte :
- Dimensionnement à l'aide d'un rapport ABAP (code de transaction) ST03 données et rapport /SDF/HDB_SIZING).
- Dimensionnement à l'aide d'un script de base de données pour les systèmes non-ABAP.
- dimensionnement à l'aide du SAP Quick Sizer outil sur le SAP Marché des services.
Lorsque l'outil Quick Sizer est utilisé, l'exigence s'affiche au format ci-dessous.

