
SAP DS (services de données) dans HANA
 Maçon García
⚡ Résumé intelligent
SAP Data Services est la plateforme ETL d'entreprise qui déplace et nettoie les données provenant de sources hétérogènes vers SAP HANA. Designer, Job Server, Engine, Repository et Access Server fonctionnent ensemble pour créer, planifier et exécuter des flux de données.
Qu'est-ce que le SAP Services de données ?
SAP Data Services est un outil ETL qui offre une solution unique au niveau de l'entreprise pour l'intégration, la transformation, la qualité, le profilage et le traitement des données textuelles provenant d'une source hétérogène vers une base de données cible ou un entrepôt de données.
Les applications, appelées tâches, sont créées dans le Designer, où les données sont mappées.ping et la transformation sont définies. Le produit est également appelé SAP BusinessObjects Data Services, abrégé en SAP BODS, et les deux noms désignent le même outil. SAP Data Services 4.3 est la version actuelle ; la version 4.2 a atteint la fin de sa maintenance principale le 31 mai 2023, les nouvelles implémentations doivent donc commencer sur la version 4.3.
Dans un SAP Paysage HANA, SAP Les services de données sont la solution privilégiée lorsque les données doivent être restructurées à leur arrivée plutôt que copiées telles quelles. Les sections ci-dessous décrivent les fonctionnalités de l'outil, son fonctionnement et un exemple complet de charge de travail. SAP Tableau ECC dans SAP HANA.
Caractéristiques SAP Services de données
Les fonctionnalités ci-dessous expliquent pourquoi SAP Data Services se positionne comme une plateforme de niveau entreprise plutôt que comme un simple utilitaire de copie.
- Il fournit des transformations parallèles hautes performances.
- Il dispose d'outils administratifs complets et d'un outil de reporting.
- Il prend en charge plusieurs utilisateurs.
- SAP CORPS est très flexible avec les applications basées sur les services Web.
- Il permet l'utilisation d'un langage de script doté d'un large éventail de fonctions.
- SAP Les services de données peuvent s'intégrer à SAP Serveur de réplication LT (SLT) SLT utilise une technologie basée sur le déclenchement. SLT ajoute des fonctionnalités delta à chaque SAP ou nonSAP table source, qui permet la capture des données modifiées et le transfert des données delta à partir de la table source.
- Validation des données avec tableaux de bord et audit des processus.
- Un outil d'administration doté de fonctionnalités de planification et de tableaux de bord de surveillance.
- Débogage, profilage intégré et visualisation des données.
- SAP Les services de données prennent en charge un large éventail de sources et de cibles :
- Toute application, par exemple SAP.
- Toute base de données, avec chargement en masse et capture des modifications de données.
- Fichiers : largeur fixe, délimités par des virgules, COBOL, XML et Excel.
Ces fonctionnalités sont assurées par un petit ensemble de composants installables, chacun ayant un rôle distinct.
Composants de SAP Services de données
SAP Les services de données comprennent les composants suivants.
- Créateur – Il s'agit d'un outil de développement permettant de créer, tester et exécuter une tâche alimentant un entrepôt de données. Il permet au développeur de créer des objets et de les configurer en sélectionnant une icône dans un diagramme de flux source-cible. Il peut être utilisé pour créer une application en spécifiant des flux de travail et des flux de données. Pour ouvrir Data Services Designer, accédez à Menu Démarrer -> Tous les programmes -> SAP Services de données -> Concepteur de services de données.

- Serveur de tâches – Il s'agit d'une application qui lance le moteur de traitement Data Services et sert d'interface entre ce moteur et la suite Data Services.
- Moteur – Le moteur Data Services exécute les tâches individuelles définies dans l'application.
- Dépôt – Le référentiel est une base de données qui stocke les objets prédéfinis par Designer et les objets définis par l'utilisateur (métadonnées source et cible, règles de transformation). Il existe deux types de référentiels :
- Dépôt local (utilisé par Designer et Job Server).
- Dépôt central (utilisé pour le partage d'objets et le contrôle de version).
- Serveur d'accès – Le serveur d'accès transmet les messages entre les applications Web, le serveur de tâches des services de données et les moteurs.
- Administratrice – L’administrateur Web permet l’administration des ressources des services de données via un navigateur, comme détaillé ci-dessous :
- Configuration, démarrage et arrêtping Services en temps réel.
- Planification, surveillance et exécution des tâches par lots.
- Configuration du serveur de tâches, du serveur d'accès et de l'utilisation du référentiel.
- Gestion des utilisateurs.
- Publication de traitements par lots et de services en temps réel via des services web.
- Configuration et gestion des adaptateurs.
Connaître le rôle de chaque composant ne représente que la moitié du tableau. L'architecture ci-dessous illustre leur communication lors d'une charge.
SAP Services de données Architecture
L'architecture des services de données comprend les composants suivants :
- Référentiel central – il est utilisé pour la configuration des référentiels des serveurs de tâches, la gestion de la sécurité, le contrôle de version et le partage d'objets.
- Concepteur – utilisé pour créer et exécuter un projet, une tâche, un flux de travail et un flux de données.
- Référentiel local – c’est ici que vous pouvez créer, modifier et démarrer des tâches, des flux de travail et des flux de données.
- Serveur et moteur de tâches – il gère les tâches.
- Serveur d'accès – il est utilisé pour exécuter les tâches en temps réel créées par les développeurs dans les référentiels.
L'image ci-dessous illustre les services de données et les relations entre leurs composants.

SAP CORPS Architecture
Détail de fenêtre design
Le concepteur est le composant sur lequel un développeur passe le plus de temps ; il est donc important d’en apprendre d’abord l’organisation. Le détail de chaque section du concepteur de services de données est présenté ci-dessous :
- Barre d'outils (utilisé pour Ouvrir, Enregistrer, Retour, Valider, Exécuter, etc.).
- Etendue du projet (Contient le projet actuel, qui comprend la tâche, le flux de travail et le flux de données. Dans Data Services, toutes les entités sont des objets).
- Espace de travail (la zone de la fenêtre d'application dans laquelle nous définissons, affichons et modifions les objets).
- Bibliothèque d'objets locale (il contient des objets de référentiel local, tels que des transformations, des tâches, des flux de travail, des flux de données, etc.).
- Palette d'outils (Les boutons de la palette d'outils vous permettent d'ajouter de nouveaux objets à l'espace de travail).

Hiérarchie des objets
Le diagramme ci-dessous illustre les relations hiérarchiques des principaux types d'objets au sein de Data Services.

À noter: La légende ci-dessous identifie les éléments optionnels de la hiérarchie.

Les flux de travail et les conditions sont facultatifs.
Les objets utilisés dans SAP Les services de données sont détaillés ci-dessous.
| Objets | Description |
|---|---|
| Projet | Un projet est l'objet de plus haut niveau dans la fenêtre du concepteur. Les projets permettent d'organiser les autres objets créés dans Data Services. Un seul projet est ouvert à la fois, c'est-à-dire visible dans la zone des projets. |
| Emploi | Un « travail » est la plus petite unité de travail que l’on peut planifier indépendamment pour son exécution. |
| Scripts | Un sous-ensemble de lignes dans une procédure. |
| Workflow | Un « flux de travail » est l’intégration de plusieurs flux de données en un déroulement cohérent pour l’ensemble d’une tâche. Un flux de travail est facultatif. Un flux de travail est une procédure qui peut :
|
| Flux de données | Un « flux de données » est le processus par lequel des données sources sont transformées en données cibles. Un flux de données est un objet réutilisable. Il est toujours appelé par un workflow ou une tâche. Il sert à :
|
| Datastore | Un canal logique qui connecte les services de données aux bases de données source et cible. Magasins de données :
|
| Target | La table ou le fichier dans lequel Data Services charge les données à partir de la source. |
SAP Services de données vs SLT vs DXC
SAP Data Services est l'un des nombreux fourniture de données options pour SAP HANA, et choisir la mauvaise méthode engendre des coûts irrécupérables, même avec des réglages optimisés. Le tableau ci-dessous compare les trois méthodes côté serveur.
| Critères | SAP Services de données | SLT | DXC |
|---|---|---|---|
| Latence | Par lots ou programmé | Temps réel | Traitement par lots, planifié par source de données |
| Transformation | ETL complet, nettoyage et profilage | Règles simples de filtrage et de champs | Aucun au-delà de extraclogique de tore |
| Étendue de la source | SAP et non-SAP, fichiers, applications | SAP et non-SAP bases de données | SAP Suite Business uniquement |
| Serveur supplémentaire requis | Oui, serveur de tâches | Généralement oui | Non |
| Meilleur adapté à | consolidation de la qualité des données et des sources multiples | Operareportages nationaux sur les données en direct | Réutilisation du contenu métier existant extracjeudi |
En bref, choisissez SAP Utilisez Data Services lorsque les données doivent être nettoyées, fusionnées ou normalisées avant leur intégration. Choisissez SLT lorsque le rapport doit refléter la transaction en temps réel. DXC lorsqu'un contenu d'entreprise éprouvé extractor produit déjà la sémantique dont vous avez besoin. Pour un ensemble de données ponctuel sans planification de répétition, un téléchargement de fichiers plats est plus rapide que de configurer l'une des trois.
Comment charger des données à partir d'un SAP Tableau source utilisant SAP Services de données
Dans Data Services, tout est objet. Un datastore distinct est nécessaire pour chaque base de données source et cible.
La séquence complète pour charger des données à partir d'un SAP Le tableau source est présenté ci-dessous. Chaque étape est ensuite détaillée.
- Créez un espace de stockage de données entre la source et BODS.
- Importez les métadonnées (structures) dans BODS
- Configurer le serveur d'importation
- Importez les métadonnées dans le système HANA
- Créer un datastore entre BODS et HANA
- Créer un projet
- Créer une tâche (par lots ou en temps réel)
- Créer un flux de travail
- Créer un flux de données
- Ajouter des objets au flux de données
- Exécuter le travail
- Vérifiez l'aperçu des données dans HANA
Étape 1) Créez un magasin de données entre les SAP source et BODS.
- Pour charger des données à partir d'un SAP source dans SAP HANA via SAP BODS nécessite un espace de stockage de données. Nous allons donc commencer par en créer un, comme indiqué ci-dessous : Projet → Nouveau → Espace de stockage de données

- Une fenêtre contextuelle « Créer un nouveau magasin de données » s’affichera. Saisissez les informations ci-dessous :
- Saisissez le nom du magasin de données « ds_ecc ».
- Sélectionnez le nom du type de magasin de données comme «SAP Applications".
- Saisissez le nom du serveur de base de données.
- Saisissez le nom d'utilisateur et le mot de passe.
- Cliquez sur le bouton «Appliquer».
- Cliquez sur le bouton «OK».

- Le magasin de données sera créé. Consultez le magasin de données créé ci-dessous.
- Accédez à la bibliothèque d'objets locale.
- Sélectionnez l'onglet Datastore.
- Le magasin de données « ds_ecc » sera affiché.

Étape 2) Importer les métadonnées (structure) dans le serveur BODS.
Nous avons créé un référentiel de données pour ECC vers BODS ; nous allons maintenant importer les métadonnées d'ECC dans BODS. Pour ce faire, suivez les étapes ci-dessous.
- Sélectionnez le magasin de données « ds_ecc » et cliquez avec le bouton droit.
- Sélectionnez l'option Importer par nom.

Une fenêtre contextuelle « Importer par nom » s’affichera. Saisissez les informations ci-dessous :
- Sélectionnez Type comme tableau.
- Saisissez le nom de la table à importer. Ici, nous importons la table KNA1.
- Cliquez sur le bouton « Importer ». La table KNA1 apparaîtra sous le nœud Table de la source de données « ds_ecc ».

Les métadonnées de la table seront importées dans le magasin de données ds_ecc comme indiqué ci-dessous.

Étape 3) Configurer le serveur d'importation.
Jusqu'à présent, nous avons importé une table dans le magasin de données « ds_ecc » créé pour ECC. SAP Connexion BODS. Pour importer des données dans SAP HANA, nous devons configurer le serveur d'importation.
- Pour ce faire, allez à Aperçu rapide -> Configurer le serveur d'importation comme ci-dessous.

- Une fenêtre contextuelle « Sélectionner le système » apparaîtra. Sélectionnez l'option correspondante. SAP Système HANA (HDB ici) comme ci-dessous.

- Cliquez sur le bouton « Suivant ». Une autre fenêtre contextuelle s’affichera pour vous demander vos identifiants de connexion aux services de données. Saisissez les informations suivantes :
- SAP Adresse du serveur BODS (ici BODS:6400).
- SAP Nom du dépôt BODS (nom du dépôt HANAUSER).
- Source de données ODBC (ZTDS_DS).
- Port par défaut pour le SAP Serveur BODS (8080).

Cliquez sur le bouton « Terminer ».
Étape 4) Importez les métadonnées dans le système HANA.
Le serveur d'importation est maintenant configuré, les métadonnées peuvent donc être importées depuis le SAP Serveur BODS.
- Cliquez sur l'option Importer dans l'aperçu rapide.
- Une fenêtre contextuelle affichant les options d'importation s'ouvrira. Sélectionnez l'option « Importation sélective des métadonnées ».

Cliquez sur le bouton "Suivant".
Une fenêtre contextuelle intitulée « Importation sélective des métadonnées » s'affichera, dans laquelle nous sélectionnerons le système cible.
- Sélectionnez le SAP Système HANA (HDB ici).

Cliquez sur le bouton "Suivant".
Étape 5) Créer un magasin de données entre BODS et HANA.
Dans BODS, un datastore distinct est nécessaire pour la source et la cible. Le datastore source existant déjà, un datastore cible entre BODS et HANA est ensuite créé sous le nom « DS_BODS_HANA ».
- Accédez à Projet -> Nouveau -> Banque de données.
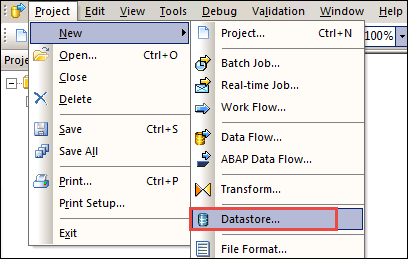
- L'écran « Créer un nouveau datastore » s'affichera comme ci-dessous.
- Saisissez le nom du datastore (DS_BODS_HANA).
- Saisissez « Base de données » comme type de stockage de données.
- Saisissez le type de base de données comme SAP HANA.
- Sélectionnez la version de la base de données.
- Entrer le SAP Nom du serveur de base de données HANA.
- Saisissez le nom du port pour le SAP Base de données HANA.
- Saisissez le nom d'utilisateur et le mot de passe.
- Cochez la case « Activer le transfert automatique des données ».

Cliquez sur « Appliquer », puis sur le bouton « OK ».
Le datastore « DS_BODS_HANA » sera affiché sous l’onglet Datastore de la bibliothèque d’objets locale, comme ci-dessous.

- Nous importons maintenant une table dans la base de données « DS_BODS_HANA ».
- Sélectionnez le datastore « DS_BODS_HANA » et cliquez avec le bouton droit.
- Sélectionnez Importer par nom.

- Une fenêtre contextuelle d'importation par nom apparaîtra comme ci-dessous.
- Sélectionnez Type comme tableau.
- Saisissez le nom KNA1.
- Le propriétaire sera affiché comme Hanauser.
- Cliquez sur le bouton Importer.

Le tableau sera importé dans la base de données « DS_BODS_HANA ». Pour consulter les données du tableau, suivez les étapes ci-dessous.
- Cliquez sur la table « KNA1 » dans le magasin de données « DS_BODS_HANA ».
- Les données seront affichées sous forme de tableau.

Étape 6) Définir le projet. Un projet regroupe et organise des objets liés. Un projet peut contenir un nombre quelconque de tâches, de flux de travail et de flux de données.
- Accédez au menu Projet du concepteur.
- Sélectionnez l'option Nouveau.
- Sélectionnez l'option Projet.

Une fenêtre contextuelle de création de projet s'affiche (voir ci-dessous). Saisissez le nom du projet et cliquez sur le bouton « Créer ». Un dossier de projet sera alors créé ; dans notre cas, il s'appellera BODS_DHK.

Étape 7) Définir le poste. Une tâche est un objet réutilisable. Elle contient des flux de travail et des flux de données. Les tâches peuvent être exécutées manuellement ou selon une planification. Pour exécuter un processus BODS, une tâche doit être définie.
Nous créons une tâche nommée JOB_Customer.
- Sélectionnez le projet (BODS_DHK) créé à l'étape précédente, cliquez avec le bouton droit et sélectionnez « Nouveau travail par lots ».
- Renommez-le en « JOB_Customer ».

Étape 8) Définir le flux de travail.
- Sélectionnez la tâche « JOB_Customer » dans la zone de projet.
- Cliquez sur le bouton « Flux de travail » dans la palette d’outils. Cliquez ensuite dans la zone de travail vide. Une icône de flux de travail apparaîtra alors dans l’espace de travail.
- Renommez le flux de travail en « WF_Customer ».

Cliquez sur le nom du flux de travail, et une vue vide de ce flux apparaît dans l'espace de travail.

Étape 9) Définir le flux de données.
- Cliquez sur le flux de travail « WF_Customer ».
- Cliquez sur le bouton Flux de données dans la palette d'outils. Cliquez sur la zone de travail vide. Une icône de flux de données apparaîtra dans l'espace de travail.
- Renommez le flux de données en « DF_Customer ».
- Le flux de données apparaît également dans la zone du projet, à gauche, sous le nom de la tâche.

Étape 10) Ajouter des objets au flux de données.
Dans le flux de données, nous fournissons des instructions pour transformer les données sources au format souhaité pour la table cible.
Trois objets sont utilisés :
- Un objet pour la source.
- Un objet pour la table cible.
- Un objet pour la transformation Query, qui mappe les colonnes de la source vers la cible.
Cliquez sur le flux de données DF_Customer. Un espace de travail vide apparaîtra comme ci-dessous.
- Spécifiez l'objet pour la source – Accédez à la base de données « ds_ecc », sélectionnez la table KNA1, puis faites-la glisser et déposez-la sur l’écran de flux de données vierge.
- Spécifiez l'objet cible – Sélectionnez le datastore « DS_BODS_HANA » dans le référentiel et sélectionnez la table KNA1.
- Faites glisser l'élément sur l'espace de travail et sélectionnez « Créer ». Target« option ». Il y aura désormais deux tables, une source et une cible.

- Transformation de requête – Cet outil permet de récupérer des données en fonction du schéma d'entrée pour une condition spécifique à l'utilisateur, et de transporter des données de la source vers la cible.
- Sélectionnez l'icône Transformation de requête dans la palette d'outils, puis faites-la glisser et déposez-la entre les objets source et cible dans l'espace de travail.
- Liez l'objet Query à la source.
- Liez l'objet Query à la table cible.

Double- Cliquez sur l'icône Requête pour mapper les colonnes du schéma d'entrée vers le schéma de sortie. Une carteping Une fenêtre apparaît, dans laquelle nous effectuons les opérations suivantes :
- La table source KNA1 est sélectionnée.
- Sélectionnez toutes les colonnes de la table source, cliquez avec le bouton droit et sélectionnez « Mapper vers la sortie ».
- Le format de sortie cible sélectionné est « Requête », et les colonnes seront mappées.

Enregistrez et validez le projet. Cliquez sur l'icône Valider. Une fenêtre contextuelle confirmant la réussite de la validation apparaît.

Étape 11) Exécuter la tâche. Pour exécuter la tâche, suivez le chemin ci-dessous.
- Sélectionnez l'icône de la zone de projet pour ouvrir le projet, puis sélectionnez le projet créé.
- Sélectionnez la tâche et faites un clic droit.
- Sélectionnez l'option Exécuter pour lancer la tâche.
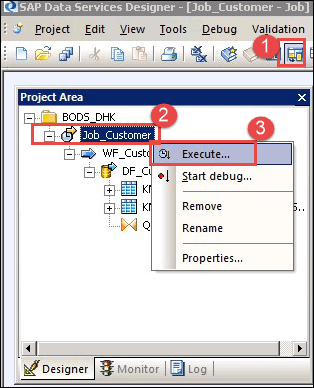
Une fois la tâche exécutée, une fenêtre de journalisation s'affiche, contenant tous les messages relatifs à la tâche. Le dernier message sera « Tâche terminée ». est terminé avec succès".

Étape 12) Validez et vérifiez les données dans le SAP Base de données HANA.
- Connectez-vous au SAP Base de données HANA via SAP Studio Hana, et sélectionnez le schéma HANAUSER.
- Sélectionnez la table KNA1 dans le nœud Table.
- Faites un clic droit sur le tableau KNA1 et sélectionnez Ouvrir l'aperçu des données.
- Les données KNA1 chargées par le processus BODS seront affichées dans l'écran d'aperçu des données.

La concordance du nombre de lignes entre la table source et cet aperçu confirme que le chargement s'est déroulé correctement, et la tâche peut alors être planifiée par l'administrateur pour des exécutions répétées.
