
Algorithme de tri rapide dans JavaScript avec exemple
 Équipe éditoriale
⚡ Résumé intelligent
Algorithme de tri rapide dans JavaCe script trie un tableau sur place en choisissant un pivot, en partitionnant les valeurs les plus petites à gauche et les plus grandes à droite, puis en répétant l'opération. Sa complexité moyenne est de O(n log n) et il est plus performant que la fonction intégrée `sort()` sur les grands ensembles de données numériques.
Qu'est-ce que le tri rapide ?
Tri rapide est un algorithme de tri par comparaison qui suit le Diviser et conquérir Cette approche consiste à sélectionner un élément comme pivot, à diviser le tableau en une partie contenant les valeurs inférieures au pivot et une partie contenant les valeurs supérieures, puis à appliquer la même procédure à chaque partie jusqu'à ce que le tableau entier soit ordonné.
Le tri rapide est l'un des algorithmes de tri les plus utilisés dans tous les langages de programmation. Si vous écrivez Javascénario, vous avez probablement déjà utilisé la fonction intégrée sorte() Vous vous demandez peut-être pourquoi il est utile d'apprendre à utiliser une implémentation distincte du tri rapide. Pour répondre à cette question, il faut d'abord comprendre ce que signifie le tri et quel est le tri par défaut. JavaLe script le fait effectivement.
Trois propriétés définissent le tri rapide :
- En place : il réorganise l'original tableau et n'alloue pas un deuxième tableau de même taille.
- Récursif : Chaque partition produit deux plages plus petites qui sont triées par la même fonction.
- Instable: Deux éléments ayant des clés identiques peuvent se retrouver dans un ordre relatif différent de celui dans lequel ils étaient au départ.
Qu'est-ce que le tri ?
Trier signifie organiser des éléments selon un ordre défini. Vous avez certainement déjà rencontré ce concept à l'école : classer les nombres du plus petit au plus grand est… ascendant ordonner, et les classer du plus grand au plus petit est descendant Le tri ne se limite pas aux nombres. Les chaînes de caractères peuvent être triées par ordre alphabétique, les dates par ordre chronologique et les objets selon n'importe quel critère de votre choix, comme le prix ou la note.
Le tri est important car des données ordonnées permettent des opérations plus rapides. Une recherche binaire s'exécute en O(log n), mais uniquement sur des données triées. La déduplication, les requêtes par intervalle, le classement et les opérations de fusion deviennent beaucoup plus rapides une fois les données triées ; c'est pourquoi chaque langage intègre au moins une fonction de tri.
Tri par défaut dans Javascénario
Comme mentionné précédemment, JavaLe script fournit sorte()Prenez un petit tableau comme [5,3,7,6,2,9] que vous souhaitez trier par ordre croissant. Appelez la fonction sorte() sur le tableau semble faire exactement cela.
La capture d'écran ci-dessus montre la console du navigateur affichant le tableau trié. Voici le même code :
var items = [5, 3, 7, 6, 2, 9];
console.log(items.sort());
Sortie :
[ 2, 3, 5, 6, 7, 9 ]
Ce résultat est correct, mais par pur hasard. La méthode Array.prototype.sort() convertit chaque élément en chaîne de caractères et compare ces chaînes. Sauf si vous fournissez une fonction de comparaison. Chaque valeur de ce tableau est un chiffre unique, l'ordre des chaînes de caractères correspond donc à l'ordre numérique. Modifiez les données et l'illusion disparaît.
var prices = [10, 9, 1, 100, 25];
console.log(prices.sort());                              // string comparison
console.log(prices.sort(function (a, b) { return a - b; })); // numeric comparison
Sortie :
[ 1, 10, 100, 25, 9 ]
[ 1, 9, 10, 25, 100 ]
⚠️ Attention : Ne jamais appeler sort() sur les nombres sans comparateur. « 100 » est trié avant « 25 » car le caractère « 1 » précède le caractère « 2 ». Toujours écrire sort((a, b) => a - b) pour les données numériques.
Quel algorithme utilise la fonction sort() ?
La spécification ne mentionne aucun algorithme ; chaque moteur choisit donc le sien. Les moteurs modernes utilisent tous un algorithme de fusion.
- V8 (Chrome, Edge, Node.js) a été utilisé TimSort depuis V8 7.0, livré avec Chrome 70.
- AraignéeSinge (Firefox) les usages tri par fusion.
- JavaScriptCore (Safari) utilise également tri par fusion.
Depuis ES2019, le langage garantit que sort() is stable, ce qui exclut un tri rapide simple au sein du moteur. Le tri par fusion nécessite O(n) de mémoire auxiliaire et doit appeler votre JavaUn comparateur de scripts pour chaque comparaison. Un tri rapide numérique écrit à la main compare directement les nombres et les trie sur place, ce qui lui permet de traiter efficacement de grands tableaux numériques. Le tri d'un million d'entiers aléatoires sur Node.js 22 a pris environ 100 ms avec le tri rapide ci-dessous et approximativement 210 ms au sort((a, b) => a - b).
Quick Sort mérite donc d'être lu si vous avez besoin d'un tri sur place, d'un contrôle précis de la mémoire ou tout simplement d'une bonne compréhension du fonctionnement du tri. Examinons ses mécanismes en détail.
Comment fonctionne le tri rapide ?
Le tri rapide répète une opération de base, appelée partitionnement, sur des plages de plus en plus petites. Voici les étapes à suivre :
- Découvrez pivot élément dans le tableau.
- Positionnez le pointeur gauche au premier élément de la plage.
- Placez le pointeur droit au dernier élément de la plage.
- Comparez l'élément pointé à gauche avec le pivot. S'il est inférieur au pivot, déplacez le pointeur gauche d'une position vers la droite. Continuez ainsi jusqu'à ce que l'élément de gauche soit supérieur ou égal au pivot.
- Comparez l'élément pointé à droite avec le pivot. S'il est supérieur au pivot, déplacez le pointeur de droite d'une position vers la gauche. Continuez ainsi jusqu'à ce que l'élément de droite soit inférieur ou égal au pivot.
- Si le pointeur de gauche est toujours inférieur ou égal au pointeur de droite, échangez les deux éléments.
- Incrémentez le pointeur gauche et décrémentez le pointeur droit.
- Si l'indice de gauche est toujours inférieur ou égal à l'indice de droite, répétez à partir de l'étape 4. Sinon, renvoyez l'indice du pointeur de gauche.
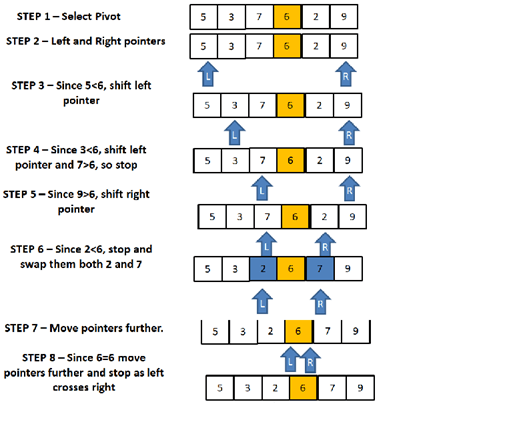
Le diagramme ci-dessus tracCes déplacements de pointeur sur un tableau d'exemple illustrent le fonctionnement de ce tableau. Chaque élément inférieur au pivot est placé à sa gauche, et chaque élément supérieur à sa droite, ce qui correspond exactement à l'indice renvoyé. La section suivante détaille ce même tableau étape par étape.
Comment déterminer l'élément pivot
Choisir le pivot est la décision cruciale qui distingue un tri rapide d'un tri lent. Si vous prenez toujours le premier Un élément, un tableau déjà trié produit la pire division possible : un côté vide et un côté contenant tous les éléments restants. Cela transforme l’algorithme en O(n²). En prenant le milieu L'élément (la longueur du tableau divisée par deux) évite ce piège pour les entrées triées et triées en sens inverse, c'est pourquoi le code ci-dessous l'utilise.
Stratégies de pivot courantes :
- Premier ou dernier élément : Le plus simple à coder, mais O(n²) sur des données triées.
- Élément intermédiaire : une bonne valeur par défaut qui gère les tableaux triés et triés en ordre inverse en O(n log n).
- Élément aléatoire : rend impossible la construction à l'avance des entrées du pire cas.
- Médiane de trois : prend la médiane des première, deuxième et dernière valeurs ; le choix standard dans les bibliothèques de production.
Examinons maintenant le tri rapide sur le tableau. [5,3,7,6,2,9].
ÉTAPE 1: Le pivot est l'élément central. Avec gauche = 0 et droite = 5, Math.floor((5 + 0) / 2) donne l'indice 2, donc la valeur pivot est 7.
ÉTAPE 2: Initialisez les pointeurs aux extrémités du tableau. Le pointeur de gauche se trouve à l'indice 0 (valeur). 5) et le pointeur droit se trouve à l'index 5 (valeur 9).
ÉTAPE 3: Comparer la valeur de gauche avec le pivot. 5 < 7, donc se déplacer vers la droite jusqu'à l'indice 1. 3 < 7, donc se déplacer vers la droite jusqu'à l'indice 2. La valeur à cet indice est 7, qui est supérieur ou égal au pivot, donc le pointeur de gauche s'arrête à l'indice 2.
ÉTAPE 4: Comparez la valeur de droite avec le pivot. 9 > 7, donc déplacez-vous à gauche jusqu'à l'indice 4. La valeur à cet indice est 2, qui n'est pas supérieure au pivot, donc le pointeur de droite s'arrête à l'indice 4.
ÉTAPE 5: L'indice de gauche (2) est inférieur ou égal à l'indice de droite (4), il faut donc inverser les deux valeurs. Le tableau devient alors : [5,3,2,6,7,9].
ÉTAPE 6: Déplacez les deux pointeurs d'un cran vers l'intérieur. Le pointeur de gauche se trouve maintenant à l'index 3 et le pointeur de droite à l'index 3.
ÉTAPE 7: Répétez l'analyse. La valeur à l'indice 3 est 6, et 6 < 7, donc le pointeur gauche se déplace à l'indice 4. La valeur à l'indice 3 n'est pas supérieure au pivot, donc le pointeur droit reste à l'indice 3.
ÉTAPE 8: L'indice de gauche (4) est maintenant supérieur à l'indice de droite (3), la boucle se termine donc et la fonction renvoie 4Tout ce qui précède l'indice 4 est inférieur ou égal au pivot, et tout ce qui suit l'indice 4 est supérieur ou égal à celui-ci.
D'après ce guide, vous avez besoin de code pour deux opérations : échangerping deux éléments et partitionnement d'une plage.
Code échanger deux Numbers in Javascénario
Comme le montre la capture d'écran de l'éditeur ci-dessus, la fonction d'échange utilise une variable temporaire pour permuter les valeurs à deux index. Elle modifie directement le tableau et ne renvoie rien.
function swap(items, leftIndex, rightIndex) {
    var temp = items[leftIndex];
    items[leftIndex] = items[rightIndex];
    items[rightIndex] = temp;
}

var demo = [5, 3, 7, 6, 2, 9];
swap(demo, 0, 5);
console.log(demo);
Sortie :
[ 9, 3, 7, 6, 2, 5 ]
Astuce : Moderne JavaLe script peut effectuer un échange sans variable temporaire grâce à la déstructuration de tableau : [items[i], items[j]] = [items[j], items[i]];Le code est plus lisible, même si la fonction d'assistance explicite est légèrement plus rapide dans les boucles critiques car elle évite l'allocation d'un tableau temporaire.
Code pour effectuer le partage
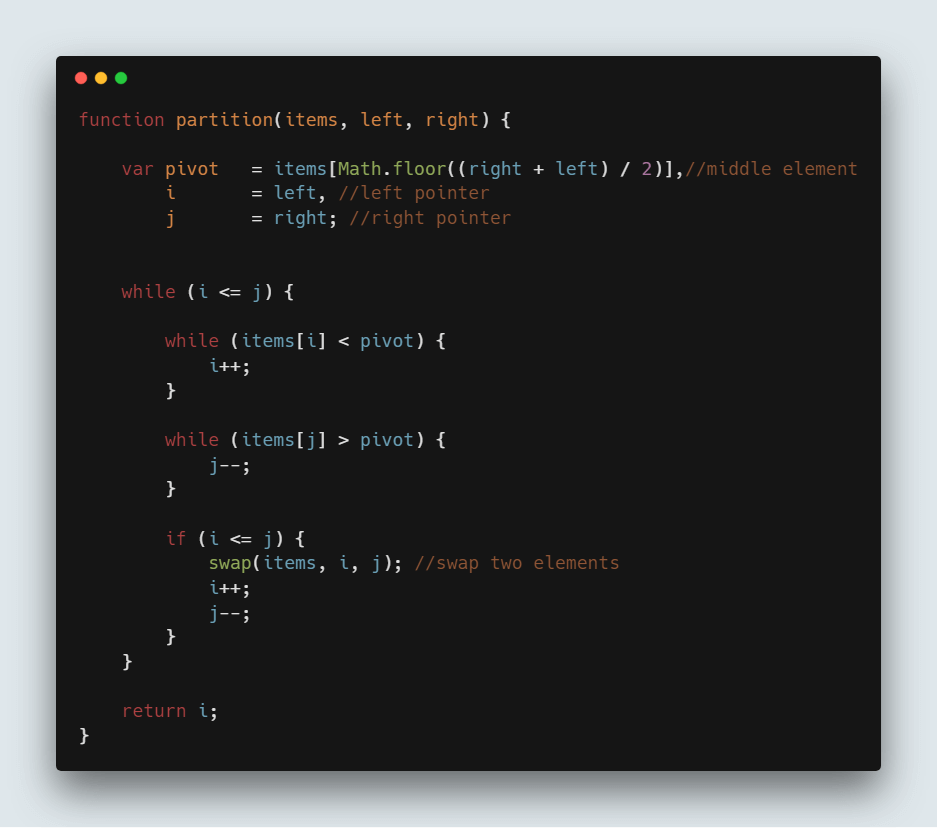
Le code de la capture d'écran ci-dessus transforme les étapes 1 à 8 en une fonction. Les deux fonctions internes boucles faire avancer les pointeurs, le if Le bloc effectue l'échange, et la fonction renvoie l'indice de séparation.
function partition(items, left, right) {
    var pivot   = items[Math.floor((right + left) / 2)], // middle element
        i       = left,  // left pointer
        j       = right; // right pointer
    while (i <= j) {
        while (items[i] < pivot) {
            i++;
        }
        while (items[j] > pivot) {
            j--;
        }
        if (i <= j) {
            swap(items, i, j); // swap two elements
            i++;
            j--;
        }
    }
    return i;
}

var items = [5, 3, 7, 6, 2, 9];
var index = partition(items, 0, items.length - 1);
console.log(items);
console.log(index);
Sortie :
[ 5, 3, 2, 6, 7, 9 ]
4
Le résultat correspond exactement à la procédure manuelle : après un passage de partition, le tableau est [5,3,2,6,7,9] et l'indice de division renvoyé est 4.
Effectuer la récursivité Operaproduction
Une fois l'indice de partitionnement obtenu, utilisez-le pour diviser l'intervalle et effectuez un tri rapide sur chaque moitié. C'est pourquoi on parle d'un algorithme de type « diviser pour régner ». La récursivité se poursuit jusqu'à ce que chaque sous-intervalle contienne un seul élément, auquel cas le tableau entier est trié.
À noter: Le tri rapide s'effectue sur le même tableau tout au long du processus. Aucun nouveau tableau n'est créé, ce qui en fait un algorithme en place.
Donc vous appelez le cloison() La fonction expliquée ci-dessus et utilisez sa valeur de retour pour diviser le tableau en plusieurs parties. Voici le code qui le fait :
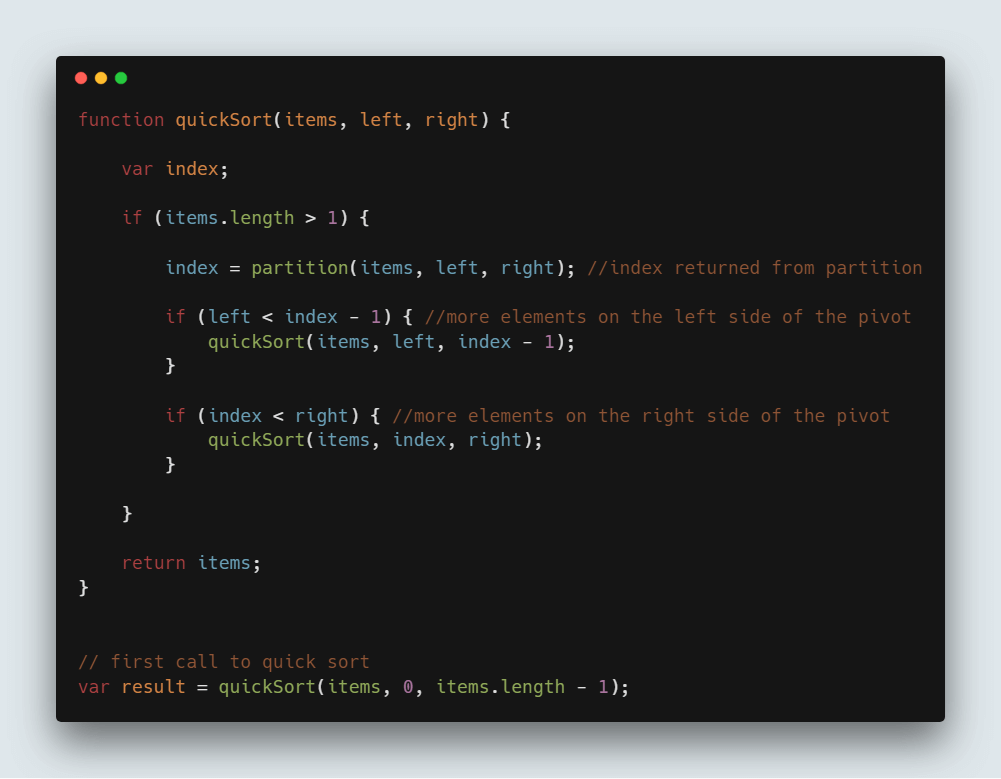
Notez les deux conditions de garde mises en évidence dans la capture d'écran. left < index - 1 confirme qu'au moins deux éléments restent sur le côté gauche, et index < right Cela confirme la même chose pour le côté droit. Sans ces gardes, la fonction s'appellerait indéfiniment sur des plages d'éléments uniques.
function quickSort(items, left, right) {
    var index;
    if (items.length > 1) {
        index = partition(items, left, right); // index returned from partition
        if (left < index - 1) { // more elements on the left side of the pivot
            quickSort(items, left, index - 1);
        }
        if (index < right) { // more elements on the right side of the pivot
            quickSort(items, index, right);
        }
    }
    return items;
}

// first call to quick sort
var items = [5, 3, 7, 6, 2, 9];
var result = quickSort(items, 0, items.length - 1);
console.log(result);
Sortie :
[ 2, 3, 5, 6, 7, 9 ]
Tri rapide complet Code
L'assemblage des éléments d'échange, de partitionnement et de récursion donne l'implémentation complète :
var items = [5, 3, 7, 6, 2, 9];

function swap(items, leftIndex, rightIndex) {
    var temp = items[leftIndex];
    items[leftIndex] = items[rightIndex];
    items[rightIndex] = temp;
}

function partition(items, left, right) {
    var pivot   = items[Math.floor((right + left) / 2)], // middle element
        i       = left,  // left pointer
        j       = right; // right pointer
    while (i <= j) {
        while (items[i] < pivot) {
            i++;
        }
        while (items[j] > pivot) {
            j--;
        }
        if (i <= j) {
            swap(items, i, j); // swapping two elements
            i++;
            j--;
        }
    }
    return i;
}

function quickSort(items, left, right) {
    var index;
    if (items.length > 1) {
        index = partition(items, left, right); // index returned from partition
        if (left < index - 1) { // more elements on the left side of the pivot
            quickSort(items, left, index - 1);
        }
        if (index < right) { // more elements on the right side of the pivot
            quickSort(items, index, right);
        }
    }
    return items;
}

// first call to quick sort
var sortedArray = quickSort(items, 0, items.length - 1);
console.log(sortedArray);
Sortie :
[ 2, 3, 5, 6, 7, 9 ]

La capture d'écran ci-dessus montre le programme complet dans l'éditeur, ainsi que le tableau trié affiché dans la console. Cette implémentation a été testée avec un tableau déjà trié, un tableau trié en sens inverse, des tableaux contenant des doublons et des valeurs identiques, des nombres négatifs, un élément unique et un tableau vide ; elle renvoie le résultat attendu dans tous les cas.
Astuce : Le garde if (items.length > 1) vérifie la longueur de l'ensemble du tableau plutôt que celle de la plage actuelle. Cela fonctionne ici car les deux appels récursifs sont déjà protégés par left < index - 1 et index < right, mais if (left >= right) { return items; } est la condition la plus claire et la plus sûre pour écrire du nouveau code.
Complexité temporelle et spatiale du tri rapide
Chaque partition parcourt chaque élément de l'intervalle une fois, donc une seule passe coûte O(n). Le coût total dépend donc du nombre de partitions possibles du tableau avant que les intervalles ne deviennent triviaux.
| Témoignage client | Complexité temporelle | Quand ça arrive |
|---|---|---|
| Meilleur | O (n log n) | Chaque pivot divise sa plage de fonctionnement en deux moitiés de taille égale. |
| Normale | O (n log n) | Entrée ordonnée aléatoirement avec une règle de pivot raisonnable. |
| pire | O(n²) | Chaque pivot correspond à la valeur minimale ou maximale, ce qui donne n niveaux de récursion. |
La complexité spatiale est O(log n) Dans cette version en place, aucun second tableau n'est alloué ; la seule mémoire supplémentaire est donc la pile de récursion, et le fractionnement équilibré maintient cette pile à une profondeur d'environ log₂(n) cadres. Dans le pire des cas, la pile atteint O(n) cadres, ce qui explique pourquoi les très grands tableaux peuvent saturer la pile d'appels.
Deux chiffres le confirment. Le tri de 4 096 valeurs aléatoires avec le code ci-dessus a nécessité environ 65 000 comparaisons, contre un nombre théorique de comparaisons (n·log₂(n)) de 49 152. La récursion la plus profonde a atteint 24 images, tandis que log₂(4 096) vaut 12. Ces deux valeurs se situent dans la plage de constantes attendue pour un algorithme en O(n log n).
⚠️ Attention : L'affirmation selon laquelle Quick Sort est simplement un algorithme en O(n log n) est incomplète. Sa complexité dans le pire des cas est en O(n²), et un pivot naïf sur le premier élément atteint précisément ce pire cas avec les données d'entrée les plus susceptibles d'être reçues en production : des données déjà triées.
Tri rapide vs autres méthodes de tri Algorithms
Le tri rapide est rarement la seule option. Le tableau ci-dessous le compare aux autres algorithmes les plus courants, afin de vous aider à choisir celui qui convient le mieux à vos données.
| Algorithme | Meilleur | Normale | pire | évenementiels | Stable |
|---|---|---|---|---|---|
| Tri rapide | O (n log n) | O (n log n) | O(n²) | O (log n) | Non |
| Tri par fusion | O (n log n) | O (n log n) | O (n log n) | O (n) | Oui |
| Tri de tas | O (n log n) | O (n log n) | O (n log n) | O (1) | Non |
| Tri par insertion | O (n) | O(n²) | O(n²) | O (1) | Oui |
| Bubble Trier | O (n) | O(n²) | O(n²) | O (1) | Oui |
| Tri de sélection | O(n²) | O(n²) | O(n²) | O (1) | Non |
En pratique, le tri rapide est généralement préférable car sa boucle interne est compacte et il fonctionne sur des plages contiguës optimisées pour le cache. Choisissez le tri fusion lorsque vous avez besoin d'une complexité garantie en O(n log n) ou d'un ordre stable, le tri par tas lorsque la mémoire est extrêmement limitée, et le tri par insertion pour les tableaux très petits ou presque triés. Les bibliothèques de production les combinent fréquemment : introsort commence par le tri rapide, passe au tri par tas si la récursion devient trop profonde, et termine par le tri par insertion sur les petites plages.
Comment trier rapidement des objets et des chaînes de caractères
L'implémentation présentée jusqu'à présent compare les valeurs avec < et >ce qui le limite aux nombres. Les applications réelles ont besoin de trier objets par propriété, par ordre alphabétique des chaînes de caractères ou par ordre chronologique des dates. La solution consiste à déplacer la comparaison dans une fonction de rappel, exactement comme le fait la fonction intégrée. sort() t.
Un comparateur reçoit deux valeurs et renvoie un nombre négatif si la première valeur doit précéder la seconde, un nombre positif si les deux valeurs doivent précéder la seconde, et zéro si elles sont égales. En remplaçant les deux comparaisons codées en dur par des appels au comparateur, l'algorithme fonctionne avec n'importe quel type de données.
function swap(items, i, j) {
    var temp = items[i];
    items[i] = items[j];
    items[j] = temp;
}

function partition(items, left, right, compare) {
    var pivot = items[Math.floor((right + left) / 2)],
        i     = left,
        j     = right;
    while (i <= j) {
        while (compare(items[i], pivot) < 0) { i++; }
        while (compare(items[j], pivot) > 0) { j--; }
        if (i <= j) {
            swap(items, i, j);
            i++;
            j--;
        }
    }
    return i;
}

function quickSort(items, left, right, compare) {
    if (left >= right) { return items; } // nothing left to split
    var index = partition(items, left, right, compare);
    if (left < index - 1) { quickSort(items, left, index - 1, compare); }
    if (index < right) { quickSort(items, index, right, compare); }
    return items;
}

function sort(items, compare) {
    compare = compare || function (a, b) { return a < b ? -1 : a > b ? 1 : 0; };
    return quickSort(items, 0, items.length - 1, compare);
}

var numbers = [10, 9, 1, 100, 25];
console.log(sort(numbers, function (a, b) { return a - b; }));

var names = ["Priya", "arun", "Bala", "chetan"];
console.log(sort(names, function (a, b) {
    return a.toLowerCase().localeCompare(b.toLowerCase());
}));

var employees = [
    { name: "Arun",   salary: 52000 },
    { name: "Bala",   salary: 41000 },
    { name: "Chetan", salary: 68000 }
];
console.log(sort(employees, function (a, b) { return a.salary - b.salary; }));
Sortie :
[ 1, 9, 10, 25, 100 ]
[ 'arun', 'Bala', 'chetan', 'Priya' ]
[
  { name: 'Bala', salary: 41000 },
  { name: 'Arun', salary: 52000 },
  { name: 'Chetan', salary: 68000 }
]
Trois détails méritent d'être soulignés. La protection contre la récursivité est désormais activée. left >= right, ce qui est correct pour toute plage et ne dépend pas de la longueur du tableau externe. La comparaison de chaînes utilise localeCompare() Ainsi, les caractères accentués et la casse sont correctement gérés, et non par un simple point de code. De plus, comme le tri rapide n'est pas stable, les enregistrements ayant le même salaire peuvent être intervertis ; triez par une seconde clé de départage si l'ordre initial est important pour vous.
Prêt à continuer ? Renforcez vos fondamentaux avec le JavaIntroduction au scénario, pratiquez la mécanique du pointeur dans Javaboucles de script, travaillez davantage pratique JavaExemples de code de script, comparez les implémentations dans Tri par insertion et Tri de tas, ou ajoutez des types statiques à cet algorithme avec le TypeScript référence.
