
Python Fichier XML – Comment lire, écrire et analyser
 Anna Blake
⚡ Résumé intelligent
Python Le traitement XML permet de lire, d'écrire et d'analyser des documents XML à l'aide des modules intégrés minidom et ElementTree. La classe minidom charge un fichier en mémoire sous forme de DOM, tandis qu'ElementTree offre une solution plus rapide et plus performante. PythonAPI d'arbre ic.
Les sections ci-dessous traitent de l'analyse, de l'écriture et de la lecture des fichiers XML. Python.
Qu'est-ce que XML?
XML signifie eXtensible Markup Language. Il a été conçu pour stocker et transporter des quantités petites à moyennes de données et est largement utilisé pour partager des informations structurées.
Python permet d'analyser et de modifier des documents XML. Pour analyser un document XML, il est nécessaire de le charger intégralement en mémoire. Dans ce tutoriel, nous verrons comment utiliser la classe XML minidom. Python pour charger et analyser des fichiers XML.
Comment analyser XML à l'aide de minidom
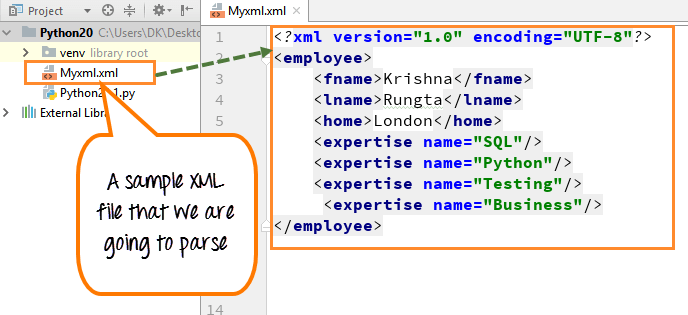
Nous avons créé un exemple de fichier XML que nous allons analyser.
Étape 1) Créer un exemple de fichier XML
À l'intérieur du fichier, nous pouvons voir le prénom, le nom, le domicile et le domaine d'expertise (SQL, Python, Tests et Affaires).
Étape 2) Utilisez la fonction d'analyse pour charger et analyser le fichier XML
Une fois le document analysé, nous afficherons le nom du nœud racine et le nom de la première balise enfant. Ces propriétés sont standard pour un fichier XML.
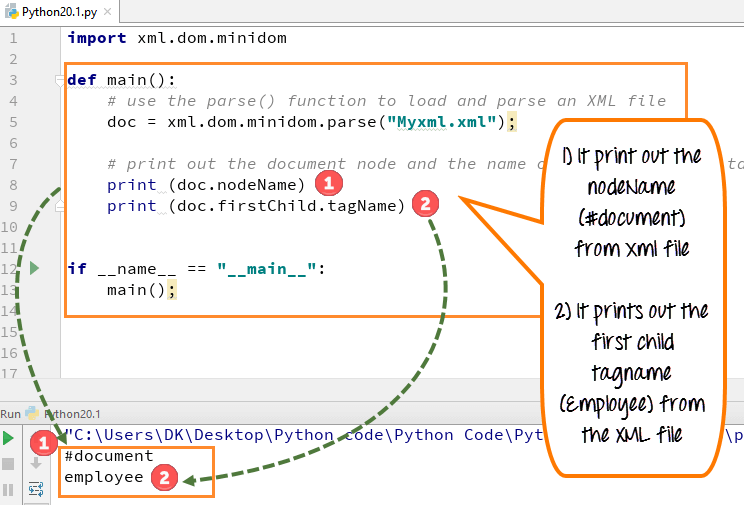
- Importez le module xml.dom.minidom et déclarez le fichier à analyser (myxml.xml).
- Ce fichier contient des informations de base sur un employé comme son prénom, son nom, son domicile, son expertise, etc.
- Nous utilisons la fonction parse sur le minidom XML pour charger et analyser le fichier XML
- Nous avons une variable doc, et doc reçoit le résultat de la fonction parse
- Nous souhaitons imprimer le nom du nœud et le nom de l'étiquette enfant à partir du fichier, nous le déclarons donc dans la fonction d'impression
- Exécutez le code : il imprime le nom du nœud (#document) du fichier XML et le premier nom de balise enfant (employé) du fichier XML.
NoteNodename et child tagname sont les noms ou propriétés standard d'un DOM XML.
Étape 3) Récupérez la liste des balises XML à partir du document XML et imprimez-la.
Ensuite, nous pouvons également récupérer la liste des balises XML à partir du document XML et l'afficher. Ici, nous avons affiché l'ensemble des compétences telles que SQL, Python, Tests et Affaires.

- Déclarez la variable expertise, à partir de laquelle nous allons extractoute l'expertise que l'employé possède
- Utilisez la fonction standard dom appelée « getElementsByTagName »
- Cela obtiendra tous les éléments nommés compétence
- Déclarez une boucle sur chacune des étiquettes de compétence
- Exécutez le code ; il vous donnera une liste de quatre compétences
Comment écrire un nœud XML
Nous pouvons créer un nouvel attribut en utilisant la fonction « createElement », puis ajouter ce nouvel attribut ou balise aux balises XML existantes. Nous avons ajouté une nouvelle balise « BigData » dans notre fichier XML.
- Vous devez écrire du code pour ajouter le nouvel attribut (BigData) à la balise XML existante.
- Ensuite, vous devez imprimer la balise XML avec le nouvel attribut ajouté à la balise XML existante.
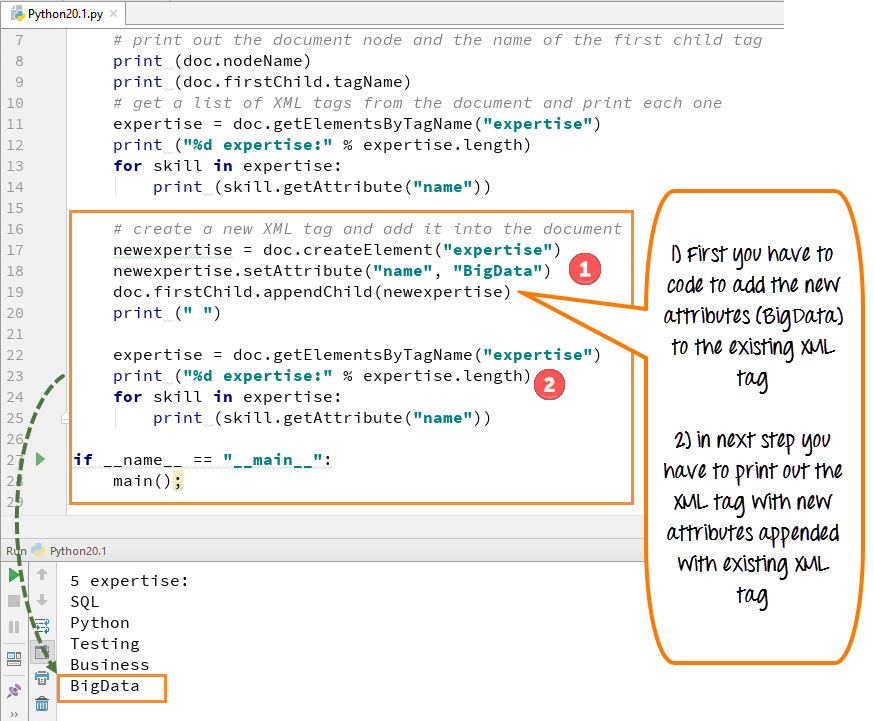
- Pour ajouter une nouvelle balise XML et l'intégrer au document, nous utilisons le code « doc.createElement ».
- Ce code créera une nouvelle étiquette de compétence pour notre nouvel attribut « BigData ».
- Ajoutez cette balise de compétence au premier élément enfant du document (employé).
- Exécutez le code : la nouvelle étiquette « Big Data » apparaîtra avec l’autre liste d’expertises.
Exemple d'analyseur XML
Python 2 Exemple
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Exemple
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Comment analyser XML à l'aide d'ElementTree
ElementTree est une API permettant de manipuler des fichiers XML. ElementTree est un moyen simple de traiter ces fichiers.
Nous utilisons le document XML suivant comme exemple de données :
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Lecture de XML à l'aide d'ElementTree :
Nous devons d'abord importer le module xml.etree.ElementTree.
import xml.etree.ElementTree as ET
Récupérons maintenant l'élément racine :
root = tree.getroot()
Voici le code complet permettant de lire les données XML ci-dessus :
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Sortie :
Expertise Data:
SQL
Python
