
Différence entre l'apprentissage automatique et l'apprentissage en profondeur
 Équipe éditoriale
Différence clé entre l'apprentissage automatique et l'apprentissage profond
Les principales différences entre le Machine Learning et le Deep Learning sont :
- Le Machine Learning offre d'excellentes performances sur un ensemble de données petit/moyen, tandis que le Deep Learning offre d'excellentes performances sur un grand ensemble de données.
- ML fonctionne sur une machine bas de gamme, tandis que DL nécessite une machine puissante, de préférence avec GPU.
- Le temps d'exécution du Machine Learning varie de quelques minutes à quelques heures, tandis que le Deep Learning prend jusqu'à plusieurs semaines.
- Avec l’apprentissage automatique, vous avez besoin de moins de données pour entraîner l’algorithme qu’avec l’apprentissage profond. L’apprentissage profond nécessite un ensemble de données étendu et diversifié pour identifier la structure sous-jacente.

Qu'est-ce que l'IA?
IA (Intelligence Artificielle) est une branche de l'informatique dans laquelle les machines sont programmées et dotées d'une capacité cognitive pour penser et imiter des actions comme les humains et les animaux. La référence en matière d’IA est l’intelligence humaine en matière de raisonnement, de parole, d’apprentissage, de vision et de résolution de problèmes, ce qui est encore loin dans le futur.
L'IA a trois niveaux différents
1) IA étroite: Une intelligence artificielle est dite étroite lorsque la machine peut mieux accomplir une tâche spécifique qu’un humain. La recherche actuelle sur l'IA est là maintenant
2) IA générale: Une intelligence artificielle atteint l’état général lorsqu’elle peut effectuer n’importe quelle tâche intellectuelle avec le même niveau de précision qu’un humain.
3) IA active: Une IA est active lorsqu'elle peut battre les humains dans de nombreuses tâches
Les premiers systèmes d'IA utilisaient la correspondance de modèles et systèmes experts.

Qu'est-ce que l'apprentissage automatique (ML)?
ML (Machine Learning) est un type d'IA dans lequel un ordinateur est entraîné à automatiser des tâches exhaustives ou impossibles pour les êtres humains. C'est le meilleur outil pour analyser, comprendre et identifier des modèles de données sur la base de l'étude d'algorithmes informatiques. L'apprentissage automatique peut prendre des décisions avec une intervention humaine minimale.
Comparaison Intelligence Artificielle Par rapport au Machine Learning, le Machine Learning utilise des données pour alimenter un algorithme capable de comprendre la relation entre l’entrée et la sortie. Une fois l’apprentissage terminé, la machine peut prédire la valeur ou la classe d’un nouveau point de données.
Qu'est-ce que le Deep Learning (DL) ?
L'apprentissage profond est un logiciel informatique qui imite le réseau de neurones d'un cerveau. Il s’agit d’un sous-ensemble de l’apprentissage automatique appelé apprentissage profond car il utilise des réseaux neuronaux profonds. La machine utilise différentes couches pour apprendre des données. La profondeur du modèle est représentée par le nombre de couches du modèle. L’apprentissage profond est le nouvel état de l’art en matière d’IA. En deep learning, la phase d’apprentissage se fait via un réseau de neurones. Un réseau de neurones est une architecture où les couches sont empilées les unes sur les autres

Différence entre l'apprentissage automatique et l'apprentissage profond
Vous trouverez ci-dessous une différence clé entre le Deep Learning et le Machine Learning
| Paramètres | Machine Learning | L'apprentissage en profondeur |
|---|---|---|
| Dépendances des données | Excellentes performances sur un jeu de données petit/moyen | Excellentes performances sur un grand ensemble de données |
| Dépendances matérielles | Travailler sur une machine bas de gamme. | Nécessite une machine puissante, de préférence avec GPU : DL effectue une quantité importante de multiplication matricielle |
| Ingénierie des fonctionnalités | Besoin de comprendre les fonctionnalités qui représentent les données | Pas besoin de comprendre la meilleure fonctionnalité qui représente les données |
| Temps d'exécution | De quelques minutes à quelques heures | Jusqu'à des semaines. Le réseau de neurones doit calculer un nombre important de poids |
| Interprétabilité | Certains algorithmes sont faciles à interpréter (logistique, arbre de décision), d'autres sont quasiment impossibles (SVM, XGBoost) | Difficile voire impossible |
Quand utiliser ML ou DL ?
Dans le tableau ci-dessous, nous résumons la différence entre machine learning et l'apprentissage en profondeur avec des exemples.
| Paramètres | Machine Learning | L'apprentissage en profondeur |
|---|---|---|
| Ensemble de données d'entraînement | petit | Grande |
| Choisissez les fonctionnalités | Oui | Non |
| Nombre d'algorithmes | Merci beaucoup | Peu |
| Temps de formation | Court | Long |
Avec l’apprentissage automatique, vous avez besoin de moins de données pour entraîner l’algorithme qu’avec l’apprentissage profond. L’apprentissage profond nécessite un ensemble de données étendu et diversifié pour identifier la structure sous-jacente. En outre, l’apprentissage automatique fournit un modèle formé plus rapidement. La formation de l’architecture d’apprentissage profond la plus avancée peut prendre de plusieurs jours à une semaine. L’avantage du deep learning par rapport au machine learning est qu’il est très précis. Vous n'avez pas besoin de comprendre quelles fonctionnalités constituent la meilleure représentation des données ; le réseau neuronal a appris à sélectionner les fonctionnalités critiques. En apprentissage automatique, vous devez choisir vous-même les fonctionnalités à inclure dans le modèle.

Processus d'apprentissage automatique
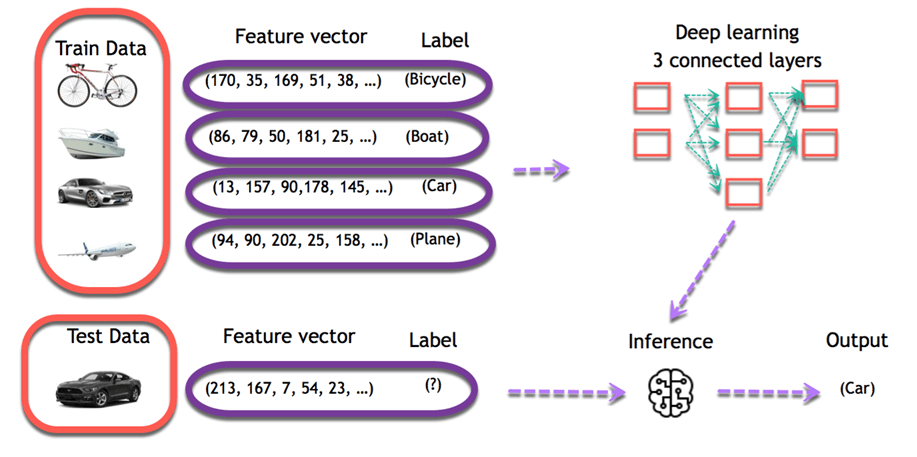
Imaginez que vous êtes censé créer un programme qui reconnaît les objets. Pour entraîner le modèle, vous utiliserez un classificateur. Un classificateur utilise les caractéristiques d'un objet pour tenter d'identifier la classe à laquelle il appartient.
Dans l'exemple, le classificateur sera entraîné à détecter si l'image est un :
- Vélo
- Bateau
- Voiture
- avion
Les quatre objets ci-dessus constituent la classe que le classificateur doit reconnaître. Pour construire un classificateur, vous devez disposer de certaines données en entrée et leur attribuer une étiquette. L’algorithme va prendre ces données, trouver un modèle puis le classer dans la classe correspondante.
Cette tâche s'appelle enseignement supervisé. Dans l'apprentissage supervisé, les données d'entraînement que vous fournissez à l'algorithme incluent une étiquette.
Entraîner un algorithme nécessite de suivre quelques étapes standards :
- Collectez les données
- Former le classificateur
- Faire des prédictions
La première étape est nécessaire, choisir les bonnes données fera le succès ou l’échec de l’algorithme. Les données que vous choisissez pour entraîner le modèle sont appelées un . Dans l'exemple d'objet, les caractéristiques sont les pixels des images.
Chaque image est une ligne dans les données tandis que chaque pixel est une colonne. Si votre image est au format 28×28, l’ensemble de données contient 784 colonnes (28×28). Dans l'image ci-dessous, chaque image a été transformée en vecteur de caractéristiques. L'étiquette indique à l'ordinateur quel objet se trouve dans l'image.

L'objectif est d'utiliser ces données d'entraînement pour classer le type d'objet. La première étape consiste à créer les colonnes de fonctionnalités. Ensuite, la deuxième étape consiste à choisir un algorithme pour entraîner le modèle. Une fois la formation terminée, le modèle prédira quelle image correspond à quel objet.
Après cela, il est facile d’utiliser le modèle pour prédire de nouvelles images. Pour chaque nouvelle image introduite dans le modèle, la machine prédira à quelle classe elle appartient. Par exemple, une toute nouvelle image sans étiquette traverse le modèle. Pour un être humain, il est trivial de visualiser l’image d’une voiture. La machine utilise ses connaissances antérieures pour prédire également que l'image est une voiture.
Processus d'apprentissage profond
En deep learning, la phase d’apprentissage se fait via un réseau de neurones. Un réseau de neurones est une architecture dans laquelle les couches sont empilées les unes sur les autres.
Considérez le même exemple d’image ci-dessus. L'ensemble de formation serait transmis à un réseau de neurones
Chaque entrée va dans un neurone et est multipliée par un poids. Le résultat de la multiplication passe à la couche suivante et devient l'entrée. Ce processus est répété pour chaque couche du réseau. La couche finale est appelée couche de sortie ; il fournit une valeur réelle pour la tâche de régression et une probabilité de chaque classe pour la tâche de classification. Le réseau de neurones utilise un algorithme mathématique pour mettre à jour les poids de tous les neurones. Le réseau de neurones est pleinement entraîné lorsque la valeur des poids donne un résultat proche de la réalité. Par exemple, un réseau neuronal bien entraîné peut reconnaître l’objet sur une image avec une précision supérieure à celle du réseau neuronal traditionnel.
Automatisation des fonctionnalités Extraction utilisant DL
Un ensemble de données peut contenir une douzaine à des centaines d’entités. Le système apprendra de la pertinence de ces fonctionnalités. Cependant, toutes les fonctionnalités ne sont pas significatives pour l’algorithme. Une partie cruciale de l’apprentissage automatique consiste à trouver un ensemble pertinent de fonctionnalités pour que le système apprenne quelque chose.
Une façon de réaliser cette étape en apprentissage automatique consiste à utiliser l'extraction de caractéristiques.traction. Fonctionnalité extracLa réduction de dimensionnalité combine les caractéristiques existantes pour créer un ensemble de caractéristiques plus pertinent. Cela peut se faire avec l'ACP, le T-SNE ou tout autre algorithme de réduction de dimensionnalité.
Par exemple, dans le traitement d'images, le praticien doit extracModifiez manuellement les caractéristiques de l'image, comme les yeux, le nez, les lèvres, etc. Ces extracLes caractéristiques extraites sont ensuite transmises au modèle de classification.
L'apprentissage profond résout ce problème, notamment pour les réseaux de neurones convolutifs. La première couche d'un réseau de neurones apprend les petits détails de l'image ; les couches suivantes combinent ces connaissances pour former des informations plus complexes. Dans un réseau de neurones convolutif, les caractéristiques extraites de l'image sont extraites de l'image.tracLa sélection est effectuée à l'aide d'un filtre. Le réseau applique un filtre à l'image pour vérifier s'il existe une correspondance, c'est-à-dire si la forme de la caractéristique est identique à une partie de l'image. En cas de correspondance, le réseau utilise ce filtre. Le processus d'extraction de caractéristiquestracL'opération est donc effectuée automatiquement.

Résumé
Intelligence Artificielle confère une capacité cognitive à une machine. En comparant l'IA et l'apprentissage automatique, les premiers systèmes d'IA utilisaient la correspondance de modèles et des systèmes experts.
L’idée derrière l’apprentissage automatique est que la machine peut apprendre sans intervention humaine. La machine doit trouver un moyen d’apprendre à résoudre une tâche à partir des données.
L'apprentissage profond représente une avancée majeure dans le domaine de l'intelligence artificielle. Lorsqu'il dispose de suffisamment de données pour son entraînement, il obtient des résultats impressionnants, notamment pour la reconnaissance d'images et la traduction automatique. La principale raison réside dans l'extraction de caractéristiques.tracL'opération est effectuée automatiquement dans les différentes couches du réseau.
