
Comment installer et configurer HIVE Metastore avec MYSQL
 David Carter
⚡ Résumé intelligent
Le metastore Hive stocke chaque définition de table, nom de colonne et type de données derrière Apache Hive, et le déplacement de ce référentiel de la base de données Derby par défaut vers MySQL c'est ce qui permet à plusieurs utilisateurs de se connecter simultanément.
Qu’est-ce que le métastore HIVE ?
Le metastore Hive est un référentiel qui stocke les métadonnées (noms de colonnes, types de données, commentaires, etc.) relatives à Ruche Apache grâce à MySQL or PostgreSQL. Ce métastore Hive est implémenté à l'aide de tables dans une base de données relationnelle.
Le métastore ne contient pas les lignes elles-mêmes. Les enregistrements restent sur HDFS, et le métastore enregistre uniquement l'emplacement de chaque table et le nom de ses colonnes ; c'est pourquoi sa perte n'affecte que le schéma et non les données.
Pourquoi utiliser MySQL dans Hive en tant que métamatériau
Le système de gestion des métadonnées est une option, et non une composante fixe de Hive ; la configuration par défaut est volontairement minimale. Trois limitations incitent la quasi-totalité des installations à l'éviter.
- Par défaut, Hive utilise la base de données Derby comme métastore.
- Derby ne peut prendre en charge qu'un seul utilisateur actif à la fois.
- L'utilisation de Derby n'est pas recommandée en milieu de production.
La solution est donc :
- Utilisez le MySQL comme espace de stockage de métadonnées côté serveur pour connecter plusieurs utilisateurs à Hive simultanément.
- MySQL est le meilleur choix pour le métastore autonome
Comment installer et configurer Hive Metastore pour MySQL Base de données
Les neuf étapes ci-dessous s'exécutent dans l'ordre sur une machine où Hadoop et Hive sont déjà installés. Chaque étape se termine par une capture d'écran de la sortie du terminal ou du shell.
Étape 1) Installez MySQL Server
Dans cette étape, nous allons effectuer deux tâches
- Installation du serveur MySQL
- Vérification du serveur mysql et de son processus
Le sudo apt-get installer mysql-server commande, nous pouvons télécharger MySQL serveur. Installer MySQL comme indiqué dans la capture d'écran ci-dessous.

Après une installation réussie, MySQL Le processus s'exécutera comme indiqué dans la capture d'écran ci-dessous, où la vérification confirme que le service est opérationnel.

Étape 2) Installez MySQL Java connecteur
Installation du MySQL Java connecteur. Ceci est pour Java dépendances et finalités de connexion, car Hive atteint MySQL via JDBC. La capture d'écran suivante montre l'installation du package.

Étape 3) Créer un lien symbolique pour le connecteur
Création d'un lien symbolique pour le connecteur dans le répertoire lib de Hive. Il s'agit du lien symbolique entre Java et MySQLC'est cette commande qui place le fichier JAR du pilote dans le classpath de Hive. La commande et son résultat sont présentés ci-dessous.

Étape 4) Configuration MySQL stockage dans Hive
Le MySQL Il est nécessaire d'ouvrir le shell en tant que compte root avant de pouvoir créer un utilisateur Hive, comme indiqué ci-après.

- Saisissez mysql –u root –p suivi du mot de passe
- Ici, –u représente le nom d'utilisateur root et –p désigne le mot de passe
- Après avoir saisi la commande ci-dessus, l'utilisateur doit entrer un mot de passe valide, puis appuyer sur Entrée.
- Puis il entrera dans MySQL mode coque
Étape 5) Créez un nom d'utilisateur et un mot de passe
Création d'un nom d'utilisateur et d'un mot de passe pour MySQLet l'octroi de privilèges. La capture d'écran ci-dessous montre les trois instructions exécutées à l'intérieur du MySQL coquille.

Nous devons exécuter les commandes comme indiqué ci-dessous,
mysql> CREATE USER 'hiveuser'@'%' IDENTIFIED BY 'hivepassword';
mysql> GRANT all on *.* to 'hiveuser'@localhost identified by 'hivepassword';
mysql>  flush privileges;
On MySQL 8. La forme combinée de la deuxième instruction ne peut plus être analysée, car IDENTIFIED BY a été supprimé de GRANT. Créez d'abord le compte, puis accordez-lui les privilèges, et répétez la ligne CREATE USER pour l'hôte localhost ainsi que pour l'hôte générique.
Étape 6) Configuration du fichier hive-site.xml
- Après l'étape 5, un nom d'utilisateur et un mot de passe sont attribués à l'utilisateur. MySQL accès à la base de données et aux privilèges d'octroi.
- Nous allons ici configurer certaines propriétés dans Hive pour établir une connexion avec le MySQL base de données.
Le fichier de configuration s'ouvre depuis le répertoire de configuration de Hive, comme le montre la capture d'écran suivante.

La capture d'écran ci-dessous montre le fichier final avec les quatre propriétés en place.

D'après la capture d'écran ci-dessus, nous observons ce qui suit. Nous définissons ici 4 propriétés nécessaires à l'établissement MySQL comme le métastore dans Hive.
Ce sont les suivants:
- Cette propriété est destinée à la connexion URLNous définissons ici la connexion.URL Cette propriété sert de chaîne de connexion JDBC et représente également l'emplacement du métastore.
- Cette propriété correspond au nom du pilote de connexion. Ici, com.mysql.jdbc.Driver est la valeur à indiquer dans la balise value.
- Cette propriété sert à définir le nom d'utilisateur de la connexion. Dans cet exemple, nous avons défini « hiveuser » comme nom d'utilisateur.
- Cette propriété sert à spécifier le mot de passe de connexion. Ici, nous avons défini « hivepassword » comme mot de passe utilisateur.
Une fois les propriétés placées dans hive-site.xml, il faut enregistrer manuellement (Ctrl+S) et fermer le fichier. Après avoir fermé ce fichier, il faut créer une table Hive et vérifier les détails de la table. MySQL espace de rangement.
Placez ce code dans hive-site.xml
site-ruche.xml
<configuration>
	<property>
		<name>javax.jdo.option.ConnectionURL</name>
		<value>jdbc:mysql://localhost/metastore?createDatabaseIfNotExist=true</value>
		<description>metadata is stored in a MySQL server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionDriverName</name>
		<value>com.mysql.jdbc.Driver</value>
		<description>MySQL JDBC driver class</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionUserName</name>
		<value>hiveuser</value>
		<description>user name for connecting to mysql server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionPassword</name>
		<value>hivepassword</value>
		<description>password for connecting to mysql server</description>
	</property>
</configuration>
Les deux valeurs ci-dessus dépendent de la version du connecteur utilisée. MySQL Connector/J 8 a renommé la classe du pilote en com.mysql.cj.jdbc.Driver et exige désormais une configuration explicite du port et du protocole SSL. URL Le fichier contient généralement l'entrée suivante : jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true&useSSL=false. Le mot de passe étant stocké en clair, seul le compte de service Hive peut y accéder.
Étape 7) Créer un tableau
Créez la table « guru99 » dans Hive, comme indiqué dans l'interface Hive ci-dessous.

À partir de la capture d'écran ci-dessus, nous pouvons observer ce qui suit
- Création d'une table nommée « guru99 » avec deux noms de colonnes
- Les noms des colonnes sont mentionnés avec leur type de données : l’une est un entier et l’autre une chaîne de caractères.
Dans l'étape suivante, nous allons vérifier s'il est stocké dans MySQL ou non.
Étape 8) Entrez dans MySQL mode coque
La base de données du métastore est sélectionnée en premier, et la liste des tableaux qui suit est affichée ci-dessous.

À partir de la capture d'écran ci-dessus, nous pouvons observer ce qui suit
- Il faut d'abord sélectionner la base de données avec « use metastore ».
- Une fois le métastore sélectionné, nous pouvons vérifier les tables qu'il contient à l'aide de la commande « show tables », comme illustré dans la capture d'écran.
- Quelles que soient les tables créées dans Hive, les métadonnées correspondantes sont stockées sous TBLS dans le MySQL base de données
- La table « guru99 » est créée dans Hive, les métadonnées correspondantes sont donc stockées dans MySQL sous TBLS
Étape 9) Entrez select * from TBLS
Vérifier si la table créée est présente dans MySQL ou non. La requête et son résultat apparaissent dans la capture d'écran ci-dessous.
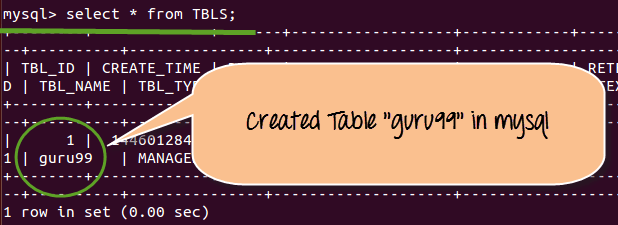
En entrant select * from TBLS, il va afficher les tables que nous avons créées en mode shell Hive
À partir de la capture d'écran ci-dessus, nous pouvons observer les choses suivantes :
- Le nom de la table « guru99 » créée dans Hive peut être affiché dans MySQL mode coque
- En outre, il fournira également des informations telles que la date de création de la table, la date et l'heure d'accès, ainsi que d'autres propriétés, comme indiqué dans la capture d'écran ci-dessus.
Comment initialiser le schéma du metastore Hive avec schematool
L'indicateur createDatabaseIfNotExist dans la connexion URL Cette commande crée une base de données de métadonnées vide, mais n'y crée pas les quelque soixante-dix tables attendues par Hive. Sur Hive 1.x et versions ultérieures, cette tâche incombe à l'utilitaire schematool et est ignorée.ping C'est la raison la plus fréquente pour laquelle un métastore nouvellement configuré refuse de démarrer.
$HIVE_HOME/bin/schematool -dbType mysql -initSchema
La commande lit les quatre mêmes propriétés du fichier hive-site.xml, se connecte au compte utilisateur Hive et exécute le script SQL fourni correspondant à la version de Hive. Une exécution réussie se termine par un message de confirmation, dont l'état peut être vérifié ultérieurement.
$HIVE_HOME/bin/schematool -dbType mysql -info
Les indicateurs ci-dessous couvrent l'intégralité du cycle de vie d'un schéma de métastore.
| Option | Ce qu'il fait |
|---|---|
| -dbType | Indique le nom du système de base de données, par exemple MySQL, Derby, PostgreSQL, Oracle ou MSSQL. |
| -initSchema | Crée les tables de métadonnées pour la version actuelle de Hive. |
| -Info | Indique la version du schéma enregistrée dans la base de données |
| -upgradeSchema | Migre un schéma existant après une mise à niveau de Hive |
| -valider | Vérifie le schéma pour détecter les tables manquantes et les incompatibilités de version. |
Il est utile de connaître une propriété connexe avant de commencer. Lorsque hive.metastore.schema.verification est vrai, Hive compare la version du schéma dans MySQL Il vérifie la compatibilité avec sa propre version et refuse de s'exécuter en cas d'incompatibilité. Cette vérification est une mesure de sécurité ; la réponse appropriée consiste donc à exécuter la mise à niveau plutôt que de l'interrompre. MySQL Le backend est utilisé par l'installation Hive décrite dans installer Hive sur Ubuntu.
Erreurs courantes du metastore Hive et comment les corriger
La plupart des échecs à ce stade produisent l'un des quelques messages suivants, chacun pointant vers une étape spécifique supérieure plutôt que vers Hive lui-même.
| Symptôme | Cause et solution |
|---|---|
| Informations de version introuvables dans le métastore | Le schéma n'a jamais été créé. Exécutez schematool avec l'option -initSchema sur la même base de données que celle spécifiée dans la connexion. URL |
| Exception ClassNotFoundException pour le pilote JDBC | Le fichier JAR du connecteur est absent du répertoire lib de Hive, ou bien Connector/J 8 est utilisé et la classe est maintenant com.mysql.cj.jdbc.Driver. Revérifiez le lien symbolique de l'étape 3. |
| Accès refusé à l'utilisateur hiveuser | Les privilèges n'ont été accordés qu'à un seul hôte. Créez le compte pour localhost et l'hôte générique, puis exécutez la commande « flush privileges ». |
| Erreur de syntaxe près de IDENTIFIED BY | MySQL 8. Supprimez IDENTIFIED BY de l'instruction GRANT. Exécutez d'abord CREATE USER, puis GRANT. |
| La récupération de la clé publique n'est pas autorisée. | Connector/J 8 refuse par défaut une négociation non chiffrée. Ajoutez useSSL=false et allowPublicKeyRetrieval=true à la configuration JDBC. URL sur un réseau de confiance |
| Des tables sont manquantes après une mise à niveau de Hive. | Le schéma correspond toujours à l'ancienne version. Exécutez schematool avec l'option -upgradeSchema au lieu de désactiver la vérification du schéma. |
Une fois que le métastore répond de manière fiable, les définitions de table qu'il enregistre sont créées avec les instructions décrites dans Tables Hive : création, modification et suppression.
