
Tutoriel Hive Join & SubQuery avec exemples
 David Carter
⚡ Résumé intelligent
Les jointures Hive combinent les lignes de deux tables ou plus sur une colonne correspondante, et les sous-requêtes imbriquent une requête dans une autre ; les deux sont donc illustrés ici sur deux exemples de tables chargées à partir de fichiers texte brut.

Rejoindre des requêtes
Les requêtes de jointure peuvent être effectuées sur deux tables présentes dans RuchePour bien comprendre les concepts de jointure, nous créons ici deux tables :
- sample_joins (lié aux informations client)
- sample_joins1 (lié aux détails des commandes passées par les employés)
Étape 1) Création de la table « sample_joins » avec les colonnes Id, Nom, Âge, Adresse et Salaire des employés. La capture d'écran ci-dessous montre l'instruction CREATE TABLE et sa confirmation.

Étape 2) Chargement et affichage des données. La capture d'écran suivante montre la commande de chargement suivie du contenu du tableau.
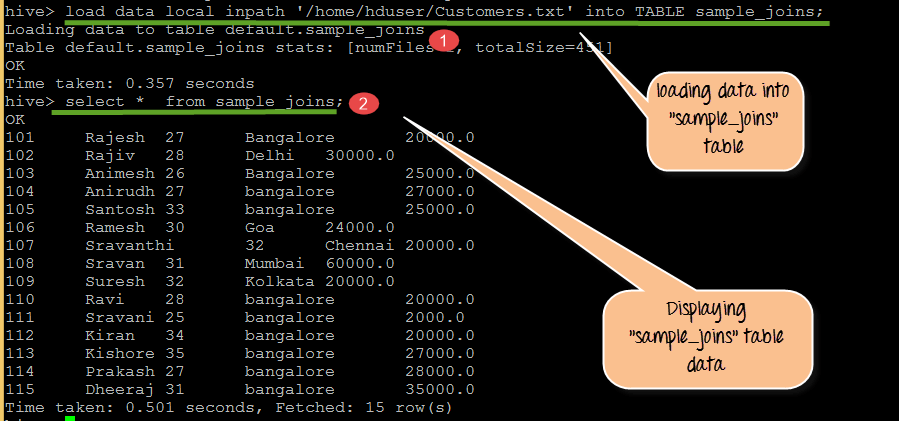
D'après la capture d'écran ci-dessus :
- Chargement des données dans sample_joins à partir de Customers.txt
- Affichage du contenu de la table sample_joins
Étape 3) Création de la table sample_joins1, puis chargement et affichage de ses données, comme illustré dans la capture d'écran ci-dessous.

La capture d'écran ci-dessus nous permet d'observer ce qui suit :
- Création de la table sample_joins1 avec les colonnes Orderid, Date1, Id et Amount
- Chargement des données dans sample_joins1 à partir deorders.txt
- Affichage des enregistrements présents dans sample_joins1
Nous allons maintenant examiner les différents types de jointures possibles sur les tables que nous avons créées. Auparavant, il est important de prendre en compte les points suivants concernant les jointures.
Quelques points à observer lors des jointures :
- Seules les jointures d'égalité sont autorisées dans les jointures.
- Plus de deux tables peuvent être jointes dans la même requête
- Les jointures LEFT, RIGHT et FULL OUTER existent afin d'offrir un meilleur contrôle sur la clause ON pour laquelle il n'existe aucune correspondance.
- Les jointures ne sont pas commutatives.
- Les jointures sont associatives à gauche, qu'il s'agisse de jointures GAUCHE ou DROITE.
La restriction d'égalité reflète le fonctionnement de Hive pendant de nombreuses années. À partir de la version 2.2.0, les expressions complexes dans la clause ON sont prises en charge (HIVE-15211), ce qui permet d'accepter une condition de non-égalité dans les versions actuelles. Dans les versions antérieures, la condition doit impérativement être un test d'égalité, toute autre condition devant être placée dans une clause WHERE.
Différents types de jointures
Il existe 4 types de jointures. Les voici :
- Jointure interne
- Jointure externe gauche
- Jointure externe droite
- Jointure externe complète
Chaque type est illustré ci-dessous par rapport aux mêmes deux tableaux ; la seule chose qui change entre les exemples est donc les lignes non appariées qui subsistent.
Jointure interne
Cette jointure interne permet de récupérer les enregistrements communs aux deux tables. Le résultat affiché dans la capture d'écran ci-dessous ne contient que les clients ayant une commande correspondante.

La capture d'écran ci-dessus nous permet d'observer ce qui suit :
- Nous effectuons ici une requête de jointure en utilisant le mot-clé JOIN entre les tables sample_joins et sample_joins1, avec la condition de correspondance (c.Id = o.Id).
- Le résultat affiche les enregistrements communs aux deux tables, sélectionnés en vérifiant la condition mentionnée dans la requête.
requête:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
Jointure externe gauche
- RucheQL LEFT OUTER JOIN renvoie toutes les lignes de la table de gauche même s'il n'y a aucune correspondance dans la table de droite.
- Si la clause ON ne correspond à aucun enregistrement dans la table de droite, la jointure renvoie tout de même un enregistrement dans le résultat avec NULL dans chaque colonne de la table de droite.
La capture d'écran ci-dessous montre que tous les clients apparaissent, y compris ceux qui n'ont passé aucune commande.

La capture d'écran ci-dessus nous permet d'observer ce qui suit :
- Nous effectuons ici une jointure externe gauche (LEFT OUTER JOIN) entre les tables `sample_joins` et `sample_joins1`, avec la condition de correspondance `(c.Id = o.Id)`. Par exemple, nous utilisons ici l'identifiant de l'employé comme référence ; la requête vérifie si cet identifiant est commun aux deux tables. Il constitue la condition de correspondance.
- Le résultat affiche les enregistrements sélectionnés selon la condition mentionnée dans la requête. Les valeurs NULL dans le résultat ci-dessus correspondent aux colonnes sans valeur dans la table de droite, à savoir sample_joins1.
requête:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Jointure externe droite
- La jointure externe droite (RIGHT OUTER JOIN) de HiveQL renvoie toutes les lignes de la table de droite même s'il n'y a aucune correspondance dans la table de gauche.
- Si la clause ON ne correspond à aucun enregistrement dans la table de gauche, la jointure renvoie tout de même un enregistrement dans le résultat avec NULL dans chaque colonne de la table de gauche.
- Les jointures RIGHT renvoient toujours les enregistrements de la table de droite et les enregistrements correspondants de la table de gauche. Si la table de gauche ne contient aucune valeur pour la colonne, la valeur NULL sera renvoyée à cet emplacement.
La capture d'écran ci-dessous montre l'image miroir du résultat précédent : chaque commande apparaît, qu'elle ait été validée ou non.

La capture d'écran ci-dessus nous permet d'observer ce qui suit :
- Nous effectuons ici une requête de jointure en utilisant le mot-clé « RIGHT OUTER JOIN » entre les tables sample_joins et sample_joins1, avec la condition de correspondance (c.Id = o.Id).
- Le résultat affiche les enregistrements sélectionnés en vérifiant la condition mentionnée dans la requête.
requête:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Jointure externe complète
Elle combine les enregistrements des tables sample_joins et sample_joins1 en fonction de la condition JOIN donnée dans la requête.
Elle renvoie tous les enregistrements des deux tables et remplace les valeurs correspondantes par des valeurs NULL, comme le montre la capture d'écran ci-dessous.

La capture d'écran ci-dessus nous permet d'observer ce qui suit :
- Nous effectuons ici une requête de jointure en utilisant le mot-clé « FULL OUTER JOIN » entre les tables sample_joins et sample_joins1, avec la condition de correspondance (c.Id = o.Id).
- Le résultat affiche tous les enregistrements présents dans les deux tables, sélectionnés en fonction de la condition spécifiée dans la requête. Les valeurs NULL indiquent les valeurs manquantes dans les colonnes des deux tables.
requête:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Sous-requêtes
Les jointures placent les tables côte à côte. Une sous-requête fonctionne différemment : elle imbrique une requête dans une autre afin que la requête externe puisse travailler à partir d’un résultat déjà calculé.
Une requête incluse dans une autre requête est appelée sous-requête. La requête principale dépendra des valeurs renvoyées par la sous-requête.
Les sous-requêtes peuvent être classées en deux types :
- Sous-requêtes dans la clause FROM
- Sous-requêtes dans la clause WHERE
Quand utiliser:
- Pour obtenir une valeur particulière combinée à partir de deux valeurs de colonnes provenant de tables différentes
- Dépendance des valeurs d'une table par rapport à d'autres tables
- Vérification comparative des valeurs d'une colonne par rapport à d'autres tables
syntaxe:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
Exemple :
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
Ici, t1 et t2 sont les noms des tables. L'instruction interne est la sous-requête exécutée sur la table t1. Les colonnes a et b sont ajoutées dans la sous-requête et affectées à la colonne col1. Col1 correspond à la valeur de la colonne présente dans la table principale. La colonne « col1 » de la sous-requête est donc équivalente à la valeur de la colonne col1 de la requête sur la table principale.
Intégration de scripts personnalisés
Lorsqu'une sous-requête remodèle des données uniquement avec HiveQL, un script intégré transmet des lignes à un code écrit en dehors de Hive.
Hive permet de rédiger des scripts personnalisés pour répondre aux besoins spécifiques des clients. Les utilisateurs peuvent ainsi créer leurs propres scripts de mappage et de réduction. On les appelle des scripts personnalisés intégrés. La logique de programmation est définie dans le script personnalisé, et ce script peut être utilisé lors des opérations ETL.
Quand choisir des scripts intégrés :
- Lorsque les exigences spécifiques du client impliquent que les développeurs doivent écrire et déployer des scripts dans Hive
- Dans quels cas les fonctions intégrées de Hive ne conviennent pas à des exigences de domaine spécifiques
Pour cela, Hive utilise la clause TRANSFORM afin d'intégrer à la fois les scripts de mappage et de réduction.
Dans ces scripts personnalisés intégrés, nous devons observer les points suivants :
- Les colonnes seront transformées en chaînes de caractères et délimitées par des tabulations avant d'être transmises au script utilisateur.
- La sortie standard du script utilisateur sera traitée comme des colonnes de chaînes de caractères séparées par des tabulations.
Exemple de script intégré :
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
Le script ci-dessus nous permet de faire les observations suivantes. Il ne s'agit que d'un exemple de script à des fins de compréhension.
- pv_users est la table des utilisateurs, qui contient des champs tels que l'identifiant utilisateur et la date, comme mentionné dans map_script.
- Le script de réduction est défini sur la date et le nombre d'utilisateurs de la table pv_users
