
Exemple Hadoop MapReduce : Premier Java Programme avec Code
 Prafulla Ranadive
⚡ Résumé intelligent
Les programmes Hadoop MapReduce sont écrits sous forme de trois Java Des classes, un mappeur, un réducteur et un pilote, qui sont compilés, empaquetés dans un fichier jar et soumis au cluster pour compter les ventes par pays.
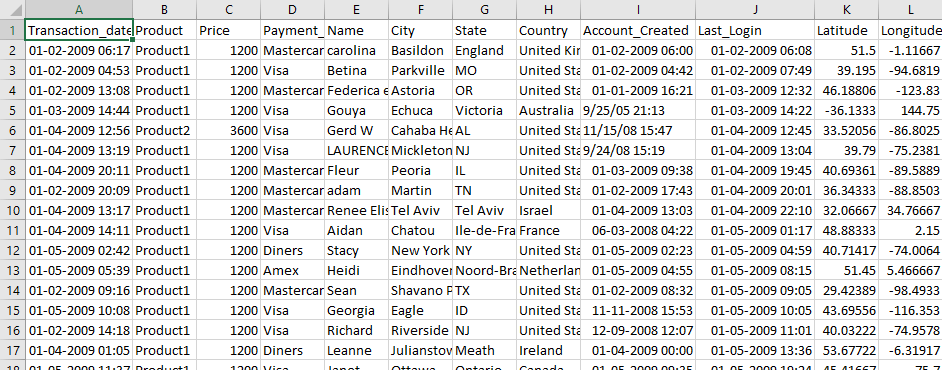
Dans ce didacticiel, vous apprendrez à utiliser Hadoop avec des exemples MapReduce. Les données d'entrée utilisées sont VentesJan2009.csvCe fichier contient des informations relatives aux ventes, telles que le nom du produit, son prix, le mode de paiement, ainsi que la ville et le pays du client. L'objectif est de déterminer le nombre de produits vendus dans chaque pays.
Premier programme Hadoop MapReduce
Maintenant dans ce Tutoriel MapReduce, nous allons créer notre premier Java Programme MapReduce :
La capture d'écran ci-dessous montre les données brutes de SalesJan2009, où chaque ligne représente une transaction et le pays figure dans la huitième colonne séparée par des virgules.
Assurez-vous d'avoir installé Hadoop. Avant de commencer, connectez-vous en tant qu'utilisateur « hduser » (l'identifiant utilisé lors de la configuration de Hadoop ; vous pouvez utiliser l'identifiant que vous avez utilisé lors de votre propre configuration Hadoop).
su - hduser_
L'invite de commande passe au compte hduser, comme indiqué ci-dessous.

Étape 1) Créer le répertoire du projet et les fichiers sources
Créez un nouveau répertoire nommé MapReduceTutorial, comme indiqué dans l'exemple MapReduce ci-dessous.
sudo mkdir MapReduceTutorial

Donner des autorisations
sudo chmod -R 777 MapReduceTutorial

Créez les trois Java Les fichiers sources se trouvent ci-dessous dans MapReduceTutorial. Notez que les trois utilisent l'ancienne version. org.apache.hadoop.mapred API, qui est toujours fournie avec Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
L'archive se divise en trois fichiers sources identiques, comme indiqué ici.
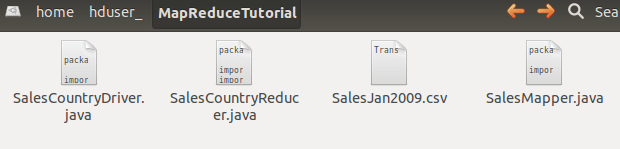
Vérifiez les autorisations de fichiers de tous ces fichiers

Si les autorisations de « lecture » sont manquantes, accordez-les :

Étape 2) Exporter le classpath Hadoop
Exportez le classpath comme indiqué dans l'exemple Hadoop ci-dessous.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Le chemin de classe exporté est renvoyé à l'invite de commande.

Étape 3) Compiler le Java fichiers
Compiler le Java Ces fichiers (présents dans le répertoire Final-MapReduceHandsOn) seront placés dans le répertoire du package.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
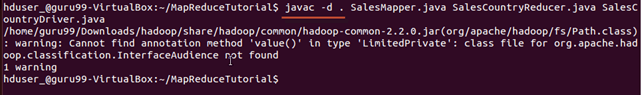
Cet avertissement peut être ignoré sans risque — il signale simplement que l'API mapred est obsolète.
Cette compilation créera un répertoire dans le répertoire courant portant le nom du paquet spécifié dans le Java Le fichier source (c'est-à-dire SalesCountry dans notre cas) contient tous les fichiers de classe compilés.

Étape 4) Créer le fichier manifeste
Créez un nouveau fichier Manifest.txt
sudo gedit Manifest.txt
Ajoutez-y la ligne suivante :
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver est le nom de la classe principale. Veuillez noter que vous devez appuyer sur la touche Entrée à la fin de cette ligne.
Étape 5) Empaquetez les classes dans un fichier jar
Créer un fichier Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Vérifiez que le fichier jar est créé

Étape 6) Démarrer Hadoop
Démarrer Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Étape 7) Copiez le fichier d'entrée dans HDFS
Copiez le fichier SalesJan2009.csv dans ~/inputMapReduce
Utilisez maintenant la commande ci-dessous pour copier ~/inputMapReduce vers HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
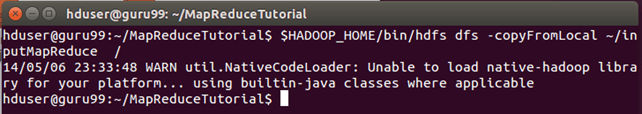
Nous pouvons ignorer cet avertissement en toute sécurité.
Vérifiez si un fichier est réellement copié ou non.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Étape 8) Exécuter la tâche MapReduce
Exécuter le travail MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Cela créera un répertoire de sortie nommé mapreduce_output_sales sur HDFS. Le contenu de ce répertoire sera un fichier contenant les ventes de produits par pays.
Étape 9) Lire les résultats
Le résultat est visible via l'interface de commande comme suit :
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
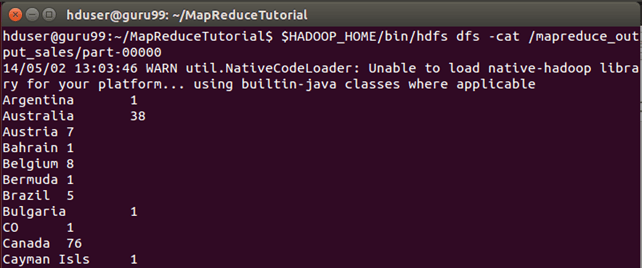
Les résultats peuvent également être consultés via une interface Web comme-
Ouvrez http://localhost:50070/ dans un navigateur web. Sur Hadoop 3.x, l'interface utilisateur web du NameNode a été déplacée vers le port 9870, alors utilisez http://localhost:9870/ là à la place.

Sélectionnez maintenant « Parcourir le système de fichiers » et accédez à /mapreduce_output_sales

Ouvrir la pièce-r-00000

Explication de la classe SalesMapper
Le travail étant présenté de bout en bout, les trois sections suivantes détaillent le rôle de chaque classe.
Dans cette section, nous allons étudier l'implémentation de la classe SalesMapper.
1. Nous commençons par spécifier le nom du package de notre classe. SalesCountry est le nom de notre package. Veuillez noter que le résultat de la compilation, SalesMapper.class, sera placé dans un répertoire portant le nom de ce package : SalesCountry.
Ensuite, nous importons des packages de bibliothèque.
La capture d'écran ci-dessous illustre une implémentation de la classe SalesMapper.

Échantillon Code Explication:
1. Définition de la classe SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Chaque classe de mappeur doit hériter de la classe MapReduceBase et implémenter l'interface Mapper.
2. Définir la fonction « carte » -
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
La partie principale de la classe Mapper est une méthode 'map()' qui accepte quatre arguments.
À chaque appel de la méthode 'map()', une paire clé-valeur (« clé » et « valeur » dans ce code) est transmise.
La méthode `map()` commence par diviser le texte d'entrée reçu en argument. Elle divise chaque ligne en champs.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Ici, la virgule est utilisée comme délimiteur.
Ensuite, une paire est formée à partir d'un enregistrement à l'index 7 du tableau 'SingleCountryData' et d'une valeur '1'.
output.collect(new Text(SingleCountryData[7]), one);
Nous sélectionnons l'enregistrement à l'index 7 car nous avons besoin des données de pays et celles-ci se trouvent à l'index 7 dans le tableau 'SingleCountryData'.
Veuillez noter que nos données d'entrée sont au format ci-dessous (où le pays se trouve à l'indice 7, 0 étant l'indice de départ) :
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
La sortie du mappeur est à nouveau une paire clé-valeur qui est émise à l'aide de la méthode 'collect()' de 'OutputCollector'.
Explication de la classe SalesCountryReducer
Dans cette section, nous allons étudier l'implémentation de la classe SalesCountryReducer.
1. Nous commençons par spécifier le nom du package de notre classe. SalesCountry est le nom de notre package. Veuillez noter que le résultat de la compilation, SalesCountryReducer.class, sera placé dans un répertoire portant le nom de ce package : SalesCountry.
Ensuite, nous importons des packages de bibliothèque.
La capture d'écran ci-dessous illustre une implémentation de la classe SalesCountryReducer.
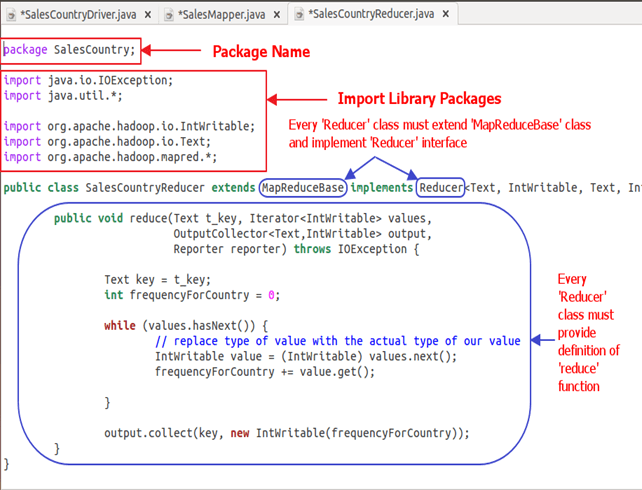
Code Explication:
1. Définition de la classe SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Ici, les deux premiers types de données, « Text » et « IntWritable », sont le type de données de la paire clé-valeur d'entrée du réducteur.
Le résultat du mappeur se présente sous la forme de , La sortie du mappeur devient l'entrée du réducteur. Par conséquent, pour assurer la cohérence avec le type de données, les types Text et IntWritable sont utilisés ici.
Les deux derniers types de données, « Text » et « IntWritable », sont les types de données de sortie générés par le réducteur sous la forme d'une paire clé-valeur.
Chaque classe de réducteur doit hériter de la classe MapReduceBase et implémenter l'interface Reducer.
2. Définir la fonction « réduire » -
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
L'entrée de la méthode reduce() est une clé associée à une liste de valeurs multiples.
Par exemple, dans notre cas, ce sera-
, , , , , .
Ceci est donné au réducteur comme
Pour accepter des arguments de cette forme, on utilise d'abord deux types de données : Text et Iterator. .Texte est un type de données de clé et d'itérateur est un type de données pour une liste de valeurs associées à cette clé.
L'argument suivant est de type OutputCollector qui collecte la sortie de la phase de réduction.
La méthode reduce() commence par copier la valeur de la clé et initialiser le compteur de fréquence à 0.
Text key = t_key;int frequencyForCountry = 0;
Ensuite, à l'aide d'une boucle 'while', nous parcourons la liste des valeurs associées à la clé et calculons la fréquence finale en additionnant toutes les valeurs.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nous envoyons maintenant le résultat au collecteur de sortie sous la forme d'une clé et du nombre de fréquences obtenues.
Le code ci-dessous fait ceci-
output.collect(key, new IntWritable(frequencyForCountry));
Explication de la classe SalesCountryDriver
Dans cette section, nous allons étudier l'implémentation de la classe SalesCountryDriver.
1. Nous commençons par spécifier le nom du package de notre classe. SalesCountry est le nom de notre package. Veuillez noter que le résultat de la compilation, SalesCountryDriver.class, sera placé dans un répertoire portant le nom de ce package : SalesCountry.
Voici une ligne spécifiant le nom du package suivi du code pour importer les packages de bibliothèque.

2. Définissez une classe de pilote qui créera un nouveau travail client, un objet de configuration et publiera les classes Mapper et Réducteur.
La classe du pilote est responsable de la configuration de notre tâche MapReduce pour qu'elle s'exécute dans HadoopDans cette classe, nous spécifions le nom de la tâche, le type de données d'entrée/sortie et les noms des classes mapper et reducer.

3. Dans l'extrait de code ci-dessous, nous définissons les répertoires d'entrée et de sortie qui sont utilisés respectivement pour consommer l'ensemble de données d'entrée et produire la sortie.
arg[0] et arg[1] sont les arguments de ligne de commande passés avec une commande donnée dans l'exercice pratique MapReduce, c'est-à-dire,
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
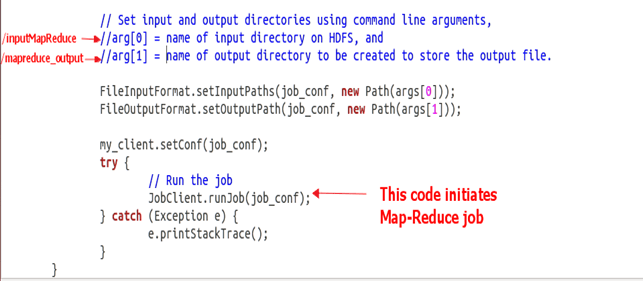
4. Déclenchez notre travail
Le code ci-dessous lance l'exécution de la tâche MapReduce.
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
