
Tutoriel sur les réseaux de neurones artificiels (RNA) avec TensorFlow
 Équipe éditoriale
⚡ Résumé intelligent
Les réseaux de neurones artificiels apprennent en faisant passer des données d'entrée à travers des couches interconnectées, en évaluant le résultat à l'aide d'une fonction de perte et en corrigeant les poids grâce à un optimiseur. Ce tutoriel explique comment en construire un avec TensorFlow et classifier les chiffres de la base de données MNIST.
Qu'est-ce qu'un réseau de neurones artificiels ?
An Réseau de neurones artificiels (ANN) Un réseau de neurones artificiels est un système informatique inspiré des réseaux neuronaux biologiques, conçu pour créer des cerveaux artificiels à partir d'un ensemble d'unités interconnectées appelées neurones artificiels. Il est conçu pour analyser et traiter l'information de la même manière que les humains. Un réseau de neurones artificiels possède des capacités d'auto-apprentissage qui lui permettent de produire de meilleurs résultats à mesure que davantage de données sont disponibles.
Le diagramme ci-dessous tracil s'agit d'un passage complet à travers un tel réseau, depuis l'entrée brute jusqu'à l'optimiseur qui corrige les poids.

Un réseau de neurones artificiels (ANN) est composé de quatre objets principaux :
- Couches: L'apprentissage se déroule entièrement au sein des différentes couches. Il y a trois couches : 1) Entrée, 2) Cachée et 3) Sortie.
- Caractéristique et étiquette : Données d'entrée du réseau (caractéristiques) et données de sortie du réseau (étiquettes)
- Fonction de perte : Métrique utilisée pour estimer la performance de la phase d'apprentissage
- Optimiseur: Améliorer l'apprentissage en actualisant les connaissances au sein du réseau
Un réseau de neurones reçoit des données d'entrée et les traite à travers un ensemble de couches. Il évalue ensuite ses performances grâce à une fonction de perte. Cette fonction lui indique le chemin à parcourir pour maîtriser les connaissances. Le réseau améliore ces connaissances grâce à un optimiseur.
Si vous jetez un œil à la figure ci-dessus, vous comprendrez le mécanisme sous-jacent.
Le programme prend des valeurs en entrée et les injecte dans deux couches entièrement connectées. Imaginez un problème de mathématiques. La première chose à faire est de lire le chapitre correspondant pour le résoudre. Ensuite, vous appliquez vos nouvelles connaissances au problème. Il y a de fortes chances que votre résultat ne soit pas excellent. C'est la même chose pour un réseau : lors de sa première analyse des données et de sa première prédiction, le résultat ne correspondra pas parfaitement aux données réelles.
Pour améliorer ses connaissances, le réseau utilise un optimiseur. Dans cette analogie, l'optimiseur peut être comparé à la relecture d'un chapitre : en relisant, on acquiert de nouvelles connaissances. De même, le réseau utilise l'optimiseur, met à jour ses connaissances et teste ces nouvelles connaissances pour déterminer ce qu'il lui reste à apprendre. Le programme répète cette étape jusqu'à obtenir le taux d'erreur le plus faible possible.
Dans l'analogie avec les problèmes de mathématiques, cela signifie que vous lisez plusieurs fois le chapitre du manuel jusqu'à en maîtriser parfaitement le contenu. Si, malgré plusieurs lectures, vous continuez à faire des erreurs, cela signifie que vous avez atteint le niveau de compréhension maximal du sujet. Il vous faut alors utiliser un autre manuel ou tester une autre méthode pour améliorer vos résultats. Pour un réseau de neurones, le processus est similaire. Si le taux d'erreur cesse de diminuer et que la courbe de perte se stabilise, l'architecture actuelle ne peut plus rien apprendre. Le réseau doit être optimisé pour améliorer ses connaissances.
Ces quatre objets correspondent directement aux composants que vous configurez lors de la conception d'un réseau.
Réseau neuronal Architecture
L'architecture du réseau neuronal artificiel se compose des éléments suivants :
- Couches
- Fonction d'activation
- Fonction de perte
- Optimizer
Couches
C'est au sein d'une couche que se déroule l'apprentissage. Chaque couche contient un nombre quelconque de neurones, chacun associé à son propre poids. Un réseau de neurones typique est généralement composé de couches densément connectées (également appelées couches entièrement connectées). Cela signifie que toutes les entrées sont reliées à la sortie.
Un réseau de neurones typique prend en entrée un vecteur et une variable scalaire contenant les étiquettes. La configuration la plus simple est une classification binaire avec seulement deux classes : 0 et 1.
Le réseau reçoit un signal d'entrée, le transmet à tous les nœuds connectés et calcule le signal à l'aide d'une fonction d'activation. Le schéma numéroté ci-dessous détaille un nœud afin de visualiser séparément la somme pondérée et l'étape d'activation.

La figure ci-dessus illustre ce principe. La première couche contient les valeurs d'entrée. La deuxième couche, appelée couche cachée, reçoit les entrées pondérées de la couche précédente.
- Le premier nœud correspond aux valeurs d'entrée.
- Le neurone est décomposé en une partie d'entrée et une fonction d'activation. La partie gauche reçoit toutes les entrées de la couche précédente. La partie droite correspond à la somme des entrées passées à la fonction d'activation.
- La valeur de sortie, calculée à partir des couches cachées, sert à effectuer une prédiction. En classification, elle correspond au nombre de classes. En régression, une seule valeur est prédite.
Fonction d'activation
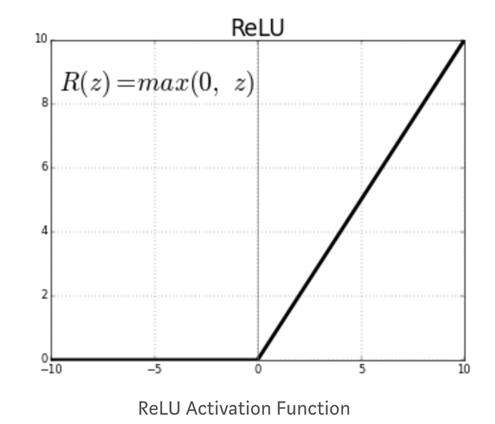
La fonction d'activation d'un nœud définit sa sortie en fonction d'un ensemble d'entrées. Elle est nécessaire pour permettre au réseau d'apprendre des modèles non linéaires. La fonction ReLU (Rectified Linear Unit) est une fonction d'activation courante. Elle renvoie zéro pour toutes les valeurs négatives.
Les autres fonctions d'activation sont :
- Linéaire par morceaux
- Sigmoïde
- Tanh
- ReLU qui fuit
Le graphique ci-dessous montre pourquoi la fonction ReLU est décrite ainsi : la courbe est plate à zéro pour toute entrée négative et augmente linéairement ensuite.
La décision cruciale à prendre lors de la création d’un réseau de neurones est la suivante :
- Combien de couches dans le réseau neuronal
- Combien d'unités cachées pour chaque couche
Les réseaux neuronaux comportant de nombreuses couches et unités cachées peuvent apprendre une représentation complexe des données, mais ils rendent le calcul du réseau très coûteux.
Fonction de perte
Après avoir défini les couches cachées et la fonction d'activation, vous devez spécifier la fonction de perte et l'optimiseur.
Pour la classification binaire, il est courant d'utiliser une fonction de perte d'entropie croisée binaire. régression linéaire, vous utilisez l'erreur quadratique moyenne.
La fonction de perte est une mesure importante pour estimer les performances de l'optimiseur. Pendant la formation, cette métrique sera minimisée. Vous devez sélectionner cette quantité avec soin en fonction du type de problème auquel vous êtes confronté.
Optimizer
La fonction de perte mesure les performances du modèle. L'optimiseur permet d'améliorer les poids du réseau afin de réduire cette perte. Différents optimiseurs existent, mais le plus courant est la descente de gradient stochastique.
Les optimiseurs conventionnels sont :
- Momentum Teams
- Gradient accéléré de Nesterov
- AdaGrad
- Optimisation Adam
ArchiLa structure seule ne garantit pas un modèle utilisable.
Limites du réseau neuronal
Voici les limitations d'un réseau neuronal :
Surapprentissage
Un problème courant des réseaux de neurones complexes réside dans leur difficulté à généraliser à des données inédites. Un réseau comportant de nombreux poids peut identifier avec précision des détails spécifiques dans l'ensemble d'entraînement, mais cela conduit souvent à un surapprentissage. Si les données sont déséquilibrées au sein des groupes (c'est-à-dire si certains groupes contiennent trop peu de données), le réseau apprendra très bien pendant l'entraînement, mais sera incapable de généraliser ces modèles à des données jamais vues auparavant.
Il y a un compromis à faire. machine learning entre optimisation et généralisation.
- L'optimisation d'un modèle nécessite de trouver les meilleurs paramètres qui minimisent la perte de l'ensemble d'entraînement.
- Cependant, la généralisation indique comment le modèle se comporte pour les données invisibles.
Pour éviter que le modèle ne capture des détails spécifiques ou des schémas indésirables dans les données d'entraînement, différentes techniques peuvent être utilisées. La meilleure méthode consiste à disposer d'un ensemble de données équilibré et suffisamment volumineux. L'art de réduire le surapprentissage s'appelle la régularisation. Les trois techniques ci-dessous constituent les points de départ classiques.
| Technique | Ce qu'il contraint | Configuration typique de ce tutoriel |
|---|---|---|
| Taille du réseau | Le nombre de couches et d'unités cachées | Deux couches cachées, 300 et 100 unités |
| Régularisation des poids L1/L2 | L'ampleur des coefficients de pondération | force_régularisation_l1 et force_régularisation_l2 de 0.01 |
| marginal | La part des unités désactivées par étape de formation | taux d'abandon de 0.3 |
Taille du réseau
Un réseau de neurones comportant un trop grand nombre de couches et d'unités cachées est réputé pour sa grande complexité. Une méthode simple pour réduire la complexité du modèle consiste à en réduire la taille. Il n'existe pas de règle unique pour déterminer le nombre de couches. Il est nécessaire de commencer avec un petit nombre de couches et d'augmenter progressivement leur taille jusqu'à ce que le modèle surapprenne.
Régularisation du poids
Une technique courante pour prévenir le surapprentissage consiste à imposer des contraintes aux poids du réseau. Ces contraintes contraignent les poids du réseau à prendre uniquement de petites valeurs. Elles sont ajoutées à la fonction de perte de l'erreur. Il existe deux types de régularisation :
- L1 (Lasso) : Le coût est proportionnel à la valeur absolue des coefficients de pondération.
- L2 (Crête) : Le coût est proportionnel au carré de la valeur des coefficients de pondération.
marginal
Le dropout est une technique particulière mais utile. Un réseau avec dropout désactive aléatoirement certaines unités pendant l'entraînement, annulant ainsi leur signal de sortie. Prenons l'exemple d'un tableau de poids [0.1 ; 1.7 ; 0.7 ; -0.9]. Avec un réseau de neurones utilisant le dropout, ce tableau deviendra [0.1 ; 0 ; 0 ; -0.9], les zéros étant répartis aléatoirement. Le paramètre contrôlant le dropout est le taux de dropout, qui détermine le nombre d'unités désactivées. Un taux compris entre 0.2 et 0.5 est courant.
Un petit exemple interactif permet de visualiser facilement le déroulement de la formation.
Exemple de réseau neuronal dans TensorFlow
Voici un exemple de réseau de neurones artificiels en action, illustrant son fonctionnement face à un problème de classification classique. Le réseau comporte deux entrées, x1 et x2, chacune ayant une valeur aléatoire. La sortie est une classe binaire. L'objectif est de classer l'élément en fonction de ces deux caractéristiques. Pour ce faire, l'architecture du réseau de neurones est définie comme suit :
- Deux couches cachées
- La première couche comporte quatre neurones entièrement connectés
- La deuxième couche possède deux neurones entièrement connectés
- La fonction d'activation est une ReLU.
- Ajoutez une régularisation L2 avec un taux d'apprentissage de 0.003
Le réseau optimisera les poids pendant 180 époques avec une taille de lot de 10. Dans l'animation d'exemple de réseau de neurones artificiels ci-dessous, vous pouvez observer l'évolution des poids au fil du temps et l'amélioration de la carte de classification.ping.

Tout d’abord, le réseau attribue des valeurs aléatoires à tous les poids.
- Avec des poids aléatoires, c'est-à-dire sans optimisation, la perte de sortie est de 0.453. L'image ci-dessous représente le réseau avec différentes couleurs.
- En général, la couleur orange représente les valeurs négatives tandis que les couleurs bleues représentent les valeurs positives.
- Les points de données ont la même représentation : les bleus sont les étiquettes positives et les oranges les étiquettes négatives.

Dans la deuxième couche cachée, les lignes sont colorées selon le signe de leur poids. Les lignes orange ont un poids négatif et les bleues un poids positif.
Comme vous pouvez le constater, dans la carte de sortiepingLe réseau commet de nombreuses erreurs. Observez maintenant son comportement après optimisation.
L'image ci-dessous illustre l'exemple de réseau de neurones artificiels (RNA) optimisé. On constate tout d'abord que le réseau a correctement appris à classifier les points de données. En comparaison avec l'image précédente, le poids initial était de -0.43, tandis qu'après optimisation, il est de -0.95.

L'idée peut être généralisée aux réseaux comportant davantage de couches cachées et de neurones. Vous pouvez expérimenter vous-même avec les paramètres dans le Terrain de jeu TensorFlow.
Le tutoriel ci-dessous illustre cette même idée par du code, en utilisant un jeu de données réel.
Comment former un réseau neuronal avec TensorFlow
Voici la procédure étape par étape pour entraîner un réseau neuronal avec TensorFlow Réseau de neurones artificiels (ANN) utilisant l'estimateur DNNClassifier de l'API.
Nous utiliserons l'ensemble de données MNIST pour former votre premier réseau neuronal. Entraîner un réseau de neurones avec TensorFlow Ce n'est pas très compliqué. L'étape de prétraitement est exactement la même que dans les tutoriels précédents. Vous procéderez comme suit :
- Importez les données
- Transformez les données
- Construisez le tenseur
- Construisez le modèle
- Former et évaluer le modèle
- Améliorer le modèle
Note de version : Le code de ce tutoriel est conçu pour l'API Estimator de TensorFlow 1.x. La dernière version du package tf-estimator a été fournie avec TensorFlow 2.15, et tf.estimator a été supprimé dans TensorFlow 2.16. Pour exécuter ces étapes avec une version actuelle, utilisez TensorFlow 2.15 ou reconstruisez le même réseau à deux couches avec tf.keras.layers.Dense et model.fit().
Étape 1) Importez les données
Tout d'abord, vous devez importer la bibliothèque nécessaire. Vous pouvez importer le jeu de données MNIST en utilisant scikit-apprendre comme le montre l'exemple de réseau neuronal TensorFlow ci-dessous.
Le jeu de données MNIST est le plus fréquemment utilisé pour tester de nouvelles techniques ou de nouveaux algorithmes. Il s'agit d'une collection d'images de 28 × 28 pixels, chacune représentant un chiffre manuscrit de 0 à 9. Un ensemble de réseaux de neurones convolutifs profonds, entraînés avec des distorsions élastiques, a permis de réduire le taux d'erreur de test à 0.27 %.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
La procédure d'installation originale téléchargeait manuellement les fichiers MNIST et indiquait à fetch_mldata l'emplacement de ce dossier.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Note relative à l'API : mldata.org n'est plus en ligne et fetch_mldata a été supprimé dans scikit-learn 0.22. Sur une installation actuelle, remplacez l'appel ci-dessus par fetch_openml('mnist_784', version=1), qui télécharge les mêmes 70 000 chiffres et expose les mêmes données et attributs cibles.
Ensuite, vous divisez les données et obtenez la forme des deux ensembles de données.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Étape 2) Transformer les données
Dans le tutoriel précédent, vous avez appris qu'il est nécessaire de transformer les données pour limiter l'influence des valeurs aberrantes. Dans ce tutoriel sur les réseaux de neurones, vous allez transformer les données à l'aide du scaler min-max. La formule est la suivante :
(X-min_x)/(max_x - min_x)
scikit-learn possède déjà une fonction pour cela : MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Étape 3) Construire le tenseur
Vous connaissez désormais la méthode de création tenseurs Dans TensorFlow, vous pouvez convertir l'ensemble d'entraînement en une colonne numérique.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Étape 4) Construire le modèle
L'architecture du réseau neuronal comprend deux couches cachées : la première compte 300 unités et la seconde 100. Ces valeurs sont empiriques et non calculées par une formule. Vous pouvez les ajuster et observer leur impact sur la précision du réseau.
Pour construire le modèle, vous utilisez l'estimateur DNNClassifier. Vous devez définir le nombre de classes à 10, car l'ensemble d'entraînement comporte dix classes. Vous connaissez déjà la syntaxe de l'objet estimateur. Les arguments feature_columns, n_classes et model_dir sont identiques à ceux du tutoriel précédent. L'argument hidden_units est nouveau : il contrôle à la fois le nombre de couches et le nombre de nœuds auxquels chaque couche est connectée au réseau de neurones. Dans le code ci-dessous, il y a deux couches cachées : la première connecte 300 nœuds et la seconde 100.
Pour créer l'estimateur, utilisez tf.estimator.DNNClassifier avec les paramètres suivants :
- colonnes de fonctionnalités : Définissez les colonnes à utiliser dans le réseau
- unités_cachées : Définir le nombre de neurones cachés
- n_classes : Définir le nombre de classes à prédire
- répertoire_modèle : Définir le chemin de Tableau Tenseur
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Étape 5) Former et évaluer le modèle
Vous pouvez utiliser la fonction d'entrée NumPy pour entraîner le modèle et l'évaluer.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Sortie :
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
L'architecture actuelle permet d'atteindre une précision d'environ 96 % sur l'ensemble d'évaluation.
Étape 6) Améliorer le modèle
Vous pouvez essayer d'améliorer le modèle en ajoutant des paramètres de régularisation.
Ici, l'estimateur utilise un optimiseur Proximal AdaGrad avec un taux d'abandon de 0.3 et des forces L1 et L2 fixées à 0.01. Dans un réseau de neurones TensorFlow, l'optimiseur est accessible via l'objet `train` suivi du nom de l'optimiseur. TensorFlow intègre une API pour l'optimiseur Proximal AdaGrad.
Pour ajouter une régularisation au réseau neuronal profond, vous pouvez utiliser tf.train.ProximalAdagradOptimizer avec les paramètres suivants :
- Taux d'apprentissage : taux d'apprentissage
- Régularisation L1 : force de régularisation l1
- Régularisation L2 : force de régularisation l2
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Sortie :
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Les valeurs choisies pour réduire le surapprentissage n'ont pas amélioré la précision du modèle. Votre premier modèle avait une précision de 96 %, tandis que le modèle avec la régularisation L2 atteint 95 %. Vous pouvez essayer différentes valeurs et observer leur impact sur la précision.
