
Valvottu koneoppiminen: Algorithms, tyypit ja esimerkit
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
Ohjattu koneoppiminen kouluttaa algoritmia nimettyjen esimerkkien avulla, jotta se voi ennustaa tuloksia datalle, jota se ei ole aiemmin nähnyt. Tämä menetelmä käyttää regressiota numeeristen kohteiden ja luokittelua kategoriakohteiden, kuten roskapostin tai petosten, osalta.
Mitä on valvottu koneoppiminen?
Ohjattu koneoppiminen on algoritmi, joka oppii merkityistä harjoitustiedoista auttaakseen sinua ennustamaan odottamattomien tietojen tuloksia. Ohjatussa oppimisessa koulutat konetta käyttämällä hyvin "merkittyjä" tietoja. Tämä tarkoittaa, että osa tiedoista on jo merkitty oikeilla vastauksilla. Sitä voidaan verrata oppimiseen ohjaajan tai opettajan läsnä ollessa.
Tarkkojen ohjattujen koneoppimismallien onnistunut rakentaminen, skaalaaminen ja käyttöönotto vaatii aikaa ja teknistä asiantuntemusta erittäin taitavilta datatieteilijöiltä. Datatieteilijöiden on myös rakennettava malleja säännöllisesti uudelleen, jotta heidän tuottamansa tiedot pysyvät paikkansapitävinä pohjana olevan datan muuttuessa.
Kuinka ohjattu oppiminen toimii
Valvottu koneoppiminen käyttää harjoitustietojoukkoja haluttujen tulosten saavuttamiseksi. Nämä tietojoukot sisältävät syötteitä ja oikean tulosteen, joka auttaa mallia oppimaan nopeammin. Haluat esimerkiksi kouluttaa koneen auttamaan sinua ennustamaan, kuinka kauan kestää ajaa kotiin työpaikaltasi.
Tässä aloitat luomalla joukon merkittyjä tietoja. Nämä tiedot sisältävät:
- Sääolosuhteet
- Kellonaika
- Juhlapyhät
- Reitti valittu
Kaikki nämä tiedot ovat sinun syötteitäsi tässä ohjatun oppimisen esimerkissä. Tulosteena on aika, joka kului kotiin ajamiseen kyseisenä päivänä, kuten alla oleva kuva osoittaa.
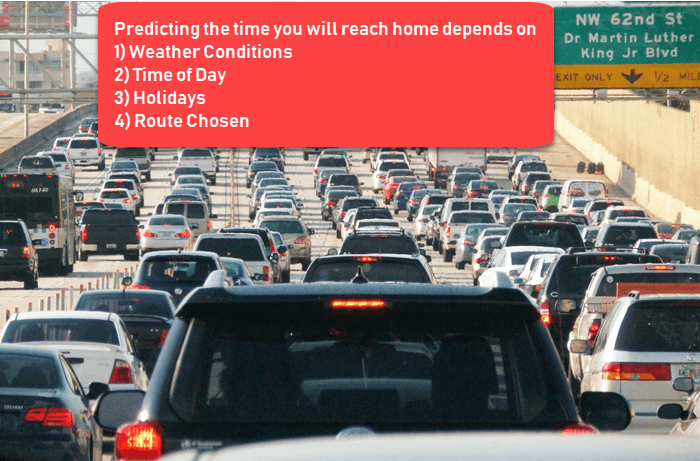
Tiedät vaistomaisesti, että jos ulkona sataa, kotimatka kestää kauemmin. Mutta kone tarvitsee dataa ja tilastoja.
Ensimmäiseksi sinun on luotava harjoitusjoukko. Se sisältää kokonaismatka-ajan ja vastaavat tekijät, kuten sään, ajan jne. Tämän harjoitusjoukon perusteella koneesi saattaa nähdä, että sateen määrän ja kotiinpaluuta varten kuluvan ajan välillä on suora yhteys.
Joten se varmistaa, että mitä enemmän sataa, sitä kauemmin ajat takaisin kotiin. Se saattaa myös nähdä yhteyden työstä lähtöajan ja matka-ajan välillä. Mitä lähempänä kello 6 olet, sitä kauemmin sinulla kestää päästä kotiin.
Koneesi saattaa löytää joitakin yhteyksiä merkittyihin tietoihisi. Tämä oppimisvaihe on esitetty alla.
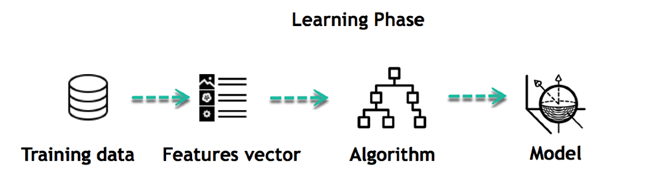
Tämä on datamallisi alku. Se alkaa tallentaa, miten sade vaikuttaa ihmisten ajotapaan ja että enemmän ihmisiä matkustaa tiettyyn aikaan päivästä.
Ohjatun koneoppimisen tyypit Algorithms
Seuraavat ovat valvottujen koneoppimisalgoritmien tyypit:
Regressio
Regressiotekniikka ennustaa yhden jatkuvan lähtöarvon käyttämällä harjoitusdataa.
Esimerkki: Regression avulla voit ennustaa asunnon hinnan koulutustiedoista. Syöttömuuttujat ovat paikkakunta, talon koko jne.
Vahvuudet: Tulosteita on helppo tulkita, ja algoritmia voidaan regularisoida ylisovituksen välttämiseksi.
Heikkoudet: Lineaarinen malli ei ole joustava, joten se ei kuvaa monimutkaisia suhteita ilman lisäominaisuuksia.
Tässä on muutamia regressiotyyppejä Algorithms:
- Lineaarinen regressio
- Polynominen regressio
- Ridge- ja Lasso-regressio
- Logistinen regressio (luokittelua varten)
- Päätöspuu ja satunnainen metsäregressio
- Tukivektorin regressio
Logistinen regressio:
Logistista regressiota käytetään diskreettien arvojen arvioimiseen tietyn riippumattomien muuttujien joukon perusteella. Se auttaa ennustamaan tapahtuman todennäköisyyden sovittamalla tiedot logit-funktioon. Siksi sitä kutsutaan myös logit-regressioksi. Kun se ennustaa todennäköisyyttä, sen lähtöarvo on välillä 0 ja 1, ja se voi suoriutua heikommin, jos päätösrajoja on useita tai ne ovat epälineaarisia.
Luokittelu
Luokittelu tarkoittaa tulosteen ryhmittelyä luokan sisällä. Jos algoritmi yrittää luokitella syötteen kahteen erilliseen luokkaan, sitä kutsutaan binääriluokitteluksi. Useamman kuin kahden luokan välillä valitsemista kutsutaan moniluokkaluokitteluksi.
Esimerkki: Sen määrittäminen, onko joku lainan maksun laiminlyöjä vai ei.
Vahvuudet: Luokittelupuut toimivat käytännössä erittäin hyvin.
Heikkoudet: Rajoittamattomat, yksittäiset puut ovat alttiita ylisovittumiselle.
Tässä on muutamia luokittelutyyppejä Algorithms:
- Naiivit Bayes-luokittelijat
- Päättävät puut
- Tuki Vector Machine
- K-Lähimmät naapurit
- Satunnainen metsä ja gradientin tehostaminen
Naiivit Bayes-luokittelut
Naiivi Bayes Malli on helppo rakentaa ja erittäin hyödyllinen suurille tietojoukoille. Tämä menetelmä koostuu suunnatuista asyklisistä graafeista, joilla on yksi vanhempi ja useita lapsisolmuja. Se olettaa vanhempiinsa erotettujen lapsisolmujen olevan itsenäisiä.
Päätöspuut
Päätöspuut luokittelevat instanssin lajittelemalla sen ominaisuuden arvon perusteella. Tässä menetelmässä jokainen solmu on luokiteltavan instanssin ominaisuus, ja jokainen haara edustaa arvoa, jonka solmu voi olettaa. Se on laajalti käytetty luokittelutekniikka.
Sama rakenne toimii regressiolle: regressiopuu auttaa arvioimaan todellisia arvoja (auton ostohinta, puheluiden määrä, kuukausittainen kokonaismyynti jne.).
Tuki Vector Machine
Support Vector Machine (SVM) on 1990-luvulla esitelty oppimisalgoritmi. Tämä menetelmä perustuu Vladimir Vapnikin ja hänen kollegoidensa kehittämän tilastollisen oppimisteorian tuloksiin.
SVM:t ovat myös läheisesti kytköksissä ytimen funktioihin, jotka ovat keskeinen käsite useimmissa oppimistehtävissä. Ytimen viitekehystä ja SVM:ää käytetään useilla eri aloilla. Se sisältää multimediatiedonhaun, bioinformatiikan ja hahmontunnistuksen. Jokainen yllä oleva estimaattori on dokumentoitu viritysparametreineen scikit opittava viite.
Ohjatut vs. ohjaamattomat koneoppimistekniikat
Menetelmän sijoittaminen viereen ohjaamaton oppiminen tekee rajansa selväksi.
| Perustuen | Valvottu koneoppimistekniikka | Valvomaton koneoppimistekniikka |
|---|---|---|
| Tulotiedot | Algorithms on koulutettu käyttäen merkittyjä tietoja. | Algorithms käytetään sellaisia tietoja vastaan, joita ei ole merkitty |
| Laskennallinen monimutkaisuus | Ohjattu oppiminen on yksinkertaisempi menetelmä. | Ohjaamaton oppiminen on laskennallisesti monimutkaista |
| tarkkuus | Erittäin tarkka ja luotettava menetelmä. | Less tarkka ja luotettava menetelmä. |
| Tyypilliset algoritmit | Logistinen regressio, päätöspuut, SVM, naiivi Bayes | K-keskiarvot, hierarkkinen klusterointi, PCA |
| Miten tuloksia arvioidaan | Pisteytetty tunnettujen vastausten perusteella (tarkkuus, RMSE) | Sisäisten mittareiden ja ihmisen arvioinnin perusteella |
Ohjatun koneoppimisen haasteet
Ohessa on haasteita, joita ohjatussa koneoppimisessa kohtaat:
- Harjoitusdatan epäolennaiset syöttöominaisuudet voivat tuottaa epätarkkoja tuloksia.
- Tietojen valmistelu ja esikäsittely on aina haaste.
- Tarkkuus kärsii, kun harjoitusdatana on syötetty mahdottomia, epätodennäköisiä ja epätäydellisiä arvoja.
- Jos kyseistä asiantuntijaa ei ole saatavilla, toinen lähestymistapa on "raaka voima". Se tarkoittaa, että sinun on arvattava, millä ominaisuuksilla (syöttömuuttujilla) konetta koulutetaan, ja tämä arvaus voi olla epätarkka.
Ohjatun oppimisen edut
Näitä haasteita vasten ohjatun koneoppimisen edut ovat seuraavat:
- Ohjattua oppimista sisään Koneen oppiminen voit kerätä tietoja tai tuottaa tietoa aiempien kokemusten perusteella
- Auttaa optimoimaan suorituskykykriteerit kokemuksen avulla
- Valvottu koneoppiminen auttaa sinua ratkaisemaan erilaisia reaalimaailman laskentaongelmia.
Ohjatun oppimisen haitat
Ohjatun koneoppimisen haitat ovat seuraavat:
- Päätösraja saattaa olla ylikoulutettu, jos harjoitusjoukossasi ei ole esimerkkejä, joita haluat luokassa olevan.
- Sinun on valittava jokaisesta luokasta paljon hyviä esimerkkejä, kun harjoitat luokittelijaa.
- Big datan luokittelu voi olla todellinen haaste.
- Ohjatun oppimisen koulutus vaatii paljon laskenta-aikaa.
Ohjatun oppimisen parhaat käytännöt
Seuraava sarja pitää projektin käynnissä track:
- Ennen kuin teet mitään muuta, päätä, minkä tyyppistä dataa käytetään harjoitusjoukkona.
- Päätä opitun funktion rakenne ja oppimisalgoritmi.
- Kerää vastaavat tulokset joko ihmisasiantuntijoilta tai mittauksista
- Pidä testijoukko, jota malli ei koskaan näe, tallessa ja raportoi sen pisteet.
