
Mitä on vahvistusoppiminen? Tyypit, Algorithms & Esimerkki
 Evelyn Clarke
⚡ Älykäs yhteenveto
Vahvistusoppiminen on koneoppimismenetelmä, jossa ohjelmistoagentti oppii toimimalla tietyssä ympäristössä, keräämällä palkintoja tai rangaistuksia ja mukauttamalla käyttäytymistään maksimoidakseen kumulatiivisen palkkion useiden vaiheiden aikana.
Mitä vahvistusoppiminen on?
Vahvistusoppiminen on Koneen oppiminen menetelmä, joka koskee sitä, miten ohjelmistoagenttien tulisi toimia tietyssä ympäristössä. Agentille ei näytetä oikeita vastauksia; se oppii saamastaan palkkiosta ja mukauttaa toimintaansa maksimoidakseen kumulatiivisen palkkion.
Vahvistusoppiminen on itsenäinen koneoppimisen haara, rinnakkain valvottu ja valvomatta oppiminen. Kun agentin käytäntö- tai arvofunktiota edustaa neuroverkko, yhdistelmää kutsutaan syvävahvistusoppiminen — tuo parittaminen antaa agentille mahdollisuuden saavuttaa monimutkaisen tavoitteen tai maksimoida tietyn ulottuvuuden useiden vaiheiden aikana.
Vahvistusoppimismenetelmän tärkeät osat
Ennen kuin algoritmit ymmärtävät, on hyödyllistä nimetä osat. Alla oleva kaavio näyttää, kuinka agentti, ympäristö, toiminta ja palkitsemissignaali sopivat yhteen silmukaksi.
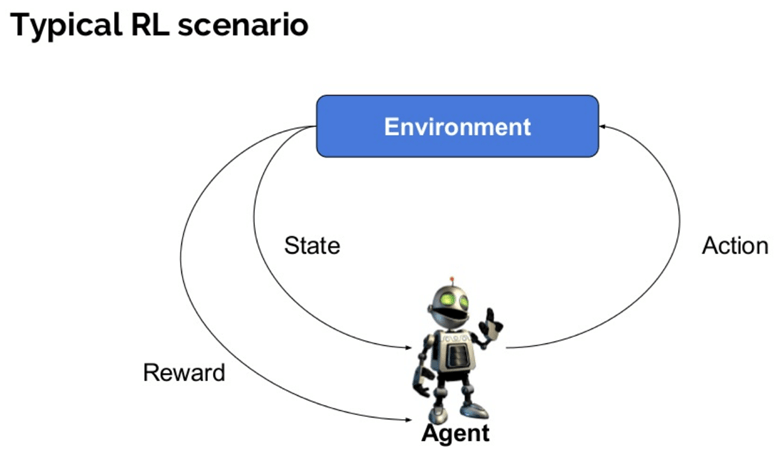
Tässä on joitakin tärkeitä termejä, joita käytetään vahvistusoppimisessa:
- Agentti: Yksikkö, joka suorittaa toimia ympäristössä saadakseen jonkin palkkion.
- Ympäristö (e): Skenaario, joka agentin on kohdattava.
- Palkinto (R): Välitön vastine agentille, kun se suorittaa tietyn toiminnon tai tehtävän.
- Osavaltio(t): Tilalla tarkoitetaan ympäristön palauttamaa nykytilannetta.
- Käytäntö (π): Agentin käyttämä strategia seuraavan toiminnon päättämiseksi nykytilan perusteella.
- Arvo (V): Odotettu pitkän aikavälin tuotto alennuksella verrattuna lyhyen aikavälin palkkioon.
- Arvofunktio: Se määrittää tilan arvon eli kokonaispalkkiomäärän, jonka agentti voi odottaa keräävänsä kyseisestä tilasta alkaen.
- Ympäristön malli: Tämä matkii ympäristön käyttäytymistä. Sen avulla voit tehdä päätelmiä ja määrittää, miten ympäristö käyttäytyy.
- Mallipohjaiset menetelmät: Menetelmät, jotka ratkaisevat vahvistusoppimiseen perustuvia ongelmia oppimalla ensin ympäristöstä tai käyttämällä siitä mallia ja sitten suunnittelemalla sitä vasten.
- Q-arvo tai toiminta-arvo (Q): Q value on melko samankaltainen kuin value. Ainoa ero näiden kahden välillä on, että se ottaa vastaan lisäparametrin, nykyisen toiminnon.
Miten vahvistusoppiminen toimii?
Arkipäivän analogia tekee mekanismin selväksi ennen kuin mitään merkintöjä ilmestyy.
Mieti tilannetta, jossa opetat kissallesi uusia temppuja.
- Koska kissa ei ymmärrä englantia tai mitään muutakaan ihmiskieltä, emme voi käskeä sitä suoraan. Sen sijaan noudatamme erilaista strategiaa.
- Jäljittelemme tilannetta, ja kissa yrittää reagoida monin eri tavoin. Jos kissan reaktio on haluttu, annamme sille kalaa.
- Nyt aina kun kissa altistuu samalle tilanteelle, se suorittaa samanlaisen toiminnan entistä innokkaammin odottaen saavansa lisää palkintoa (ruokaa).
- Se on oppi, jonka kissa saa positiivisten kokemusten kautta siitä, "mitä tehdä".
- Samalla kissa oppii myös, mitä ei pidä tehdä negatiivisten kokemusten kohdatessa.
Esimerkki vahvistusoppimisesta
Alla oleva kuva yhdistää kissan tarinan muodolliseen silmukkaan, jossa kotitalous on ympäristö ja kala palkkiona.
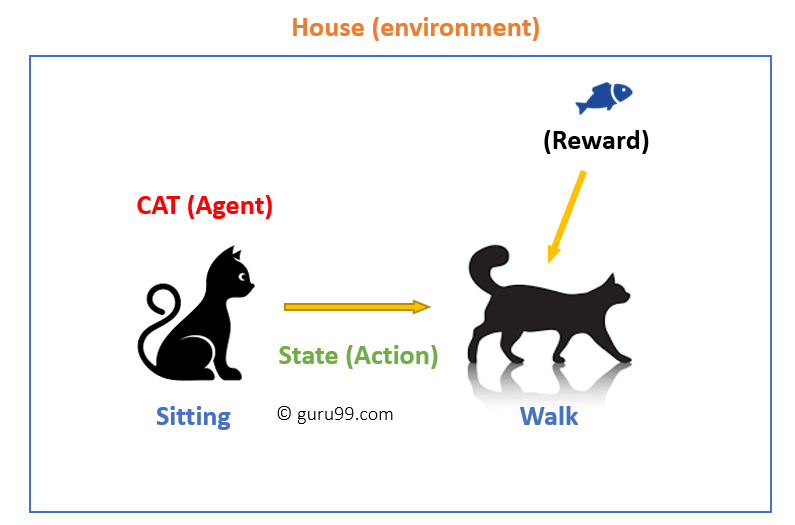
Tässä tapauksessa,
- Kissasi on ympäristölle altistava toimija. Tässä tapauksessa se on talosi. Esimerkki tilasta voisi olla kissasi istumassa ja sinä käytät tiettyä sanaa saadaksesi kissan kävelemään.
- Agenttimme reagoi suorittamalla toimintosiirtymän "tilasta" toiseen "tilaan".
- Esimerkiksi kissasi siirtyy istumasta kävelyyn.
- Agentin reaktio on toiminta, ja politiikka on menetelmä valita toiminta tietyssä tilassa parempia tuloksia odotettaessa.
- Siirtymän jälkeen agentti voi saada palkkion tai rangaistuksen vastineeksi.
Vahvistusoppiminen Algorithms
Vahvistusoppimisen algoritmin toteuttamiseen on kolme lähestymistapaa, ja ne eroavat toisistaan pääasiassa siinä, mitä agentti tallentaa ja oppii.
Arvopohjainen
Arvopohjaisessa vahvistusoppimismenetelmässä pyritään maksimoimaan arvofunktio V(s). Tässä menetelmässä agentti odottaa nykyisten tilojen palautumista pitkällä aikavälillä π-käytännön vallitessa.
Politiikkaan perustuva
Politiikkapohjaisessa RL-menetelmässä yrität keksiä politiikan, jonka mukaan jokaisessa tilassa suoritettava toiminta auttaa sinua saamaan maksimaalisen palkkion tulevaisuudessa.
Kahden tyyppisiä politiikkaan perustuvia menetelmiä ovat:
- Deterministinen: Politiikka π tuottaa saman toiminnon mille tahansa tilalle.
- Stokastinen: Jokaisella toiminnalla on tietty todennäköisyys, joka annetaan seuraavalla yhtälöllä.
Stokastinen käytäntö:
π(a|s) = P[At = a | St = s]
Mallipohjainen
Tässä vahvistusoppimismenetelmässä luot virtuaalimallin jokaiselle ympäristölle. Agentti oppii toimimaan kyseisessä ympäristössä.
Vahvistusoppimisen ominaisuudet
Tässä ovat vahvistusoppimisen tärkeät ominaisuudet:
- Ei ole valvojaa, vain todellinen numero tai palkkiosignaali
- Peräkkäinen päätöksenteko
- Aika on ratkaisevassa roolissa vahvistusongelmissa
- Palaute tulee usein viiveellä eikä välittömästi
- Agentin toimet määräävät sen myöhemmin vastaanottaman tiedon
Vahvistusoppimisen tyypit
Sana ”vahvistus” on lainattu käyttäytymispsykologiasta, ja sitä esiintyy kahdessa muodossa:
positiivinen:
Se määritellään tapahtumaksi, joka tapahtuu tietyn käyttäytymisen seurauksena. Se lisää käyttäytymisen voimakkuutta ja tiheyttä ja vaikuttaa positiivisesti tekijän toimintaan.
Tämän tyyppinen vahvistaminen auttaa maksimoimaan suorituskyvyn ja ylläpitämään muutosta pidemmän aikaa. Liika vahvistaminen voi kuitenkin johtaa tilan ylioptimointiin, mikä voi vaikuttaa tuloksiin.
negatiivinen:
Negatiivinen vahvistus määritellään sellaisen käyttäytymisen vahvistamiseksi, joka johtuu negatiivisesta olosuhteesta, joka olisi pitänyt lopettaa tai välttää. Se auttaa määrittelemään vähimmäissuoritustason. Tämän menetelmän haittapuolena on kuitenkin se, että se tarjoaa vain sen verran, että vähimmäiskäyttäytymisvaatimukset täyttyvät.
Vahvistusmallien oppiminen
Vahvistusoppimisessa on kaksi tärkeää oppimismallia:
- Markovin päätösprosessi
- Q oppiminen
Markovin päätösprosessi
Ratkaisun saamiseksi käytetään seuraavia parametreja:
- Toimenpidesarja – A
- Tilojen joukko – S
- Palkinto – R
- Käytäntö – π
- Arvo – V
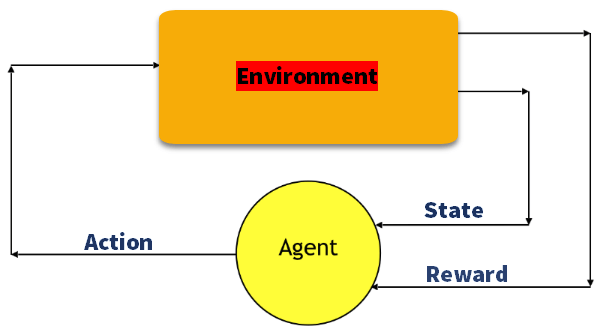
Matemaattinen lähestymistapa karttaanping Vahvistusoppimisen ratkaisu formalisoidaan Markov-päätösprosessiksi eli MDP:ksi. Alla oleva kaavio näyttää nämä viisi parametria kytkettynä samaan agentti-ympäristö-sykliin.
Q-oppiminen
Q-oppiminen on arvoon perustuva menetelmä tiedon toimittamiseen, joka kertoo agentille, mitä toimia hänen tulisi tehdä.
Ymmärretään tämä menetelmä seuraavan esimerkin avulla:
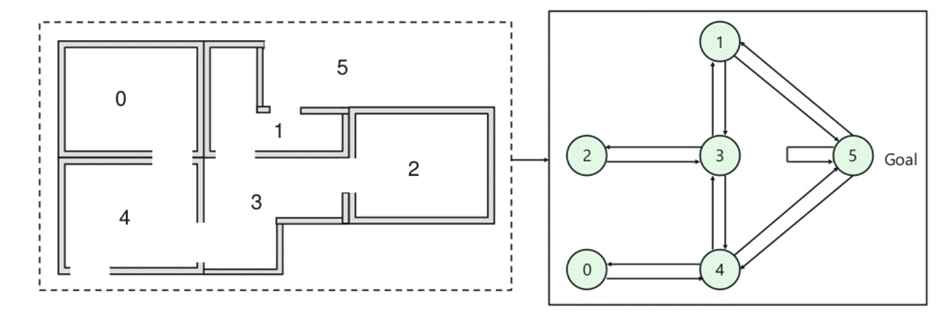
- Rakennuksessa on viisi huonetta, joita yhdistää ovet.
- Jokainen huone on numeroitu 0-4
- Rakennuksen ulkopuolta voidaan käsitellä yhtenä isona ulkoalueena (5)
- Ovet numerot 1 ja 4 johtavat rakennukseen huoneesta 5
Alla oleva pohjapiirros numeroi huoneet ja näyttää, mitkä ovet yhdistävät ne.
Seuraavaksi sinun on liitettävä palkkioarvo jokaiseen oveen:
- Ovet, jotka johtavat suoraan maaliin, saavat 100 palkinnon
- Ovet, jotka eivät ole suoraan yhteydessä kohdehuoneeseen, eivät anna palkintoja.
- Koska ovet ovat kaksisuuntaisia, jokaiselle huoneelle on osoitettu kaksi nuolta
- Jokainen yllä olevan kuvan nuoli kantaa välitöntä palkintoarvoa
Selitys: Tässä kuvassa jokainen huone edustaa tilaa ja agentin liikkuminen huoneesta toiseen edustaa toimintoa.
Alla olevassa kaaviossa tila on piirretty solmuna, ja nuolet näyttävät käytettävissä olevat toiminnot ja niihin liittyvän palkinnon.

Esimerkiksi agentti siirtyy huoneesta numero 2 huoneeseen numero 5:
- Alkutila = tila 2
- Tila 2-> tila 3
- Tila 3 -> tila (2,1,4)
- Tila 4-> tila (0,5,3)
- Tila 1-> tila (5,3)
- Tila 0-> tila 4
Vahvistusoppiminen vs. ohjattu oppiminen
Selkein tapa sijoittaa vahvistusoppiminen on asettaa se useimpien lukijoiden jo tunteman paradigman viereen.
| parametrit | Vahvistusoppiminen | Ohjattu oppiminen |
|---|---|---|
| Päätöksen tyyli | Vahvistusoppiminen auttaa sinua tekemään päätöksiä peräkkäin. | Tässä menetelmässä päätös tehdään alussa annetun syötteen perusteella. |
| Toimii | Toimii vuorovaikutuksessa ympäristön kanssa. | Toimii esimerkkien tai annettujen näytetietojen perusteella. |
| Riippuvuus päätöksestä | RL-menetelmässä jokainen oppimispäätös riippuu sitä edeltävistä päätöksistä, joten koko päätössarja arvioidaan. | In valvottu oppiminen Päätökset ovat toisistaan riippumattomia, joten jokaiselle päätökselle annetaan nimike. |
| Parhaiten soveltuvat | Tukee ja toimii paremmin tekoälyssä, jossa ihmisen vuorovaikutus on yleistä. | Sitä käytetään enimmäkseen interaktiivisella ohjelmistojärjestelmällä tai sovelluksilla. |
| esimerkki | Shakki peli | Objektien tunnistaminen |
Vahvistusoppimisen sovellukset
Tässä on vahvistusoppimisen sovelluksia:
- Robotiikka teollisuusautomaatioon.
- Liiketoimintastrategian suunnittelu
- Koneoppiminen ja tietojenkäsittely
- Se auttaa sinua luomaan koulutusjärjestelmiä, jotka tarjoavat räätälöityä opetusta ja materiaaleja opiskelijoiden vaatimusten mukaisesti.
- Lentokoneen ohjaus ja robotin liikkeenohjaus
Miksi käyttää vahvistusoppimista?
Tässä ovat tärkeimmät syyt vahvistusoppimisen käyttöön:
- Se auttaa sinua löytämään tilanteen, joka vaatii toimia
- Auttaa sinua selvittämään, mikä toiminta tuottaa suurimman palkkion pitkällä aikavälillä
- Vahvistusoppiminen tarjoaa oppimisagentille myös palkitsemistoiminnon
- Se antaa myös agentille mahdollisuuden selvittää parhaan tavan saada suuria palkkioita.
Milloin vahvistusoppimista ei saa käyttää?
Vahvistusoppimismallia ei voida soveltaa kaikissa tilanteissa. Tässä on joitakin tilanteita, joissa sitä ei pitäisi käyttää.
- Kun sinulla on tarpeeksi merkittyä dataa ongelman ratkaisemiseksi ohjatun oppimisen menetelmällä
- Vahvistusoppiminen on laskentatehokasta ja aikaa vievää, erityisesti silloin, kun toiminta-avaruus on suuri.
Vahvistusoppimisen haasteet
Tässä ovat suurimmat haasteet, joita kohtaat vahvistusoppimisen aikana:
- Ominaisuuksien ja palkintojen suunnittelu, joka voi olla hyvin monimutkaista
- Parametrit voivat vaikuttaa oppimisen nopeuteen.
- Realistisissa ympäristöissä voi olla osittainen havaittavuus.
- Liika vahvistus voi johtaa tilojen ylikuormitukseen, mikä voi heikentää tuloksia.
- Realistiset ympäristöt voivat olla ei-stationaarisia.
