
Lineaarisen regression opetusohjelma TensorFlow'lla [esimerkkejä]
 Evelyn Clarke
⚡ Älykäs yhteenveto
TensorFlow'n lineaarinen regressio mallintaa numeeristen ominaisuuksien ja jatkuvan tavoitearvon välistä suhdetta. Tämä läpikäynti kouluttaa Bostonin asuntojen hintaennustajaa kolmella eri tavalla käyttäen Pandas-, NumPy- ja TensorFlow'n natiiveja syöttöputkia LinearRegressor-estimaattorilla.
Mikä on lineaarinen regressio?
Lineaarinen regressio on tilastotieteen lähestymistapa kahden muuttujan välisten yhteyksien mallintamiseen. Tämä mallinnus tehdään skalaarivasteen ja yhden tai useamman selittävän muuttujan välillä. Yhden selittävän muuttujan kanssa tapahtuvaa suhdetta kutsutaan yksinkertaiseksi lineaariseksi regressioksi, ja useamman kuin yhden selittävän muuttujan kanssa tapahtuvaa suhdetta kutsutaan moninkertaiseksi lineaariseksi regressioksi.
TensorFlow tarjoaa työkalut laskelmien täydelliseen hallintaan. Tämä tehdään matalan tason API:lla. Tämän lisäksi TensorFlow on varustettu laajalla valikoimalla API-liittymiä, jotka suorittavat monia koneoppiminen algoritmeja. Tämä on korkean tason API, ja TensorFlow kutsuu niitä estimaattoreiksi.
- Matalan tason APIRakenna arkkitehtuuri ja mallin optimointi tyhjästä. Se on monimutkaista aloittelijalle.
- Korkean tason APIMäärittele algoritmi. Se on käyttäjäystävällinen. TensorFlow tarjoaa työkalupakin nimeltä estimaattori rakentaa, kouluttaa, arvioida ja ennustaa.
Tässä opetusohjelmassa käytät vain arvioijatLaskelmat ovat nopeampia ja helpompia toteuttaa. Ensimmäisessä osassa selitetään, miten gradienttilaskennan optimoijaa käytetään lineaarisen regression kouluttamiseen TensorFlow'ssa. Toisessa osassa käytät Bostonin datajoukkoa ennustaaksesi talon hinnan TensorFlow-estimaattorin avulla.
Kuinka kouluttaa lineaarista regressiomallia
Ennen kuin alamme kouluttaa mallia, katsotaanpa, mitä lineaarinen regressio oikeastaan on.
Kuvittele, että sinulla on kaksi muuttujaa, x ja y, ja tehtäväsi on ennustaa y:n arvo tietäen x:n arvon. Jos piirrät datan kaavioon, näet positiivisen suhteen riippumattoman muuttujan x ja riippuvan muuttujan y välillä, kuten alla oleva hajontakaavio osoittaa.

Saatat huomata, että jos x=1, y on karkeasti ottaen yhtä suuri kuin 6, ja jos x=2, y on noin 8.5.
Tämä ei ole kovin tarkka menetelmä ja on altis virheille, varsinkin satoja tuhansia pisteitä sisältävän tietojoukon kanssa.
Lineaarinen regressio arvioidaan yhtälön avulla. Muuttuja y selitetään yhdellä tai usealla yhteismuuttujalla. Esimerkissäsi on vain yksi riippuvainen muuttuja. Jos sinun on kirjoitettava tämä yhtälö, se on:

Kanssa:
 on harha. Eli jos x=0, y=
 on x:ään liittyvä paino
 on jäännös eli mallin virhe. Se sisältää sen, mitä malli ei voi oppia datasta.
Kuvittele, että sovit malliin ja löydät seuraavan ratkaisun:
- = 3.8
- = 2.78
Voit korvata nämä luvut yhtälössä ja siitä tulee:
y = 3.8 + 2.78x
Sinulla on nyt parempi tapa löytää y:n arvot. Eli voit korvata x:n millä tahansa arvolla ennustaaksesi y:n. Alla olevassa kuvassa olemme korvanneet x:n yhtälössä kaikilla tietojoukon arvoilla ja piirtäneet tuloksen.

Punainen viiva edustaa sovitettua arvoa eli y:n arvoja kullekin x:n arvolle. Sinun ei tarvitse nähdä x:n arvoa ennustaaksesi y:n; jokaiselle x:lle on arvo, joka kuuluu punaiselle viivalle. Voit myös ennustaa x:n arvoja, jotka ovat suurempia kuin 2.
Jos haluat laajentaa lineaarista regressiota useampiin kovariaatteihin, voit tehdä sen lisäämällä malliin useampia muuttujia. Perinteisen analyysin ja lineaarisen regression välinen ero on se, että lineaarinen regressio tarkastelee, miten y reagoi kunkin muuttujan x suhteen erikseen tarkasteltuna.
Katsotaanpa esimerkkiä. Kuvittele, että haluat ennustaa jäätelöbaarin myyntiä. Aineisto sisältää erilaisia tietoja, kuten säästä (sateinen, aurinkoinen, pilvinen) ja asiakkaista (palkka, sukupuoli, siviilisääty).
Perinteisessä analyysissä yritetään ennustaa myyntiä esimerkiksi laskemalla kunkin muuttujan keskiarvo ja yrittämällä arvioida myyntiä eri skenaarioissa. Tämä johtaa huonoihin ennusteisiin ja rajoittaa analyysin valittuun skenaarioon.
Jos käytät lineaarista regressiota, voit kirjoittaa tämän yhtälön:
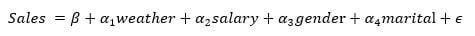
Algoritmi löytää parhaan ratkaisun painoille; se tarkoittaa, että se pyrkii minimoimaan kustannukset, jotka ovat sovitetun suoran ja datapisteiden välinen ero.
Kuinka algoritmi toimii
Alla oleva kaavio tiivistää algoritmin toistaman silmukan: valitse painot, ennusta y:n, mittaa virheen ja korjaa painot.

Algoritmi valitsee kullekin satunnaisluvun  ja
 ja korvaa x:n arvo saadaksesi y:n ennustetun arvon. Jos tietojoukossa on 100 havaintoa, algoritmi laskee 100 ennustettua arvoa.
Voimme laskea virheen, huomautti  , joka on ennustetun arvon ja todellisen arvon välinen erotus. Positiivinen virhe tarkoittaa, että malli aliarvioi y:n ennusteen, ja negatiivinen virhe tarkoittaa, että malli yliarvioi y:n ennusteen.

Tavoitteenasi on minimoida virheen neliö. Algoritmi laskee neliövirheen keskiarvon. Tätä vaihetta kutsutaan virheen minimoimiseksi. Lineaarisessa regressiossa tämä on Keskimääräinen neliövirhe, jota kutsutaan myös MSE:ksi. Matemaattisesti se on:

Missä:
 ovat painot, joten
 viittaa ennustettuun arvoon
- y on todelliset arvot
- m on havaintojen lukumäärä
 viittaa ennustettuun arvoon
Huomaa, että  tarkoittaa, että se käyttää matriisien transponointia. The
 on keskiarvon matemaattinen merkintä.
Tavoitteena on löytää paras  joka minimoi MSE:n.
Jos keskimääräinen virhe on suuri, se tarkoittaa, että malli toimii huonosti ja painoja ei ole valittu oikein. Painot korjataksesi sinun on käytettävä optimoijaa. Perinteinen optimoija on ns Kaltevuuslasku.
Gradienttilasku ottaa derivaatan ja pienentää tai lisää painoa. Jos derivaatta on positiivinen, painoa pienennetään. Jos derivaatta on negatiivinen, painoa lisätään. Malli päivittää painot ja laskee virheen uudelleen. Tätä prosessia toistetaan, kunnes virhe ei enää muutu. Jokaista läpimenoa kutsutaan iteraatioLisäksi gradientit kerrotaan oppimisnopeudella, joka osoittaa oppimisen nopeuden.
Jos oppimisnopeus on liian pieni, algoritmin konvergenssi kestää hyvin kauan, koska se vaatii paljon enemmän iteraatioita. Jos oppimisnopeus on liian korkea, algoritmi ei välttämättä koskaan konvergoi. Alla oleva häviökäyrä kuvaa virheen iteraatiomäärän funktiona tälle tietojoukolle.

Yllä olevasta kuvasta näkyy, että malli toistaa prosessin noin 20 kertaa ennen kuin löytää painoille vakaan arvon, jolloin virhe on pienin.
Huomaa, että virhe ei ole nolla, vaan vakiintuu noin arvoon 5. Tämä tarkoittaa, että mallin tyypillinen virhe on 5. Jos haluat pienentää virhettä, sinun on lisättävä malliin enemmän tietoa, kuten enemmän muuttujia, tai käytettävä erilaisia estimaattoreita.
Muistatko ensimmäisen yhtälön:

Lopulliset painot ovat 3.8 ja 2.78. Alla oleva video näyttää, kuinka gradienttilasku optimoi häviöfunktion näiden painojen löytämiseksi.
Lineaarisen regression harjoittaminen TensorFlow'lla
Nyt kun ymmärrät paremmin, mitä konepellin takana tapahtuu, olet valmis käyttämään TensorFlow'n tarjoamaa estimaattorisovellusliittymää ensimmäisen lineaarisen regression harjoittamiseen TensorFlow'n avulla.
Versiohuomautus: Alla esitetty estimaattorin työnkulku on kirjoitettu TensorFlow 1.x:ää ja varhaisia 2.x-julkaisuja vasten. TensorFlow merkitsi tf.estimator ja tf.feature_column API-rajapinnat vanhentuivat kokonaan versiossa 2.12 ja estimaattorit poistettiin versiossa 2.16. Nykyisessä asennuksessa suorita tämä koodi TensorFlow 1.15- tai 2.x-versiossa-tf.compat.v1 ympäristöön tai siirrä se Kerasiin, jossa tf.keras.layers.Dense(1) Lisäksi esikäsittelykerrokset korvaavat LinearRegressorin ja ominaisuussarakkeet. Käsitteet – ominaisuudet, otsikot, erät, epookat, MSE ja gradienttilaskeutuminen – säilyvät muuttumattomina.
Käytät Bostonin tietojoukkoa, joka sisältää seuraavat muuttujat.
| Muuttuja | Tuotetiedot |
| rikos | rikollisuus asukasta kohden kaupungeittain |
| zn | yli 25,000 XNUMX neliömetrin suuruisille tonteille kaavoitetun asuinmaan osuus. |
| Indus | osuus vähittäiskaupan ulkopuolisista eekkeristä kaupunkia kohden. |
| nox | typen oksidien pitoisuus |
| rm | keskimääräinen huonemäärä asuntoa kohden |
| ikä | ennen vuotta 1940 rakennettujen omistusasuntojen osuus |
| DIS | painotetut etäisyydet viiteen Bostonin työvoimakeskukseen |
| vero | täysiarvoinen kiinteistöveroprosentti 10,000 XNUMX dollaria kohden |
| ptratio | oppilaiden ja opettajien välinen suhde kaupungeittain |
| medv | Omistusasuntojen mediaaniarvo tuhansissa dollareissa |
Luot kolme erilaista tietojoukkoa:
| aineisto | tavoite | muoto |
| koulutus | Harjoittele mallia ja hanki painot | 400, 10 |
| Arviointi | Arvioi mallin suorituskykyä näkymättömillä tiedoilla | 100, 10 |
| Ennustaa | Käytä mallia talon arvon ennustamiseen uusien tietojen perusteella | 6, 10 |
Tavoitteena on käyttää tietojoukon ominaisuuksia talon arvon ennustamiseen.
Tutoriaalin toisessa osassa opit käyttämään TensorFlow'ta kolmella eri tavalla datan tuomiseen:
- Pandan kanssa
- Kanssa nuhjuinen
- Vain TensorFlow
Huomaa, että kaikki kolme vaihtoehtoa antavat saman tuloksen.
Opit käyttämään korkean tason API:a TensorFlow-lineaarisen regressiomallin rakentamiseen, kouluttamiseen ja arviointiin. Jos käyttäisit matalan tason API:a, sinun olisi määriteltävä käsin:
- Tappio-toiminto
- Optimoija: gradientin lasku
- Matriisin kertolasku
- Graafi ja tensori
Tämä on aloittelijalle työlästä ja monimutkaisempaa.
Pandas-ratkaisu
Sinun on tuotava tarvittavat kirjastot mallin kouluttamiseksi.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Vaihe 1) Tuo tiedot sovelluksella Panda.
Määrittelet sarakkeiden nimet ja tallennat ne COLUMNS-luetteloon. Voit tuoda tiedot pd.read_csv()-funktiolla.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Osoita jokainen puhelu aiemmin lataamiisi CSV-tiedostoihin.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Voit tulostaa tietojen muodon.
print(training_set.shape, test_set.shape, prediction_set.shape)
ulostulo
(400, 10) (100, 10) (6, 10)
Huomaa, että otsikko eli y-arvosi sisältyy tietojoukkoon. Sinun on siis määriteltävä kaksi muuta listaa: toinen, joka sisältää vain ominaisuudet, ja toinen, jossa on vain otsikon nimi. Nämä kaksi listaa kertovat estimaattorillesi, mitä ominaisuuksia tietojoukossa on ja mikä sarake on otsikko.
Se tehdään alla olevalla koodilla.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Vaihe 2) Muunna tiedot
Sinun täytyy muuntaa numeeriset muuttujat oikeaan muotoon. TensorFlow tarjoaa metodin jatkuvan muuttujan muuntamiseen: tf.feature_column.numeric_column().
Edellisessä vaiheessa määrittelit listan ominaisuuksista, jotka haluat sisällyttää malliin. Nyt voit käyttää tätä listaa muuntaaksesi ne numeeriseksi dataksi. Jos haluat jättää ominaisuuksia pois mallistasi, voit poistaa yhden tai useamman muuttujan FEATURES-listasta ennen feature_cols-muuttujaa.
Huomaa, että käytät Python Listan ymmärtäminen FEATURES-listalla luodaksesi uuden listan nimeltä feature_cols. Sen avulla vältät tf.feature_column.numeric_column()-funktion kirjoittamisen yhdeksän kertaa. Listan ymmärtäminen on nopeampi ja siistimpi tapa luoda uusia listoja.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Vaihe 3) Määrittele estimaattori
Tässä vaiheessa sinun on määriteltävä estimaattori. TensorFlow tarjoaa kuusi valmiiksi rakennettua estimaattoria, kolme luokittelutehtäviin ja kolme TensorFlow-regressiotehtäviin:
- Regressori
- DNNRegressor
- Lineaarinen regressori
- DNNLineaarinen yhdistetty regressori
- luokittelija
- DNNC-luokitus
- Lineaarinen luokitin
- DNNLineaarinen yhdistetty luokitin
Tässä opetusohjelmassa käytät lineaarista regressoria. Voit käyttää tätä toimintoa käyttämällä tf.estimator-ohjelmaa.
Funktio tarvitsee kaksi argumenttia:
- feature_columns: sisältää malliin sisällytettävät muuttujat
- model_dir: polku graafin tallentamiseen, malliparametrien tallentamiseen jne.
TensorFlow luo automaattisesti työhakemistoosi kansion nimeltä train. Sinun on käytettävä tätä polkua päästäksesi siihen Tensorboard, kuten alla olevassa TensorFlow-regressio-esimerkissä on esitetty.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
ulostulo
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
TensorFlow'n hankala puoli on mallin syöttäminen. TensorFlow on suunniteltu toimimaan rinnakkaislaskennan ja erittäin suurten tietojoukkojen kanssa. Koneresurssien rajallisuuden vuoksi on mahdotonta syöttää malliin kaikkea dataa kerralla. Sitä varten sinun on syötettävä erä dataa joka kerta. Huomaa, että puhumme valtavista tietojoukoista, joissa on miljoonia tai enemmän tietueita. Jos et lisää erää, seurauksena on muistivirhe.
Jos tietosi sisältävät esimerkiksi 100 havaintoa ja määrität eräkoon 10, se tarkoittaa, että malli näkee 10 havaintoa jokaisessa iteraatiossa (10*10).
Kun malli on nähnyt kaiken datan, se suorittaa yhden epookin loppuun. Epookki määrittää, kuinka monta kertaa haluat mallin näkevän datan. On parempi asettaa tämä vaihe arvoon nolla ja antaa mallin suorittaa tietyn määrän iteraatioita.
Toinen lisättävä tieto on, haluatko sekoittaa datan ennen jokaista iteraatiota. Koulutuksen aikana on tärkeää sekoittaa data, jotta malli ei opi tiettyä datajoukon kaavaa. Jos malli oppii datan taustalla olevan kaavan yksityiskohdat, sillä on vaikeuksia yleistää ennustetta näkymättömälle datalle. Tätä kutsutaan ylisovitukseksi. Malli toimii hyvin koulutusdatan kanssa, mutta ei pysty ennustamaan oikein näkymätöntä dataa.
TensorFlow tekee näistä kahdesta vaiheesta helppoja. Kun data siirtyy käsittelyputkeen, se tietää, kuinka monta havaintoa se tarvitsee (eräkäsittely) ja pitääkö sen sekoittaa dataa.
Voit ohjeistaa TensorFlow'ta mallin syöttämisessä käyttämällä pandas_input_fn-funktiota. Tämä objekti tarvitsee viisi parametria:
- x: ominaisuustiedot
- y: etikettitiedot
- eräkoko: erä. Oletuksena 128
- num_epoch: epookkien lukumäärä, oletuksena 1
- shuffle: sekoittaako tiedot vai ei. Oletusarvoisesti ei mitään
Sinun täytyy syöttää mallille tietoja monta kertaa, joten määrittelet funktion tämän prosessin toistamiseksi. Kutsu tätä funktiota get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Tavallinen menetelmä mallin suorituskyvyn arvioimiseksi on:
- Harjoittele mallia
- Mallin arviointi eri tietojoukolla
- Tee ennustus
TensorFlow-estimaattori tarjoaa kolme erilaista funktiota näiden kolmen vaiheen suorittamiseksi helposti.
Vaihe 4) Harjoittele mallia
Voit käyttää estimaattorijuna-metodia mallin sovittamiseen. Juna-estimaattori tarvitsee input_fn-muuttujaan ja useita vaiheita. Voit käyttää yllä luomaasi funktiota mallin syöttämiseen. Sitten käsket mallia iteroitumaan 1000 kertaa. Huomaa, että et määritä epookkien määrää; annat mallin iteroitua 1000 kertaa. Jos asetat epookkien määrän arvoon 1, malli iteroituu neljä kertaa, koska harjoitusjoukossa on 400 tietuetta ja erän koko on 128:
- 128-rivit
- 128-rivit
- 128-rivit
- 16-rivit
Siksi on helpompi asettaa epookkien määräksi nolla ja määritellä iteraatioiden määrä, kuten alla olevassa TensorFlow-luokitteluesimerkissä on esitetty.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Voit tarkistaa TensorBoardin seuraavalla komennolla:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Vaihe 5) Arvioi mallisi
Voit arvioida mallisi sopivuuden testisarjaan alla olevalla koodilla:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Voit tulostaa tappion alla olevalla koodilla:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
ulostulo
Loss: 3215.895996
Mallin tappio on 3215. Voit tarkistaa yhteenvetotilastoista käsityksen virheen suuruudesta.
training_set['medv'].describe()
ulostulo
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Yllä olevasta yhteenvetotilastosta tiedät, että talon keskihinta on 22 tuhatta, ja vähimmäishinta on 5 tuhatta ja enimmäishinta 50 tuhatta. Koska ilmoitettu tappio on keskimääräinen neliövirhe, tyypillinen virhe alkuperäisissä yksiköissä on karkeasti neliöjuuri 32.16, mikä on noin 5.7 tuhatta dollaria.
Vaihe 6) Tee ennustus
Lopuksi voit käyttää estimaattori TensorFlow-ennustusmenetelmää kuuden Bostonin talon arvon arvioimiseen.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Voit tulostaa arvioidut arvot tällä koodilla:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Malli ennustaa seuraavat arvot:
| Talo | Ennustus |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Huomaa, ettemme tiedä näiden kuuden talon todellista arvoa. Syväoppimisoppaassa yrität voittaa lineaarisen mallin.
NumPy-ratkaisu
Tässä osiossa selitetään, miten mallia koulutetaan käyttämällä NumPy-estimaattoria datan syöttämiseen. Menetelmä on sama, paitsi että käytät numpy_input_fn-estimaattoria.
Lue samat kolme CSV-tiedostoa, mutta säilytä vain raakat NumPy-taulukot .values-tiedostoilla.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Vaihe 1) Tuo tiedot
Ensinnäkin sinun on erotettava ominaisuusmuuttujat otsikosta. Tämä on tehtävä harjoitusdatalle ja arviointidatalle. On nopeampaa määritellä funktio datan jakamiseksi.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Voit käyttää funktiota erottaaksesi junan ominaisuuksista otsikon ja arvioidaksesi tietojoukkoja.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Sinun on jätettävä ennusteaineiston viimeinen sarake pois, koska se sisältää vain NaN-arvoa.
x_predict = prediction_set_n[:, :-2]
Vahvista taulukon muoto. Huomaa, että otsikolla ei saa olla toista ulottuvuutta, eli (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
ulostulo
(400, 9) (400,) (6, 9)
Voit rakentaa ominaisuussarakkeet seuraavasti:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Estimaattori määritellään kuten aiemmin: määrität ominaisuussarakkeet ja graafin tallennuspaikan.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
ulostulo
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Voit käyttää NumPy-estimaattoria datan syöttämiseen malliin ja sitten mallin kouluttamiseen. Huomaa, että määrittelemme input_fn-funktion etukäteen luettavuuden helpottamiseksi.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Toistat saman vaiheen eri syöttöfunktiolla mallisi arvioimiseksi.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Lopuksi voit laskea ennusteen. Sen pitäisi olla samanlainen kuin Pandasin tulos.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow-ratkaisu
Viimeinen osio on omistettu puhtaalle TensorFlow ratkaisu. Tämä menetelmä on hieman monimutkaisempi kuin kaksi muuta.
Huomaa, että jos käytät Jupyter muistikirjasinun on käynnistettävä uudelleen ja tyhjennettävä ydin tämän istunnon suorittamiseksi.
TensorFlow on rakentanut loistavan työkalun datan välittämiseen prosessiin. Tässä osiossa rakennat input_fn-funktion itse.
Vaihe 1) Määritä tietojen polku ja muoto
Ensinnäkin, määrittelet kaksi muuttujaa ja niiden polun CSV-tiedostoille. Huomaa, että sinulla on kaksi tiedostoa, yksi harjoitusjoukolle ja yksi testijoukolle.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Sitten sinun on määriteltävä CSV-tiedostosta sarakkeet, joita haluat käyttää. Käytämme niitä kaikkia. Sen jälkeen sinun on määriteltävä kunkin muuttujan tyyppi.
Liukulukumuuttujat määritellään [0.]:lla.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Vaihe 2) Määritä input_fn-funktio
Funktio voidaan jakaa kolmeen osaan:
- Tuo tiedot
- Luo iteraattori
- Käytä dataa
Alla on yleinen koodi funktion määrittelemiseksi. Koodi selitetään myöhemmin.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Tuo tiedot
CSV-tiedostossa dataset-metodi lukee yhden rivin kerrallaan. Datasetin rakentamiseen sinun on käytettävä objektia TextLineTietojoukko. Tietojoukollasi on otsikko, joten sinun on käytettävä skip(1):tä ohittaaksesi ensimmäisen rivin. Tässä vaiheessa luet vain tiedot ja jätät otsikon pois prosessista. Mallin syöttämiseksi sinun on erotettava ominaisuudet otsikosta. Datan muuntaminen tehdään map-menetelmällä.
Tämä metodi kutsuu funktiota, jonka luot ohjeistaaksesi datan muuntamista. Lyhyesti sanottuna sinun on välitettävä data TextLineTietojoukko-objekti, sulje pois otsikko ja käytä funktion ohjaamaa muunnosta.
Code selitys
- tf.data.TextLineDataset(data_file): tämä rivi lukee CSV-tiedoston
- .skip(1): ohittaa otsikon
- .map(parse_csv)): jäsentää tietueet tensoreiksi
Sinun täytyy määritellä funktio karttaobjektin ohjaamiseksi. Voit kutsua tätä funktiota nimellä parse_csv.
Tämä funktio jäsentää CSV-tiedoston tf.decode_csv-metodilla ja määrittää ominaisuudet ja niiden tunnisteen. Ominaisuudet voidaan määrittää sanakirjana tai tuplena. Sanakirja-metodia käytetään kätevämmin.
Code selitys
- tf.decode_csv(arvo, record_defaults= RECORDS_ALL): menetelmä decode_csv käyttää TextLineCSV-tiedoston lukemiseen tarkoitettu tietojoukko. record_defaults antaa TensorFlow'lle ohjeita saraketyypeistä. TensorFlow 2.x:ssä tämä symboli sijaitsee osoitteessa tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): täyttää sanakirjan kaikilla sarakkeilla, esim.tracted tämän tietojenkäsittelyn aikana
- features.pop('medv'): poistaa kohdemuuttujan ominaisuusmuuttujista ja luo otsikkomuuttujan
Datajoukko tarvitsee lisää elementtejä tensoreiden iteratiiviseen syöttämiseen. Sinun on itse asiassa lisättävä metodi "repeat", jotta datajoukko voi jatkaa mallin syöttämistä loputtomiin. Jos et lisää metodia, malli iteroituu vain kerran ja heittää sitten virheen, koska putkeen ei syötetä enempää dataa.
Tämän jälkeen voit hallita erän kokoa batch-metodilla. Se tarkoittaa, että kerrot datajoukolle, kuinka paljon dataa haluat välittää putkeen jokaisella iteraatiolla. Jos asetat suuren erän koon, malli hidastuu.
Vaihe 3) Luo iteraattori
Nyt olet valmis toiseen vaiheeseen: luo iteraattori palauttamaan tietojoukon elementit.
Yksinkertaisin tapa luoda operaattori on menetelmä make_one_shot_iterator.
Tämän jälkeen voit luoda ominaisuuksia ja tunnisteita iteraattorista.
Vaihe 4) Käytä dataa
Voit tarkistaa, mitä tapahtuu input_fn-funktiolla. Sinun on kutsuttava funktiota istunnon aikana datan käsittelemiseksi. Kokeile eräkokoa 1.
Huomaa, että se tulostaa sanakirjan ominaisuudet ja otsikon taulukkona.
Se näyttää CSV-tiedoston ensimmäisen rivin. Voit yrittää suorittaa tätä koodia useita kertoja eri eräkoilla.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
ulostulo
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Vaihe 5) Määritä ominaisuussarake
Sinun on määriteltävä numeeriset sarakkeet seuraavasti:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Huomaa, että sinun on yhdistettävä kaikki muuttujat samassa säiliössä.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Vaihe 6) Rakenna malli
Voit harjoitella mallia estimaattorilla LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
ulostulo
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Sinun on käytettävä a lambda -toiminto jotta voit kirjoittaa argumentit funktiolle input_fn. Jos et käytä lambda-funktiota, et voi kouluttaa mallia.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Voit arvioida mallisi sopivuuden testisarjaan alla olevalla koodilla:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Viimeinen vaihe on kohteen arvon ennustaminen ominaisuusmatriisin arvon perusteella. Voit kirjoittaa sanakirjan ennustettavista arvoista. Mallissasi on yhdeksän ominaisuutta, joten sinun on annettava arvo jokaiselle. Malli antaa ennusteen jokaiselle niistä.
Alla olevaan koodiin kirjoitat kunkin df_predict CSV-tiedostossa olevan ominaisuuden arvot.
Sinun täytyy kirjoittaa uusi input_fn-funktio, koska datasetissä ei ole otsikkoa. Voit käyttää from_tensors-API:a dataset-objektista.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Lopuksi tulostat ennusteet.
for pred in enumerate(pred_results):
print(pred)
ulostulo
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Kaikki kolme putkistoa palauttavat samat kuusi ennustetta, mikä vahvistaa, että valinta Pandasin, NumPyn ja natiivin TensorFlow-tietojoukon välillä on kätevyys-, ei tarkkuuskysymys.
