
Gaussin ydin koneoppimisessa: Python Ytimen menetelmät
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
Gaussin ydinmenetelmät tekevät erotettavissa olevasta datasta lineaarisesti erotettavissa ilman, että koskaan tarvitsee rakentaa korkeaulotteista ominaisuuskarttaa. Tämä läpikäynti näyttää polynomikartan.ping käsin ja kouluttaa sitten satunnaisen Fourier-ydinluokittelijan TensorFlow'ssa.
Tämän opetusohjelman tarkoituksena on tehdä tietojoukosta lineaarisesti erotettavissa. Opetusohjelma on jaettu kahteen osaan:
- Ominaisuuden muunnos
- Ytimen luokittelijan kouluttaminen TensorFlow'lla
Ensimmäisessä osassa ymmärrät koneoppimisen ydinmetodin taustalla olevan idean, kun taas toisessa osassa näet, miten ydinluokittelijaa koulutetaan TensorFlowKäytät aikuisille tarkoitettua tietojoukkoa. Tämän tietojoukon tavoitteena on luokitella alle ja yli 50 000 euron tulot tietäen kunkin kotitalouden käyttäytymisen.
Miksi tarvitset ydinmenetelmiä?
Jokaisen luokittelijan tavoitteena on ennustaa luokat oikein. Tätä varten datajoukon tulisi olla erotettavissa. Katso alla olevaa kuvaajaa; on melko yksinkertaista nähdä, että kaikki mustan viivan yläpuolella olevat pisteet kuuluvat ensimmäiseen luokkaan ja muut pisteet toiseen luokkaan. On kuitenkin erittäin harvinaista, että datajoukko on näin yksinkertainen. Useimmissa tapauksissa data ei ole erotettavissa, ja erotettavissa oleva data vaikeuttaa naiivien luokittelijoiden, kuten logistisen regression, toimintaa.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Alla olevassa kuvassa piirrämme aineiston, joka ei ole lineaarisesti separoituva. Jos piirrämme suoran viivan, useimmat pisteet eivät luokitella oikeaan luokkaan.
Yksi tapa ratkaista tämä ongelma on muuntaa datajoukko toiseksi ominaisuuskartaksi. Tämä tarkoittaa, että käytät funktiota siirtääksesi datan toiseen tasoon, jonka pitäisi olla lineaarisesti separoituva.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
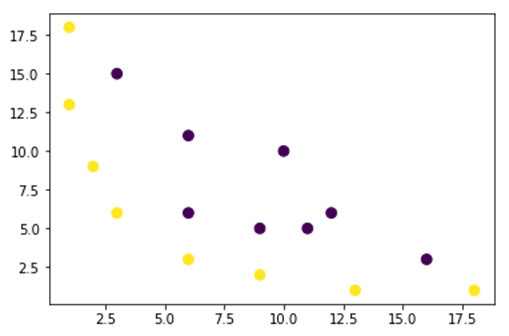
Yllä olevan kuvan tiedot sijaitsevat kaksiulotteisessa tasossa, eikä niitä voida erottaa toisistaan. Voit yrittää muuntaa tiedot kolmiulotteisiksi, eli luoda kuvan, jossa on kolme akselia.
Gaussin ytimen esimerkissämme käytämme polynomikarttaaping tuodaksemme datamme kolmanteen ulottuvuuteen. Datan muuntamiskaava on seuraava.

Voit määrittää funktion Gaussin ytimessä Python uusien ominaisuuskarttojen luomiseksi.
Voit käyttää nuhjuinen koodata yllä oleva kaava. Jokainen alla oleva rivi yhdistää yhden kartan terminping taulukkolausekkeella, joka sen tuottaa, ja pieni kuva merkitsee kahden tekijän neliöjuurta.
| Kaava | Vastaava NumPy-koodi |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Uusi karttaping siinä on 3 ulottuvuutta ja 16 pistettä.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Piirrä nyt uusi kuvaaja, jossa on kolme akselia, x, y ja z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Näemme parannusta, mutta jos muutamme kuvaajan suuntaa, käy selväksi, että tietojoukko on nyt erotettavissa.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Jos joudut käsittelemään suurta tietojoukkoa ja luomaan yli kaksi ulottuvuutta, kohtaat yllä olevan menetelmän kanssa suuren ongelman. Itse asiassa sinun on muunnettava kaikki datapisteet, mikä ei selvästikään ole kestävää. Se vie ikuisuuden, ja tietokoneesi muisti saattaa loppua kesken.
Yleisin tapa ratkaista tämä ongelma on käyttää kerneliä.
Mikä on ydin koneoppimisessa?
Ajatuksena on käyttää korkeamman ulottuvuuden ominaisuusavaruutta, jotta datasta tulisi lähes lineaarisesti erotettavissa, kuten yllä olevassa kuvassa on esitetty.
On paljon korkeamman ulottuvuuden avaruuksia, jotka tekevät datapisteistä erotettavissa olevia. Olemme esimerkiksi osoittaneet, että polynomikuvausping on loistava aloitus.
Olemme myös osoittaneet, että suurten datamäärien kanssa nämä muunnokset eivät ole tehokkaita. Sen sijaan voit käyttää koneoppimisen ydinfunktiota datan muokkaamiseen siirtymättä uuteen ominaisuustasoon.
Ytimen taika on löytää funktio, joka välttää kaikki moniulotteisen laskennan aiheuttamat ongelmat. Ytimen tulos on skalaari, tai toisin sanoen olemme takaisin yksiulotteisessa avaruudessa.
Kun olet löytänyt tämän funktion, voit kytkeä sen standardiin lineaariseen luokittelijaan.
Tässä on esimerkki, joka tekee ydinkoneoppimisen käsitteen konkreettiseksi. Sinulla on kaksi vektoria, x1 ja x2. Tavoitteena on luoda korkeampi ulottuvuus käyttämällä polynomikuvausta.pingTuloste on yhtä suuri kuin uuden ominaisuuskartan pistetulo. Yllä olevasta menetelmästä sinun on tehtävä seuraava:
- Muunna x1 ja x2 uudeksi ulottuvuudeksi
- Laske pistetulo: yhteinen kaikille ytimille
Muunna x1 ja x2 uudeksi ulottuvuudeksi
Voit käyttää yllä luotua funktiota korkeamman ulottuvuuden laskemiseen.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
ulostulo
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Laske pistetulo
Voit käyttää objektipistettä kohdasta nuhjuinen laskeakseen x_1:een tallennetun ensimmäisen ja toisen vektorin pistetulon.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Tuloste on 8100. Näet ongelman: sinun on tallennettava uusi ominaisuuskartta muistiin pistetulon laskemiseksi. Jos sinulla on miljoonia tietueita sisältävä tietojoukko, se on laskennallisesti tehoton.
Sen sijaan voit käyttää polynomiydintä pistetulon laskemiseen vektoria muuntamatta. Tämä funktio laskee x1:n ja x2:n pistetulon ikään kuin nämä kaksi vektoria olisi muunnettu korkeampaan ulottuvuuteen. Toisin sanoen ydinfunktio laskee pistetulon tuloksen toisesta ominaisuusavaruudesta.
Voit kirjoittaa polynomiytimen funktion sisään Python seuraavasti.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Se on kahden vektorin pistetulon teho. Alla palautat polynomiytimen toisen asteen. Tulos on sama kuin toisella menetelmällä. Tämä on ytimen taika.
polynomial_kernel(x1, x2, p=2)
8100
Ydinmenetelmien tyypit
Käytettävissä on monia erilaisia ydintekniikoita. Yksinkertaisin on lineaarinen ydin. Tämä funktio toimii melko hyvin tekstin luokitteluun. Muut ytimet ovat:
- Polynominen ydin
- Gaussin ydin
Alla oleva taulukko yhteenvetää, mitä kukin tekee ja milloin ammattilaiset tarttuvat siihen.
| Ydin | Mitä se laskee | Tyypillinen käyttö |
|---|---|---|
| Lineaarinen | Alkuperäisen piirreavaruuden yksinkertainen pistetulo | Jo erotettavissa oleva data ja korkeaulotteiset tekstiominaisuudet |
| polynomi | Pistetulo korotettuna asteeseen p, mikä kuvaa ominaisuuksien vuorovaikutuksia | Kaarevat rajat, kun vuorovaikutusten tiedetään olevan tärkeitä |
| Gaussin jakauma (RBF) | Etäisyyteen perustuva samankaltaisuus, joka lähestyy nollaa pisteiden liikkuessa erilleen | Tavallinen ensimmäinen valinta, kun reunan muoto on tuntematon |
TensorFlow-esimerkissä käytämme satunnaisia Fourier-piirteitä. TensorFlow'ssa on sisäänrakennettu estimaattori uuden ominaisuusavaruuden laskemiseksi. Satunnainen Fourier-piirteiden kartoittaja on approksimaatio alla olevasta Gaussin ydinfunktiosta.

Gaussin suodatusfunktio laskee datapisteiden samankaltaisuuden paljon korkeammassa ulottuvuudessa.
Teorian selvitettyä loppuosan tässä läpikäynnissä Gaussinen ydin hyödynnetään todellisessa tietojoukossa.
Harjoittele Gaussian Kernel -luokittaja TensorFlow'lla
Algoritmin tavoitteena on luokitella kotitalous, joka ansaitsee enemmän tai vähemmän kuin 50k.
Ensin arvioit logistista regressiota saadaksesi vertailumallin. Sen jälkeen koulutat ytimen luokittelijan nähdäksesi, voitko saada parempia tuloksia.
Käytät seuraavia muuttujia aikuisten tietojoukosta:
- ikä
- työluokka
- fnlwgt
- koulutus
- koulutus_nm
- avio-
- ammatti
- yhteys
- rotu
- sukupuoli
- myyntivoitto
- pääoma_tappio
- tuntia_viikko
- Kotimaa
- etiketti
Toimi seuraavasti ennen mallin kouluttamista ja arviointia:
- Tuo kirjastot
- Tuo tiedot
- Valmistele tiedot
- Logistisen mallin luominen: perusmalli
- Arvioi malli
- Ytimen luokittelijan rakentaminen ja arviointi
Versiohuomautus: Jokainen alla oleva koodinpätkä kohdistuu TensorFlow 1.x:ään. tf.contrib-nimiavaruus, joka tarjoaa real_valued_columnin, RandomFourierFeatureMapperin ja KernelLinearClassifierin, poistettiin TensorFlow 2.0:ssa, ja itse tf.estimator poistettiin TensorFlow 2.16:ssa. Nykyisessä versiossa sama putki rakennetaan tf.keras.layers.experimental.RandomFourierFeatures-kerroksella, jota seuraa Dense-tuloskerros, tai scikit-learnin RBFSampler- ja SGDClassifier-parilla.
Vaihe 1) Tuo kirjastot
Tuoda ja kouluttaa ydinmalleja Tekoäly, sinun on tuotava TensorFlow, pandas ja NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Vaihe 2) Tuo tiedot
Lataat tiedot osoitteesta UCI:n aikuisille suunnattu tietokantasivu ja tuo se pandas DataFrame -muodossa.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Nyt kun juna ja testijoukko on määritelty, voit muuttaa sarakkeen otsikon merkkijonosta kokonaisluvuksi. TensorFlow ei hyväksy merkkijonoarvoja otsikolle.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Vaihe 3) Valmistele tiedot
Aineisto sisältää sekä jatkuvia että kategorisia ominaisuuksia. Hyvä käytäntö on standardoida jatkuvien muuttujien arvot. Voit käyttää StandardScaler-funktiota kohdasta scikit opittavaLuot myös käyttäjän määrittämän funktion helpottaaksesi juna- ja testijoukon muuntamista. Huomaa, että yhdistät jatkuvat ja kategoriset muuttujat yhteiseksi tietojoukoksi ja taulukon tulee olla tyyppiä float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Transformer-funktio on valmis, joten voit muuntaa datajoukon ja luoda input_fn-funktion.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
Seuraavassa vaiheessa harjoittelet logistista regressiota. Se antaa sinulle perustason tarkkuuden. Tavoitteena on voittaa perusviiva eri algoritmilla, nimittäin ytimen luokittimella.
Vaihe 4) Rakenna logistinen malli: Perusmalli
Rakennat ominaisuussarakkeen objektilla real_valued_column. Se varmistaa, että kaikki muuttujat ovat tiheää numeerista dataa.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Estimaattori määritellään TensorFlow Estimator API:n avulla; annat ominaisuussarakkeet ja graafin tallennuspaikan.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Koulutat logistista regressiota käyttämällä 200 kappaleen kokoisia mini-eriä.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Voit kouluttaa mallia 1 000 iteraatiolla.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Vaihe 5) Arvioi malli
Määrittelet NumPy-syötefunktion mallin arvioimiseksi. Käytät koko testijoukkoa arviointiin.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Tarkkuutesi on 82 prosenttia. Seuraavassa osiossa yrität päihittää logistisen luokittelijan ydinluokittelijalla.
Vaihe 6) Luo ytimen luokitin
Ytimen estimaattori ei ole kovin erilainen kuin perinteinen lineaarinen luokittelija, ainakaan rakenteensa puolesta. Sen taustalla oleva ajatus on yhdistää eksplisiittisen ydinkuvauksen tehoping lineaarisen luokittelijan kanssa.
Tarvitset kaksi ennalta määritettyä estimaattoria, jotka ovat saatavilla TensorFlow'ssa ytimen luokittelijan kouluttamiseen:
- RandomFourier FeatureMapper
- KernelLinearClassifier
Ensimmäisessä osiossa opit, että sinun on muunnettava matala ulottuvuus korkeaksi ulottuvuudeksi käyttämällä ydinfunktiota. Tarkemmin sanottuna käytät satunnaisia Fourier-piirteitä, jotka approksimoivat Gaussin funktiota. TensorFlow 1.x tarjoaa kyseisen kuvauksen.ping kuten RandomFourierFeatureMapper, ja mallia voidaan kouluttaa estimaattorilla KernelLinearClassifier.
Rakentaaksesi mallin, toimi seuraavasti:
- Aseta korkean ulottuvuuden ydintoiminto
- Aseta L2-hyperparametri
- Rakenna malli
- Harjoittele mallia
- Arvioi malli
Vaihe A) Aseta korkean ulottuvuuden ydinfunktio
Nykyinen aineisto sisältää 14 ominaisuutta, jotka muunnat uudeksi 5 000-ulotteiseksi vektoriksi. Muunnos tehdään satunnaisten Fourier-ominaisuuksien avulla. Jos muistat Gaussin ytimen kaavan, huomaat, että on määriteltävä keskihajontaparametri. Tämä parametri ohjaa luokittelussa käytettyä samankaltaisuusmittaa: pieni keskihajonta saa ytimen käsittelemään vain hyvin lähellä olevia pisteitä samankaltaisina, kun taas suuri tasoittaa päätösrajaa.
Voit virittää kaikki RandomFourierFeatureMapperin parametrit seuraavilla tavoilla:
- input_dim = 14
- lähtö_himmennys = 5000
- keskihajonta = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Sinun on rakennettava ytimen kartoitus käyttämällä aiemmin luotuja ominaisuussarakkeita: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Vaihe B) Aseta L2-hyperparametri
Ylisovituksen estämiseksi rankaiset häviöfunktiota L2-regularisoijalla. Asetat L2-hyperparametrin arvoon 0.1 ja oppimisnopeuden arvoon 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Vaihe C) Mallin rakentaminen
Seuraava vaihe on samanlainen kuin lineaarisessa luokittelussa. Käytät sisäänrakennettua estimaattoria KernelLinearClassifieria. Huomaa, että lisäät aiemmin määritellyn ytimen mapperin ja muutat mallihakemistoa.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Alla olevat vanhentumisvaroitukset ovat odotettavissa TensorFlow 1.x:ssä, koska kernel_methods-moduuli on rakennettu vanhempien tf.contrib.learn-estimaattoreiden päälle.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Vaihe D) Mallin kouluttaminen
Nyt kun ydinluokittelija on rakennettu, olet valmis kouluttamaan sitä. Valitset mallin iterointikerran 2 000 kertaa.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Vaihe E) Mallin arviointi
Viimeisenä mutta ei vähäisimpänä, arvioit mallisi suorituskykyä. Sinun pitäisi pystyä voittamaan logistinen regressio.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Lopullinen tarkkuus on 84 %, noin 1.6 prosenttiyksikköä logistisen regression perustasoa (0.83975184 vs. 0.82353663) korkeampi. Tarkkuuden parantumisen ja laskentakustannusten välillä on kompromissi. Sinun on mietittävä, onko parannus raskaamman luokittelijan käyttämän ajan arvoinen ja onko sillä vakuuttava vaikutus liiketoimintaasi.
