
ELK Stack -opetusohjelma: Kibana, Logstash & Elasticsearch
 David Carter
⚡ Älykäs yhteenveto
ELK Stack yhdistää kolme avoimen lähdekoodin työkalua — Elasticsearchin, Logstashja Kibana – konetietojen keräämiseen, tallentamiseen, hakemiseen ja visualisointiin, mikä tarjoaa suunnittelutiimeille keskitetyn lokikirjauksen ja reaaliaikaisen analytiikan nopeampaa vianmääritystä varten palvelimilla ja sovelluksissa.
ELK Stack on yksi käytetyimmistä avoimen lähdekoodin ratkaisuista keskitettyyn lokikirjaukseen ja lokianalytiikkaan. Tämä ELK Stack -opas selittää, mitä Elasticsearch, Logstashja Kibana ovat se, miten nämä kolme työkalua sopivat yhteen ja missä alustaa käytetään tosielämän seurannassa ja havainnointityössä.
Mikä on ELK Stack?
ELK-pino on kokoelma kolmesta avoimen lähdekoodin tuotteesta - Elasticsearch, Logstashja Kibana. Se tarjoaa keskitetyn lokikirjauksen, joka auttaa tunnistamaan palvelimien tai sovellusten ongelmia antamalla sinun hakea kaikkia lokejasi yhdestä paikasta. Se auttaa myös korreloimaan lokeja useiden palvelimien välillä tietyn aikavälin sisällä.
- E tarkoittaa Elasticsearchia: käytetään lokien tallentamiseen.
- L tarkoittaa Logstash: käytetään laivaanping, lokien käsittely ja tallennus.
- K tarkoittaa Kibanaa: a visualisointityökalu (verkkokäyttöliittymä), jota isännöidään Nginxin tai Apachen kautta.
Elasticsearch, Logstashja Kibanaa kehittää, hallinnoi ja ylläpitää yritys nimeltä Joustava.
Yhdessä ELK Stack on suunniteltu siten, että käyttäjät voivat ottaa dataa mistä tahansa lähteestä, missä tahansa muodossa ja sitten hakea, analysoida ja visualisoida sitä reaaliajassa.
ELK-pino Archirakenne
Nyt kun tiedät, mikä pino on, tässä osiossa selitetään ELK-arkkitehtuuri ja miten data virtaa komponenttien välillä.
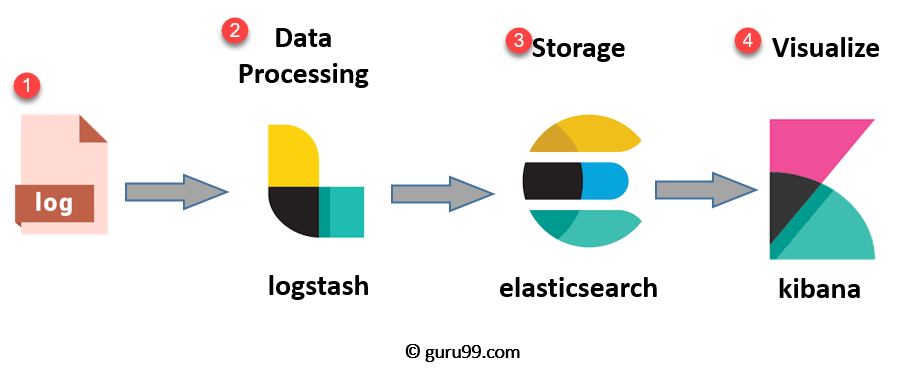
ELK-prosessi noudattaa selkeää järjestystä, jossa jokaisella työkalulla on oma tehtävänsä:
- lokit: Analysoitavat palvelinlokit tunnistetaan.
- Logstash: Kerää lokit ja tapahtumatiedot, jäsentää ja muuntaa ne sitten.
- Elastinen haku: Data, jonka on muuntanut Logstash tallennetaan, sitä haetaan ja indeksoidaan.
- Kibana: Käyttää Elasticsearch-tietokantaa oivallusten tutkimiseen, visualisointiin ja jakamiseen.
Usein lisätään kuitenkin neljäs komponentti nimeltä Beats tiedonkeruuta varten. Beats on palvelimille asennettu kevyt shipperi, ja niiden lisääminen johti siihen, että Elastic nimesi ELK:n uudelleen Elastic Stackiksi.
Kun käsittelet erittäin suuria tietomääriä, voit lisätä Kafkan tai RabbitMQ:n putken eteen puskuroinnin ja vikasietoisuuden takaamiseksi.
Lisäturvallisuuden takaamiseksi pinon eteen voidaan sijoittaa käänteinen välityspalvelin, kuten Nginx.

Seuraavissa osioissa tarkastellaan lähemmin kutakin pinon avoimen lähdekoodin tuotetta arkkitehtuuri mielessä pitäen.
Mikä on Elasticsearch?
Elasticsearch on a NoSQL-tietokanta Lucene-hakukoneeseen perustuva ja RESTful-rajapinnoilla rakennettu. Se tarjoaa yksinkertaisen käyttöönoton, korkean luotettavuuden ja helpon hallinnan, ja se tallentaa kaikki tietosi keskitetysti, jotta voit suorittaa edistyneitä kyselyitä ja nopeita asiakirjahakuja.
Elasticsearchin avulla voit myös tallentaa, hakea ja analysoida suuria tietomääriä. Sitä käytetään useimmiten pohjana olevana hakumoottorina, joka pyörittää vaativia hakuvaatimuksia omaavia sovelluksia.
Koska Elasticsearch lisää analytiikkaa ja monia edistyneitä ominaisuuksia nopean haun lisäksi, sitä on käytetty laajalti hakukoneissa nykyaikaisissa verkko- ja mobiilisovelluksissa.
Elasticsearchin ominaisuudet
Elasticsearch tarjoaa runsaasti ominaisuuksia datan indeksointiin ja hakemiseen:
- Avoimen lähdekoodin hakupalvelin, joka on kirjoitettu kielellä Java.
- Pystyy indeksoimaan minkä tahansa tyyppistä heterogeenistä dataa.
- Tarjoaa REST API -verkkokäyttöliittymän JSON-tulostuksella.
- Kokotekstihaku.
- Lähes reaaliaikainen (NRT) haku.
- Sirpaloitu, replikoitu ja haettavissa oleva JSON-dokumenttisäilö.
- Skeematon, REST- ja JSON-pohjainen hajautettu dokumenttivarasto.
- Monikielinen ja maantieteellisen sijainnin tuki.
Elasticsearchin edut
- Tallentaa skeematonta dataa ja voi myös luoda skeeman datallesi.
- Voit käsitellä tietueita yksi kerrallaan käyttämällä usean dokumentin API-rajapintoja.
- Tukee datan suodattamista ja kyselyä oivallusten saamiseksi.
- Perustuu Apache Lucene -pohjaiseen ja tarjoaa RESTful-rajapinnan.
- Tarjoaa horisontaalista skaalautuvuutta, luotettavuutta ja usean vuokralaisen tukiominaisuutta reaaliaikaista indeksointia ja nopeampaa hakua varten.
- Auttaa skaalaamaan sekä pystysuunnassa että vaakasuunnassa.
Alla oleva taulukko selittää keskeiset termit, joihin törmäät työskennellessäsi Elasticsearchin kanssa:
| Termi | Käyttö |
|---|---|
| Cluster | Klusteri on kokoelma solmuja, jotka yhdessä säilyttävät dataasi ja tarjoavat yhdistetyt indeksointi- ja hakuominaisuudet. |
| Solmu | Solmu on yksittäinen Elasticsearch-instanssi. Se luodaan, kun Elasticsearch-instanssi käynnistyy. |
| indeksi | Indeksi on kokoelma dokumentteja, joilla on samankaltaisia ominaisuuksia, kuten asiakastiedot tai tuoteluettelo. Se on hyödyllinen indeksointiin, hakuun, päivittämiseen ja poistamiseen, ja voit määrittää useita indeksejä yhteen klusteriin. |
| Asiakirja | Dokumentti on indeksoitavissa oleva tiedon perusyksikkö. Se ilmaistaan JSON-avain-arvo-parina, ja jokaisella dokumentilla on tyyppi ja yksilöllinen tunniste. |
| Sirpale | Jokainen indeksi voidaan jakaa useisiin sirpaleihin datan jakamiseksi. Sirpale on indeksin atomiosa, ja sitä voidaan levittää klusterin poikki lisäämällä solmuja. |
Mikä on Logstash?
Logstash on pinon tiedonkeruun työkalu. Se kerää datasyötteitä ja syöttää ne Elasticsearchiin, keräten kaikenlaisia tietoja eri lähteistä ja asettamalla ne saataville jatkokäyttöä varten.
Logstash voi yhdistää dataa eri lähteistä ja normalisoida sen valitsemiisi kohteisiin. Näin voit puhdistaa ja demokratisoida kaiken datasi monenlaisia analytiikka- ja visualisointikäyttötapauksia varten.
Se koostuu kolmesta osasta:
- input: välittää lokit sisään ja muuntaa ne koneellisesti luettavaan muotoon.
- Suodattimet: joukko ehtoja, jotka suorittavat tietyn toiminnon tapahtumassa.
- lähtö: päätöksentekijä, joka reitittää jokaisen käsitellyn tapahtuman tai lokin.
Ominaisuudet Logstash
Logstash sisältää useita ominaisuuksia, jotka tekevät lokien käsittelystä joustavaa:
- Tapahtumat kulkevat kunkin vaiheen läpi sisäisten jonojen avulla.
- Sallii lokien syöttämisen eri tavoilla.
- Tukee lokien suodattamista ja jäsentämistä.
Edut Logstash
- Keskittää tietojenkäsittelysi.
- Analysoi monenlaista strukturoitua ja strukturoimatonta dataa ja tapahtumia.
- Tarjoaa laajennuksia yhteyden muodostamiseen monenlaisiin syöttölähteisiin ja alustoihin.
Mikä on Kibana?
Kibana on ELK-pinon täydentävä datan visualisointityökalu. Sitä käytetään Elasticsearch-dokumenttien visualisointiin, ja se auttaa kehittäjiä saamaan nopeasti käsityksen datastaan interaktiivisten kaavioiden, paikkatiedon ja kuvaajien avulla, jotka tekevät monimutkaisista kyselyistä helposti ymmärrettäviä.
Voit käyttää Kibanaa Elasticsearch-indekseihin tallennetun datan hakemiseen, tarkastelemiseen ja vuorovaikutukseen sen kanssa. Se auttaa myös suorittamaan edistyneitä toimintoja tietojen analysointi ja esitä tietosi erilaisissa taulukoissa, kaavioissa ja kartoissa.
Kibana tukee useita menetelmiä datan hakemiseen. Yleisimmät hakutyypit on lueteltu alla:
| Hakutyyppi | Käyttö |
|---|---|
| Vapaa tekstihaku | Käytetään tietyn merkkijonon etsimiseen. |
| Kenttätason haut | Käytetään merkkijonon etsimiseen tietystä kentästä. |
| Loogisia väitteitä | Käytetään hakujen yhdistämiseen loogiseksi lausekkeeksi. |
| Läheisyyshakuja | Käytetään tietyn merkkietäisyyden sisällä olevien termien hakemiseen. |
Kibana tarjoaa myös useita tehokkaita ominaisuuksia indeksoidun datan tutkimiseen:
- Tehokas käyttöliittymä, joka visualisoi Elasticsearch-klusterin indeksoitua tietoa.
- Mahdollistaa indeksoitujen tietojen reaaliaikaisen haun.
- Voit hakea, tarkastella ja olla vuorovaikutuksessa Elasticsearchiin tallennettujen tietojen kanssa.
- Suorittaa kyselyitä datasta ja visualisoi tulokset kaavioissa, taulukoissa ja kartoissa.
- Muokattava kojelauta viipalointia ja lohkomista varten Logstash lokit Elasticsearchissa.
- Tarjoaa historiatietoja graafien, kaavioiden ja muiden muodossa.
- Tarjoaa reaaliaikaisia koontinäyttöjä, jotka on helppo konfiguroida.
Kibanan edut ja haitat
Kuten millä tahansa työkalulla, Kibanalla on selkeitä vahvuuksia, jotka selittävät sen suosion:
- Helppo datan visualisointi.
- Täysin integroitu Elasticsearchin kanssa.
- Toimii erillisenä visualisointityökaluna.
- Tarjoaa reaaliaikaisen analyysin, kaavioiden luonnin, yhteenvedon ja virheenkorjauksen.
- Tarjoaa intuitiivisen ja käyttäjäystävällisen käyttöliittymän.
- Sallii hakemiesi lokien tilannekuvien jakamisen.
- Sallii useiden kojelmien tallentamisen ja hallinnan.
Sillä on myös muutamia rajoituksia, jotka on pidettävä mielessä:
- Se toimii vain, kun tietolähteenä on Elasticsearch.
- Monimutkaisten raporttinäkymien rakentaminen ja virittäminen voi vaatia jyrkän oppimiskäyrän.
Miksi lokianalyysi?
Pilvipohjaisissa infrastruktuureissa suorituskyky ja eristäytyminen ovat erittäin tärkeitä.
Pilvipalvelussa olevien virtuaalikoneiden suorituskyky voi vaihdella kuormien, ympäristöjen ja aktiivisten käyttäjien määrän mukaan, joten luotettavuudesta ja solmujen vikaantumisesta voi tulla merkittäviä ongelmia.
A lokienhallinta-alusta voi valvoa kaikkia näitä ongelmia. Se voi myös käsitellä käyttöjärjestelmälokeja, Nginx- ja IIS-verkkopalvelinlokeja liikenneanalyysiä varten, sovelluslokeja ja AWS:ssä luotuja lokeja (Amazon Web Services).
Viime kädessä lokinhallinta auttaa DevOps insinöörit ja järjestelmänvalvojat tekevät parempia, datalähtöisiä päätöksiä. Siksi lokitietojen analysoinnista Elastic Stackin tai vastaavien työkalujen avulla on tullut olennainen osa tätä.
ELK vs. Splunk
Yleinen kysymys on, miten ELK-pino vertautuu muihin Splunk, suosittu kaupallinen vaihtoehto. Alla oleva taulukko esittää yhteenvedon tärkeimmistä eroista:
| HIRVI | Splunk |
|---|---|
| ELK on avoimen lähdekoodin työkalu. | Splunk on kaupallinen työkalu. |
| ELK ei tarjoa Solaris siirrettävyys Kibanan ansiosta. | Splunk tarjoukset Solaris siirrettävyys. |
| Käsittelynopeus on tiukasti rajoitettu. | Tarjoaa tarkan ja nopean käsittelyn. |
| ELK on teknologiapino, joka on luotu yhdistämällä Elasticsearch, Logstashja Kibana. | Splunk on patentoitu työkalu, joka tarjoaa sekä paikallisia että pilviratkaisuja. |
| ELK:ssa haku, analysointi ja visualisointi ovat mahdollisia vasta pinon määrittämisen jälkeen. | Splunk on täydellinen tiedonhallintapaketti suoraan paketista. |
| ELK tarjoaa rajoitetun sisäänrakennetun integraation muiden työkalujen kanssa. | Splunk on hyödyllinen integraatioiden määrittämiseen muiden työkalujen kanssa. |
Asiakastapaukset
Monet tunnetut yritykset luottavat ELK Stackiin lokitietojen ja analytiikan suorittamiseen laajamittaisesti. Alla olevat esimerkit havainnollistavat, miten sitä käytetään tuotannossa.
Netflix
Netflix luottaa vahvasti ELK Stackiin asiakaspalvelutoimintojensa tietoturvalokien valvonnassa ja analysoinnissa. Alusta mahdollistaa Netflix indeksoida, tallentaa ja hakea asiakirjoja yli viidessätoista klusterissa, jotka koostuvat noin 800 solmusta.
Ammattimainen verkostoitumissivusto LinkedIn käyttää ELK Stackia suorituskyvyn ja tietoturvan valvontaan. Sen tiimi integroi ELK:n Kafkaan reaaliaikaisen kuormituksen hallintaan, ja toiminta kattaa yli 100 klusteria kuudessa datakeskuksessa.
Ansalanka
Tripwire, maailmanlaajuinen tietoturva- ja tapahtumienhallinnan (SIEM) tarjoaja, käyttää ELK-pinoa tietopakettilokien analysoinnin tukemiseen.
Keskikova
Suosittu blogien julkaisualusta Medium käyttää ELK Stackia tuotanto-ongelmien vianmääritykseen ja havaitsemiseen DynamoDB kuumimmat kohdat. Pino auttaa yritystä tukemaan 25 miljoonaa yksittäistä lukijaa ja tuhansia uusia julkaisuja joka viikko.
ELK-pinon edut ja haitat
edut
ELK-pino tarjoaa useita etuja, jotka selittävät sen laajan käyttöönoton:
- Se toimii parhaiten, kun yrityksen eri sovellusten lokit yhdistyvät yhdeksi ELK-instanssiksi.
- Se tarjoaa rikkaita tietoja yhdestä yksittäisestä instanssista ja poistaa tarpeen kirjautua satoihin erillisiin tietolähteisiin.
- Nopea asennus paikan päällä.
- Helppo ottaa käyttöön ja skaalautuu sekä pysty- että vaakasuunnassa.
- Elastic tarjoaa monia kieliohjelmia, mukaan lukien Rubyn, Python, PHP, Perl, .NET, Javaja JavaSkripti.
- Kirjastoja on saatavilla monille ohjelmointi- ja skriptikielille.
Haitat
Vahvuuksistaan huolimatta ELK-pinolla on muutamia haittoja, jotka on otettava huomioon:
- Eri komponenttien hallinta voi vaikeutua siirryttäessä monimutkaisempaan kokoonpanoon.
- Oppimiskäyrä on todellinen, joten odota jonkin verran kokeilua ja erehdystä kokemuksen karttuessa.
