
DataStage-opetusohjelma aloittelijoille: IBM ETL työkalu
 David Carter
⚡ Älykäs yhteenveto
DataStage-sovellus IBM InfoSphere extracts, muuntaa ja lataa yritystietoja skaalautuvasti. Tällä sivulla selitetään arkkitehtuuri, komponentit, rinnakkaiskäsittely, SQL-replikoinnin asetukset, projektin luonti, työn kääntäminen ja integraatiotestaus käytännön DB2-jälleenmyyntiesimerkin avulla.
Mikä on DataStage?
DataStage on ETL-työkalu, jota käytetääntracmuunna ja lataa tietoja lähteestä kohdekohteeseen. Näiden tietojen lähde voi sisältää peräkkäisiä tiedostoja, indeksoituja tiedostoja, relaatiotietokantoja, ulkoisia tietolähteitä, arkistoja, yrityssovelluksia jne. DataStagea käytetään liiketoiminnan analysoinnin helpottamiseen tarjoamalla laadukasta dataa, joka auttaa liiketoimintatiedon hankkimisessa.
DataStage ETL -työkalua käytetään suuressa organisaatiossa rajapintana eri järjestelmien välillä. Se huolehtii esim.tractiedon siirtäminen, kääntäminen ja lataaminen lähteestä kohdekohteeseen. VMark julkaisi sen ensimmäisen kerran 90-luvun puolivälissä. IBM ostettuaan DataStagen vuonna 2005, se nimettiin uudelleen IBM WebSphere DataStage ja myöhemmin IBM InfoSphere.
Useita markkinoilla saatavilla olevia Datastage-versioita olivat Enterprise Edition (PX), Server Edition, MVS Edition, DataStage for PeopleSoft ja niin edelleen. Uusin painos on IBM InfoSphere DataStage.
IBM Tietopalvelin sisältää seuraavat tuotteet,
- IBM InfoSphere DataStage
- IBM InfoSphere QualityStage
- IBM InfoSpheren tietopalvelujohtaja
- IBM InfoSphere Information Analyzer
- IBM Tietopalvelin nopeastiTrack
- IBM InfoSphere Business Glossary
Kun määritelmä on vakiintunut, seuraavassa osiossa tarkastellaan, mitä tuote todellisuudessa voi tehdä sisällään tietovarastointi ympäristöön.
DataStage Yleiskatsaus
Datastagella on seuraavat ominaisuudet.
- Se voi integroida tietoja laajasta valikoimasta yritys- ja ulkoisia tietolähteitä
- Toteuttaa tietojen validointisäännöt
- Se on hyödyllinen suurten tietomäärien käsittelyssä ja muuntamisessa
- Se käyttää skaalautuvaa rinnakkaiskäsittelyä
- Se pystyy käsittelemään monimutkaisia muunnoksia ja hallita useita integraatioprosesseja
- Hyödynnä suoria yhteyksiä yrityssovelluksiin lähteinä tai kohteina
- Hyödynnä metadataa analysointia ja ylläpitoa varten
- Operates erässä, reaaliajassa tai verkkopalveluna
Tämän DataStage-opetusohjelman seuraavissa osissa kuvataan lyhyesti seuraavat seikat IBM InfoSphere DataStage:
- Tietojen muuntaminen
- Työpaikat
- Rinnakkaiskäsittely
InfoSphere DataStage ja QualityStage voivat käyttää tietoja yrityssovelluksissa ja tietolähteissä, kuten:
- Relaatiotietokannat
- Mainframe-tietokannat
- Liiketoiminta- ja analyyttiset sovellukset
- Yrityksen resurssien suunnittelu (ERP) tai asiakassuhteiden hallinnan (CRM) tietokannat
- Online-analyyttinen käsittely (OLAP) tai suorituskyvyn hallinnan tietokannat
Käsittelyvaiheen tyypit
IBM infosphere-työ koostuu yksittäisistä vaiheista, jotka on linkitetty toisiinsa. Se kuvaa tiedonkulkua tietolähteestä tietokohteeseen. Yleensä vaiheessa on vähintään yksi datatulo ja/tai yksi datalähtö. Jotkut vaiheet voivat kuitenkin hyväksyä useamman kuin yhden datasyötön ja ulostulon useampaan kuin yhteen vaiheeseen.
Työn suunnittelussa voit käyttää erilaisia vaiheita:
- Muutosvaihe
- Suodatusvaihe
- Aggregaattorivaihe
- Poista kaksoiskappaleet
- Liity lavalle
- Hakuvaihe
- Kopioi vaihe
- Lajittele vaihe
- Kontit
Miksi DataStagea kannattaa käyttää datan integrointiin?
Ominaisuusluettelon tunteminen on yksi asia ja toinen asia tietää, milloin työkalu ansaitsee lisenssimaksunsa. DataStage valitaan työkuormille, joissa volyymi, hallinta ja heterogeeniset lähteet tekevät käsinkirjoitetuista skripteistä hallitsemattomia.
Selkein syy on suoritusteho. Koska moottori osittaa datan solmujen välillä ja suoratoistaa tietueita vaiheiden välillä samanaikaisesti, laitteiston lisääminen lisää suoritustehoa lähes lineaarisesti. Kahden solmun kehityslaatikolla suunniteltu työ suoritetaan muuttumattomana kahdeksan solmun tuotantoklusterissa.
Muut syyt ovat pikemminkin organisatorisia kuin teknisiä:
- Jaetut metatiedot: Taulukkomääritelmät, yhteydet ja liiketoimintatermit tallennetaan kerran repositorioon ja niitä käytetään uudelleen jokaisessa työssä, mikä poistaa ajautumisen, joka syntyy, kun jokainen kehittäjä määrittelee lähteen itsenäisesti.
- Sisäänrakennettu datan laatu: QualityStage suorittaa tutkimuksen, standardoinnin, yhteensovittamisen ja selviytymisen ETL-työnkulun rinnalla, joten puhdistus ei vaadi toista tuotetta.
- Laaja liitettävyys: Natiivit liittimet saavuttavat DB2:n, Oracle, Teradata, keskustietokoneen VSAM, SAP, Salesforce ja pilviobjektien tallennustila ilman mukautettua koodia.
- Operakansallinen hallinta: Director näyttää suoritushistorian, rivimäärät, varoitukset ja uudelleenkäynnistyspisteet, jotka auditoijat hyväksyvät todisteeksi hallitusta dataputkesta.
- Uudelleenkäytettävyys: Jaetut säilöt ja parametrijoukot mahdollistavat yhden testatun transformaation suorittamisen useissa tehtävissä sen sijaan, että se kopioitaisiin jokaiseen niistä.
Nämä hyödyt riippuvat suoraan tuotteen kokoamisesta, mikä selitetään seuraavassa osiossa.
DataStage Components ja Archirakenne
DataStagessa on neljä pääkomponenttia, nimittäin
- Järjestelmänvalvoja: Sitä käytetään hallintotehtäviin. Tähän sisältyy DataStage-käyttäjien määrittäminen, tyhjennyskriteerien määrittäminen sekä projektien luominen ja siirtäminen.
- Manager: Se on ETL DataStage -tietovaraston päärajapinta. Sitä käytetään uudelleenkäytettävien metatietojen tallentamiseen ja hallintaan. DataStage managerin kautta voi tarkastella ja muokata arkiston sisältöä.
- Suunnittelija: Suunnitteluliittymä, jota käytetään DataStage-sovellusten TAI töiden luomiseen. Se määrittää tietolähteen, vaaditun muunnoksen ja tietojen määränpään. Työt kootaan suoritettavan tiedoston luomiseksi, jotka johtaja ajoittaa ja joita palvelin suorittaa
- Ohjaaja: Sitä käytetään DataStage-palvelintöiden ja rinnakkaisten töiden validointiin, ajoittamiseen, suorittamiseen ja valvontaan.

Yllä oleva kuva selittää kuinka IBM Infosphere DataStage on vuorovaikutuksessa muiden osien kanssa IBM Tietopalvelinalusta. DataStage on jaettu kahteen osaan, Jaetut komponentit ja suoritusaika ArchirakenneAlla oleva taulukko selittää tarkemmin, mitä kukin näistä kahdesta osiosta sisältää.
|
Yhteinen |
Yhtenäinen käyttöliittymä |
|
|
Yhteiset palvelut |
|
|
|
Yhteinen rinnakkaiskäsittely |
|
|
|
Runtime Archirakenne |
OSH Script |
|
Miten rinnakkaiskäsittely toimii DataStagessa
Yllä oleva arkkitehtuuritaulukko nimeää yhteisen rinnakkaiskäsittelyn jaetuksi palveluksi. Tässä osiossa selitetään, miten kyseinen palvelu itse asiassa suorittaa työn, koska konsepti luvattiin yleiskatsauksessa ja se määrittää, kuinka nopeasti työ valmistuu.
Rinnakkaistyö käyttää kahta mekanismia samanaikaisesti, ja molemmat otetaan käyttöön automaattisesti suorituksen aikana sen sijaan, että ne koodattaisiin käsin.
1. Putkilinjan rinnakkaisuus. Jokainen työn vaihe alkaa kerralla sen sijaan, että odotettaisiin edellisen vaiheen päättymistä. Lähdevaihe alkaa lukea rivejä ja siirtää ne muistissa olevaan liukuhihnaan. Transformer käynnistyy heti ensimmäisten rivien saapuessa ja siirtää tulosteensa toiseen liukuhihnaan. Kohdeliitin aloittaa kirjoittamisen heti sen jälkeen. Välitiedostoa ei kirjoiteta, joten kolmivaiheinen työ suorittaa lukemisen, muuntamisen ja kirjoittamisen päällekkäin sen sijaan, että ne suoritettaisiin peräkkäin.
2. Osioinnin rinnakkaisuus. Rivit jaetaan erillisiin osioihin, ja vaihelogiikan täysi kopio suoritetaan jokaista osiota vastaan omalla solmullaan. Kahdeksan osiota tarkoittaa kahdeksaa samanaikaista Transformer-instanssia. Virran lopussa osiot kerätään takaisin yhdeksi kohteen virraksi.
Oikean osiointimenetelmän valinta on kehittäjän tärkein virityspäätös:
- Auto: Oletusarvo. Moottori valitsee metodin vaiheen tarpeiden perusteella.
- hash: Lähettää saman avainarvon sisältävät rivit samaan solmuun. Vaaditaan ennen Join-, Aggregator- ja Remove Duplicates -komentoja, jotta identtiset avaimet täsmäävät.
- Round Robin: Käsittelee rivejä tasaisesti yksi kerrallaan. Paras vaihtoehto ladattaessa tasaista tiedostoa, jossa avainryhmät ovatping ei ole väliä.
- Koko: Kopioi koko tietojoukon jokaiseen solmuun. Käytetään pienille viitetaulukoille hakuvaiheessa.
- Sama: Säilyttää olemassa olevan osioinnin koskemattomana, mikä välttää tarpeettoman uudelleenosioinnin kahden vaiheen välillä.
- Alue ja moduuli: Jaa rivit arvoalueen mukaan tai numeerisen avaimen jäännöksen mukaan, kun tarvitaan tasainen jakautuminen.
Konfiguraatiotiedosto (APT_CONFIG_FILE) määrittää, kuinka monta solmua on olemassa. Koska solmujen määrä sijaitsee työn ulkopuolella, sama käännetty työ skaalautuu kannettavasta tietokoneesta tuotantoverkkoon ilman suunnittelumuutoksia.
Ennen kuin mitään tästä voidaan kokeilla, ympäristön on oltava kunnossa.
Datastage Toolin ennakkoedellytys
DataStagea varten tarvitset seuraavan asennuksen.
- InfoSphere
- DataStage Server 9.1.2 tai uudempi
- Microsoft Visual Studio .NET 2010 Express Edition C++
- Oracle asiakas (täysasiakas, ei välitön asiakas), jos muodostat yhteyden Oracle tietokanta
- DB2-työasema, jos muodostat yhteyden DB2-tietokantaan
Nyt tässä DataStage-opetusohjelmassa aloittelijoille opimme lataamaan ja asentamaan InfoSphere-tietopalvelimen.
Lataa ja asenna InfoSphere Information Server
Voit käyttää DataStagea lataamalla ja asentamalla uusimman version IBM InfoSphere-palvelin. Palvelin tukee AIX-, Linux- ja Windows käyttöjärjestelmä. Voit valita tarpeen mukaan.
Tietojen siirtämiseen vanhemmasta infospheren versiosta uuteen versioon käytetään resurssien vaihtotyökalua.
Asennustiedostot
Infosphere Datastagen asentaminen ja määrittäminen edellyttää, että asennuksessasi on seuraavat tiedostot.
varten Windows,
- EtlDeploymentPackage-windows-oracle.pkg
- EtlDeploymentPackage-windows-db2.pkg
Linuxille,
- EtlDeploymentPackage-linux-db2.pkg
- EtlDeploymentPackage-linux-oracle.pkg
Kun palvelin on asennettu, tämän sivun loppuosassa oleva esimerkki käyttää muutosdatan sieppausta, joten on hyödyllistä nähdä, miten muutosdata liikkuu ennen sen rakentamista.
Muutostietojen prosessivirta CDC Transaction Stage -työssä

Yllä oleva kaavio tractekee yhden muutoksen lähdetietokannasta kohdetietokantaan alla luetellussa järjestyksessä.
- Tietokannan 'InfoSphere CDC' -palvelu tarkkailee ja kaappaa muutosta lähdetietokannasta
- Replikointimäärityksen mukaan "InfoSphere CDC" siirtää muutostiedot "InfoSphere CDC for InfoSphere DataStagelle".
- "InfoSphere CDC for InfoSphere DataStage" -palvelin lähettää tiedot "CDC Transaction -vaiheeseen" TCP/IP-istunnon kautta. "InfoSphere CDC for InfoSphere DataStage" -palvelin lähettää myös COMMIT-sanoman (kirjanmerkkitietojen kanssa) merkitäkseen tapahtumarajan kaapatussa lokissa.
- Jokaiselle "InfoSphere CDC for InfoSphere DataStage" -palvelimen lähettämälle COMMIT-sanomille "CDC Transaction stage" luo end-of-wave (EOW) -merkit. Nämä merkit lähetetään kaikissa lähtölinkeissä kohdetietokannan liitinvaiheeseen.
- Kun "kohdetietokantaliitinvaihe" vastaanottaa aallon loppumerkin kaikille tulolinkeille, se kirjoittaa kirjanmerkkitiedot kirjanmerkkitaulukkoon ja sitoo sitten tapahtuman kohdetietokantaan.
- "InfoSphere CDC for InfoSphere DataStage" -palvelin pyytää kirjanmerkkitietoja "kohdetietokannan" kirjanmerkkitaulukosta.
- "InfoSphere CDC for InfoSphere DataStage" -palvelin vastaanottaa kirjanmerkkitiedot.
Tätä tietoa käytetään mm.
- Määritä tapahtumalokissa aloituspiste, jossa muutokset luetaan, kun replikointi alkaa.
- Selvittääksesi, voidaanko olemassa oleva tapahtumaloki puhdistaa
SQL-replikoinnin määrittäminen
Ennen kuin aloitat Datastagen käytön, sinun on määritettävä tietokanta. Luot kaksi DB2-tietokantaa.
- Yksi toimimaan replikointilähteenä ja
- Yksi kohteena.
Luot myös kaksi taulukkoa (Tuote ja Varasto) ja täytät ne esimerkkitiedoilla. Sitten voit testata integraatiosi välillä SQL Replikointi ja tietovaihe.
Jatkossa määrität SQL-replikoinnin luomalla ohjaustaulukot, tilausjoukot, rekisteröinnit ja tilausjoukon jäsenet. Opimme tästä tarkemmin seuraavassa osiossa.
Tässä otamme esimerkin Vähittäismyyntituote tietokantaamme ja luomme kaksi taulukkoa Varasto ja Tuote. Nämä taulukot lataavat tietoja lähteestä kohteeseen näiden joukkojen kautta. (ohjaustaulukot, tilausjoukot, rekisteröinnit ja tilausjoukon jäsenet.)
Vaihe 1) Luo lähdetietokanta, jota kutsutaan nimellä MYYNTI. Luo tämän tietokannan alle kaksi taulukkoa tuote ja Inventaario.
Vaihe 2) Luo SALES-tietokanta suorittamalla seuraava komento.
db2 create database SALES
Vaihe 3) Ota SALES-tietokannan arkistointiloki käyttöön. Varmuuskopioi myös tietokanta käyttämällä seuraavia komentoja
db2 update db cfg for SALES using LOGARCHMETH3 LOGRETAIN
db2 backup db SALES
Vaihe 4) Siirry samassa komentokehotteessa setupDB-alihakemistoon sqlrepl-datastage-tutorial-hakemistossa, jonka olet aiemmin käyttänyt.tracladatusta pakatusta tiedostosta.

Vaihe 5) Käytä seuraavaa komentoa Inventory-taulukon luomiseen ja tietojen tuomiseen taulukkoon suorittamalla seuraava komento.
db2 import from inventory.ixf of ixf create into inventory
Vaihe 6) Luo kohdetaulukko. Nimeä kohdetietokanta nimellä STAGEDB.
Koska olet nyt luonut sekä tietokannan lähde- että kohdetietokannan, seuraava vaihe tässä DataStage-opetusohjelmassa, näemme kuinka se kopioidaan.
Seuraavista tiedoista voi olla apua ODBC-tietolähteen määrittäminen vuonna IBM InfoSphere Information Serverin dokumentaatio.
SQL-replikointiobjektien luominen
Alla oleva kuva näyttää, miten muutosdatan virtaus toimitetaan lähdetietokannasta kohdetietokantaan. Luot lähde-kohdekartan.ping ns. pöytien välissä tilausjoukon jäseniä ja ryhmittele jäsenet a tilaus.

InfoSphere CDC:n (Change Data Capture) replikointiyksikköä kutsutaan tilaukseksi.
- Lähteeseen tehdyt muutokset tallennetaan "Capture control table" -taulukkoon, joka lähetetään CD-taulukkoon ja sitten kohdetaulukkoon. Hakemusohjelmassa on tiedot rivistä, josta muutokset on tehtävä. Se liittyy myös tilaussarjan CD-pöytään.
- Tilaus sisältää kartanping tiedot, jotka määrittävät, miten lähdetietovaraston tietoja sovelletaan kohdetietovarastoon. Huomaa, että CDC:tä kutsutaan nyt nimellä Infosphere-tietojen replikointi.
- Kun tilaus suoritetaan, InfoSphere CDC kaappaa muutokset lähdetietokannassa. InfoSphere CDC toimittaa muutostiedot kohteeseen ja tallentaa synkronointipisteen tiedot kohdetietokannan kirjanmerkkitaulukkoon.
- InfoSphere CDC käyttää kirjanmerkkitietoja InfoSphere DataStage -työn edistymisen seuraamiseen.
- Vian sattuessa kirjanmerkkitietoja käytetään uudelleenaloituspisteenä. Esimerkissämme ASN.IBMSNAP_FEEDETL-taulukko tallentaa DataStageen liittyviä synkronointipistetietoja, joita käytetään track DataStage-edistyminen.
Tässä osiossa IBM DataStage-opetusohjelma, sinun on tehtävä seuraavat asiat,
- Luo CAPTURE CONTROL -taulukoita ja APPLY CONTROL -taulukoita replikointiasetusten tallentamiseksi
- Rekisteröi TUOTE- ja INVENTORY-taulukot toisinnuslähteiksi
- Luo kahden jäsenen tilausjoukko
- Luo tilausjoukon jäseniä ja kohdista CCD-taulukoita
Käytä ASNCLP-komentoriviohjelmaa SQL-replikoinnin määrittämiseen
Vaihe 1) Etsi crtCtlTablesCaptureServer.asnclp-komentosarjatiedosto sqlrepl-datastage-tutorial/setupSQLRep-hakemistosta.
Vaihe 2) Korvaa tiedostossa ja " ” käyttäjätunnuksellasi ja salasanallasi liittyäksesi SALES-tietokantaan.
Vaihe 3) Muuta hakemistot sqlrepl-datastage-tutorial/setupSQLRep-hakemistoon ja suorita komentosarja. Käytä seuraavaa komentoa. Komento muodostaa yhteyden SALES-tietokantaan ja luo SQL-komentosarjan seurantaohjelman ohjaustaulukoiden luomista varten.
asnclp –f crtCtlTablesCaptureServer.asnclp
Vaihe 4) Etsi crtCtlTablesApplyCtlServer.asnclp-komentosarjatiedosto samasta hakemistosta. Korvaa nyt kaksi esiintymää ja " ” käyttäjätunnuksella ja salasanalla STAGEDB-tietokantaan yhdistämistä varten.
Vaihe 5) Käytä nyt samassa komentokehotteessa seuraavaa komentoa sovellusohjaustaulukoiden luomiseen.
asnclp –f crtCtlTablesApplyCtlServer.asnclp
Vaihe 6) Etsi crtRegistration.asnclp-komentosarjatiedostot ja korvaa kaikki esiintymät käyttäjätunnuksella SALES-tietokantaan liittymistä varten. Muuta myös " ” yhteyden salasanaan.
Vaihe 7) Rekisteröi lähdetaulukot käyttämällä seuraavaa komentosarjaa. Osana rekisteröinnin luomista ASNCLP-ohjelma luo kaksi CD-taulukkoa. CD-TUOTTEET JA CDINVENTORY.
asnclp –f crtRegistration.asnclp
CREATE REGISTRATION -komento käyttää seuraavia vaihtoehtoja:
- Differentiaalin päivitys: Se kehottaa Apply-ohjelmaa päivittämään kohdetaulukon vain, kun lähdetaulukon rivit muuttuvat
- Kuvaa molemmat: Tätä vaihtoehtoa käytetään rekisteröimään arvo lähdesarakkeeseen ennen muutoksen tapahtumista ja yksi arvolle muutoksen tapahtumisen jälkeen.
Vaihe 8) Muodosta yhteys kohdetietokantaan (STAGEDB) noudattamalla seuraavia ohjeita.
- Etsi crtTableSpaceApply.bat-tiedosto ja avaa se tekstieditorissa
- Korvata ja käyttäjätunnuksella ja salasanalla
- Kirjoita DB2-komentoikkunaan crtTableSpaceApply.bat ja suorita tiedosto.
- Tämä erätiedosto luo uuden taulukkotilan kohdetietokantaan ( STAGEDB)
Vaihe 9) Etsi crtSubscriptionSetAndAddMembers.asnclp-komentosarjatiedostot ja tee seuraavat muutokset.
- Korvaa kaikki esiintymät ja käyttäjätunnuksella ja salasanalla SALES-tietokantaan (lähde) liittymistä varten.
- Korvaa kaikki esiintymät ja käyttäjätunnuksella STAGEDB-tietokantaan (kohde) yhdistämistä varten.
Muutosten jälkeen suorita komentosarja luodaksesi tilausjoukon (ST00), joka ryhmittelee lähde- ja kohdetaulukot. Komentosarja luo myös kaksi tilausjoukon jäsentä ja CCD:n (yhdenmukaiset muutostiedot) kohdetietokantaan, joka tallentaa muokatut tiedot. Infosphere DataStage käyttää nämä tiedot.
Vaihe 10) Luo tilausjoukko, tilausjoukon jäsenet ja CCD-taulukot suorittamalla komentosarja.
asnclp –f crtSubscriptionSetAndAddMembers.asnclp
Tilausjoukon ja kahden jäsenen luomiseen käytetään erilaisia vaihtoehtoja
- Täydellinen tiivistettynä pois
- Ulkoinen
- Kuorman tyyppi tuonti vienti
- Ajoitus jatkuvaa
Vaihe 11) Replikoinnin hallintatyökalujen viasta johtuen. Sinun on suoritettava toinen erätiedosto asettaaksesi sarakkeen TARGET_CAPTURE_SCHEMA IBMSNAP_SUBS_SET ohjaustaulukon nollaksi.
- Etsi tiedosto updateTgtCapSchema.bat. Avaa se tekstieditorissa. Korvata ja käyttäjätunnuksella STAGEDB-tietokantaan yhdistämistä varten.
- Kirjoita DB2-komentoikkunaan komento updateTgtCapSchema.bat ja suorita tiedosto.
Määritystiedostojen luominen CCD-taulukoiden yhdistämiseksi DataStageen
Ennen kuin teemme replikoinnin seuraavassa vaiheessa, meidän on yhdistettävä CCD-taulukko DataStageen. Tässä osiossa näemme kuinka yhdistää SQL DataStageen.
Yhdistääksesi CCD-taulukon DataStageen sinun on luotava Datastage-määritystiedostoja (.dsx). DataStage käyttää .dsx-tiedostomuotoa työmääritelmien tuontiin ja vientiin. Käytät ASNCLP-skriptiä luodaksesi kaksi .dsx-tiedostoa. Esimerkiksi tässä olemme luoneet kaksi .dsx-tiedostoa.
- stagedb_AQ00_SET00_sJobs.dsx: Luo työjärjestyksen, joka ohjaa neljän rinnakkaisen työn työnkulkua.
- stagedb_AQ00_SET00_pJobs.dsx : Luo neljä rinnakkaista työtä
ASNCLP-ohjelma yhdistää CCD-sarakkeen automaattisesti Datastage Column -muotoon. Sitä tuetaan vain, kun ASNCLP on käynnissä Windows, Linux- tai Unix-menettely.

Datavaiheen työt hakevat rivejä CCD-taulukosta.
- Yksi työ asettaa synkronointipisteen siihen kohtaan, missä DataStage jäi edellisessä työssä.tractietoja kahdesta taulukosta. Työ hakee nämä tiedot valitsemalla ST00-tilausjoukolle SYNCHPOINT-arvon IBMSNAP_SUBS_SET-taulukko ja lisäämällä sen MAX_SYNCHPOINT-sarakkeeseen IBMSNAP_FEEDETL-taulukko.
- Kaksi työpaikkaa, jotka olivat aiemmintracPRODUCT_CCD- ja INVENTORY_CCD-taulukoiden tiedot. Työt tietävät, mitkä rivit aloitetaan, esim.tracvalitsemalla MIN_SYNCHPOINT- ja MAX_SYNCHPOINT-arvot valikosta IBMSNAP_FEEDETL-taulukko tilausjoukolle.
Kun määritelmät on yhdistetty, replikointi voidaan aloittaa, jotta yhtenäisten muutostietojen taulukot alkavat täyttyä.
Aloitetaan replikointi
Aloita replikointi noudattamalla alla olevia ohjeita. Kun CCD-taulukot täytetään tiedoilla, se osoittaa, että toisinnusasetukset on vahvistettu. Voit tarkastella kopioituja tietoja kohde-CCD-taulukoissa DB2 Control Center -ohjelmiston graafisen käyttöliittymän avulla.
Vaihe 1) Varmista, että DB2 on käynnissä, jos se ei ole käynnissä, käytä sitä db2 käynnistys komento.
Vaihe 2) Käytä sitten käyttöjärjestelmän kehotteessa olevaa asncap-komentoa aloittaaksesi ohjelman sieppauksen. Esimerkiksi.
asncap capture_server=SALES
Yllä oleva komento määrittää SALES-tietokannan muutosten seurantapalvelimeksi. Pidä komentoikkuna auki, kun sieppaus on käynnissä.
Vaihe 3) Avaa nyt uusi komentokehote. Aloita sitten KOSKE ohjelma asnapply-komennolla.
asnapply control_server=STAGEDB apply_qual=AQ00

- Komento määrittää STAGEDB-tietokannan päivitysohjelman ohjauspalvelimeksi (tietokanta, joka sisältää päivitysohjelman ohjaustaulukot).
- AQ00 Apply-tarkenteena (tämän ohjaustaulukkojoukon tunniste)
Jätä komentoikkuna auki, kun Apply on käynnissä.
Vaihe 4) Avaa nyt toinen komentokehote ja käynnistä DB2 Control Center -ohjelma antamalla db2cc-komento. Hyväksy oletusarvoinen ohjauskeskus.
Vaihe 5) Avaa nyt vasemmasta navigointipuusta Kaikki tietokannat > STAGEDB ja napsauta sitten Taulukot. Double Napsauta taulukon nimeä (Tuote CCD) avataksesi taulukon. Se näyttää tältä.

Samoin voit myös avata CCD-taulukon INVENTORY:lle.

Replikointi syöttää nyt tietoja yhtenäisten muutostietojen (CCD) taulukoihin, joten huomio siirtyy tietokannan puolelta DataStage-asiakasohjelmiin.
Projektien luominen Datastage Toolissa
Ensinnäkin luot projektin DataStagessa. Tätä varten sinun on oltava InfoSphere DataStage -järjestelmänvalvoja.
Kun asennus ja replikointi on tehty, sinun on luotava projekti. DataStagessa projektit ovat menetelmä tietojen järjestämiseen. Se sisältää datatiedostojen, vaiheiden ja rakennustöiden määrittelyn tietyssä projektissa.
Voit luoda projektin DataStagessa seuraavasti:
Vaihe 1) Käynnistä DataStage-ohjelmisto
Käynnistä DataStage ja QualityStage Administrator. Napsauta sitten Käynnistä > Kaikki ohjelmat > IBM Tietopalvelin > IBM WebSphere DataStage ja QualityStage Administrator.
Vaihe 2) Yhdistä DataStage-palvelin ja asiakas
Kun haluat muodostaa yhteyden DataStage-palvelimeen DataStage-asiakkaastasi, anna tiedot, kuten verkkotunnuksen nimi, käyttäjätunnus, salasana ja palvelintiedot.
Vaihe 3) Lisää uusi projekti
WebSphere DataStage Administration -ikkunassa. Napsauta Projektit-välilehteä ja napsauta sitten Lisää.
Vaihe 4) Anna projektin tiedot
Kirjoita WebSphere DataStage Administration -ikkunaan tiedot, kuten
- Nimi
- Tiedoston sijainti
- Napsauta 'OK'

Jokainen projekti sisältää:
- DataStage työpaikkoja
- Sisäänrakennetut komponentit. Nämä ovat ennalta määritettyjä komponentteja, joita käytetään työssä.
- Käyttäjän määrittämät komponentit. Nämä ovat mukautettuja komponentteja, jotka on luotu DataStage Managerilla tai DataStage Designerilla.
Näemme kuinka replikointitöitä tuodaan Datastage Infospheressä.
Replikointitöiden tuominen Datastagessa ja QualityStage Designerissa
Tuot työpaikkoja IBM InfoSphere DataStage- ja QualityStage Designer -asiakasohjelma. Ja täytät ne IBM InfoSphere DataStage- ja QualityStage Director -asiakas.
Suunnittelija-asiakas on kuin tyhjä kangas rakennustöille. Se on esim.tracts, muunna, lataa ja tarkista datan laatu. Se tarjoaa työkaluja, jotka muodostavat työtehtävän perusrakenteet. Se sisältää
- harjoittelupaikkoja: Se muodostaa yhteyden tietolähteisiin lukea tai kirjoittaa tiedostoja ja käsitellä tietoja.
- Linkit: Se yhdistää vaiheet, joita pitkin tietosi kulkevat
InfoSphere DataStage- ja QualityStage Designer -asiakasohjelman vaiheet on tallennettu Designer-työkalupalettiin.
InfoSphere QualityStage sisältää seuraavat vaiheet:
- Tutki vaihetta
- Standardoi vaihe
- Match Frequency -vaihe
- Yhden lähteen otteluvaihe
- Kahden lähteen Match-vaihe
- Selviytyä vaihe
- Standardoinnin laadunarvioinnin (SQA) vaihe
Voit luoda DataStage-infosfäärissä neljän tyyppisiä töitä.
- Rinnakkaistyö
- Jakso Job
- Mainframe-työ
- Palvelimen työ
Katsotaanpa vaihe vaiheelta, kuinka replikointityötiedostot tuodaan.
Vaihe 1) Käynnistä DataStage ja QualityStage Designer. Napsauta Käynnistä > Kaikki ohjelmat > IBM Tietopalvelin > IBM WebSphere DataStage ja QualityStage Designer
Vaihe 2) Anna Liitä projektiin -ikkunassa seuraavat tiedot.
- Domain
- käyttäjätunnus
- Salasana
- Hankkeen nimi
- OK

Vaihe 3) Napsauta nyt Tiedosto-valikosta tuonti -> DataStage-komponentit.
Uusi DataStage Repository Import -ikkuna avautuu.
- Selaa tässä ikkunassa STAGEDB_AQ00_ST00_sJobs.dsx aiemmin luomamme tiedosto
- Valitse vaihtoehto "Tuo kaikki".
- Valitse "Suorita vaikutusanalyysi" -valintaruutu.
- Napsauta OK.

Kun työ on tuotu, DataStage luo STAGEDB_AQ00_ST00_sequence-työn.
Vaihe 4) Noudata samoja vaiheita tuodaksesi STAGEDB_AQ00_ST00_pJobs.dsx-tiedosto. Tämä tuonti luo neljä rinnakkaista työtä.
Vaihe 5) Suunnittelijan arkisto -osiossa -> Avaa SQLREP-kansio. Kansion sisällä näet Sequence Job ja neljä rinnakkaista työtä.
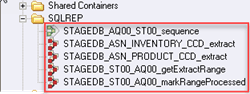
Vaihe 6) Nähdäksesi sarjatyön. Siirry arkistopuuhun, napsauta hiiren kakkospainikkeella STAGEDB_AQ00_ST00_sequence-työtä ja napsauta Muokkaa. Se näyttää neljän rinnakkaisen työn työnkulkua, joita työjärjestys ohjaa.

Jokainen kuvake on näyttämö,
- getExtractRange-vaihe: Se päivittää IBMSNAP_FEEDETL-taulukko. Se asettaa lähtökohdan dataesimerkilletracsiihen pisteeseen asti, jossa DataStage viimeksi poistuitracted-rivit ja aseta lopetuspisteeksi tilausjoukon viimeinen käsitelty tapahtuma.
- getExtractRangeSuccessTämä vaihe antaa lähtökohdat entiselletractFromINVENTORY_CCD-vaihe ja extractFromPRODUCT_CCD-vaihe
- AllExtracOnnistui: Tässä vaiheessa varmistetaan, että molemmat entisettractFromINVENTORY_CCD ja esim.tractFromPRODUCT_CCD suoritettiin onnistuneesti. Sitten viimeksi noudettujen rivien synkronointipisteet välitetään setRangeProcessed-vaiheeseen.
- setRangeProcessed vaihe: Päivittyy IBMSNAP_FEEDETL-taulukko. DataStage siis tietää, mistä aloittaa seuraavan datakierroksen, esim.tracTUKSEN
Vaihe 7) Nähdäksesi rinnakkaiset työt. Napsauta hiiren kakkospainikkeella STAGEDB_ASN_INVENTORY_CCD:tä ja valitse arkistosta muokkaa. Se avaa ikkunan alla olevan kuvan mukaisesti.

Tässä yllä olevassa kuvassa näet, että tiedot Varaston CCD-taulukosta ja Synch pisteen tiedot FEEDETL-taulukosta renderöidään Lookup_6-vaiheeseen.
Tuodut työt eivät vieläkään osoita mihinkään, joten seuraavaksi on määriteltävä datayhteysobjekti.
Datayhteyden luominen DataStagesta STAGEDB-tietokantaan
Seuraava askel on nyt rakentaa tietoyhteys InfoSphere DataStagen ja SQL Replication -kohdetietokannan välille. Se sisältää CCD-taulukot.
DataStagessa käytät datayhteysobjekteja ja niihin liittyviä liitinvaiheita, jotta voit määrittää nopeasti yhteyden tietolähteeseen työn suunnittelussa.
Vaihe 1) STAGEDB sisältää sekä Apply-ohjaustaulut, joita DataStage käyttää dataex-tiedostojensa synkronointiintracja yhtenäisten muutostietojen taulukot, joista tiedot otetaantracted. Käytä seuraavia komentoja
db2 catalog tcpip node SQLREP remote ip_address server 50000
db2 catalog database STAGEDB as STAGEDB2 at node SQLREP
Huomautuksia: Sen järjestelmän IP-osoite, jossa STAGEDB luotiin
Vaihe 2) Napsauta Tiedosto > Uusi > Muu > Tietoyhteys.
Vaihe 3) Sinulla on ikkuna, jossa on kaksi välilehteä, Parametrit ja Yleiset.

Vaihe 4) Tässä vaiheessa
- Yleensä välilehti, anna datayhteydelle nimi sqlreplConnect
- Parametrit-välilehdessä alla olevan kuvan mukaisesti
- Napsauta Selaa-painiketta Yhdistä vaihetyypin avulla -kentän vieressä ja
- Avaa ikkuna ja siirry arkistopuussa Stage Types -> Parallel -> Database -> DB2 Connector -kohtaan.
- Napsauta Avaa.

Vaihe 5) Kirjoita Yhteysparametrit-taulukkoon tiedot, kuten
- ConnectionString: STAGEDB2
- Käyttäjätunnus: Käyttäjätunnus STAGEDB-tietokantaan yhdistämistä varten
- Salasana: Salasana yhteyden muodostamiseksi STAGEDB-tietokantaan
- Ilmentymä: STAGEDB-tietokannan sisältävän DB2-ilmentymän nimi
Vaihe 6) Tallenna datayhteys seuraavassa ikkunassa. Napsauta 'tallenna'-painiketta.
Taulukkomääritelmien tuonti STAGEDB:stä DataStageen
Edellisessä vaiheessa näimme, että InfoSphere DataStage ja STAGEDB-tietokanta on yhdistetty. Tuo nyt sarakemääritykset ja muut metatiedot PRODUCT_CCD- ja INVENTORY_CCD-taulukoille Information Server -säilöön.
Noudata alla olevia ohjeita suunnittelijaikkunassa.
Vaihe 1) Valitse Tuo > Taulukkomääritykset > Käynnistä ohjattu liittimen tuontitoiminto
Vaihe 2) Valitse ohjatun toiminnon liittimen valintasivulta DB2-liitin ja napsauta Seuraava.

Vaihe 3) Napsauta latausta yhteyden tietosivulla. Tämä täyttää ohjatun toiminnon kentät yhteystiedoilla edellisessä luvussa luomastasi datayhteydestä.

Vaihe 4) Napsauta Testaa yhteyttä samalla sivulla. Tämä kehottaa DataStagea yrittämään yhteyttä STAGEDB-tietokantaan. Näet viestin "Yhteys onnistui". Napsauta Seuraava.

Vaihe 5) Varmista, että Tietolähteen sijainti -sivulla Isäntänimi- ja Tietokannan nimi -kentät on täytetty oikein. Napsauta sitten Seuraava.
Vaihe 6) Schema-sivulla. Kirjoita päivitysohjaustaulukoiden (ASN) skeema tai tarkista, että ASN-skeema on esitäytetty skeemakenttään. Napsauta sitten Seuraava. Valintasivulla näkyy luettelo ASN-skeemassa määritellyistä taulukoista.

Vaihe 7) Ensimmäinen taulukko, josta meidän on tuotava metatiedot, on IBMSNAP_FEEDETL, Apply-ohjaustaulukko. Se sisältää synkronointipisteiden tiedot, joiden avulla DataStage voi säilyttää track riviä, joista se on noutanut yhtenäisten muutostietojen taulukoista. Valitse IBMSNAP_FEEDETL ja napsauta Seuraava.
Vaihe 8) Suorittaaksesi tuonnin loppuun IBMTaulukon SNAP_FEEDETL määritelmä. Napsauta tuonti ja napsauta sitten avoimessa ikkunassa avaa.
Vaihe 9) Toista vaiheet 1–8 vielä kaksi kertaa tuodaksesi määritelmät PRODUCT_CCD-taulukolle ja sitten INVENTORY_CCD-taulukolle.
HUOMAUTUS: Kun tuot varaston ja tuotteen määritelmiä, varmista, että vaihdat skeemat ASN:stä skeemaan, jonka mukaan PRODUCT_CCD ja INVENTORY_CCD luotiin.
Nyt DataStagella on kaikki tiedot, joita se tarvitsee muodostaakseen yhteyden SQL Replication -kohdetietokantaan.
DataStage-töiden ominaisuuksien asettaminen
Jokaiselle neljälle DataStage-rinnakkaistyölle, joka meillä on, se sisältää yhden tai useamman vaiheen, jotka ovat yhteydessä STAGEDB-tietokantaan. Sinun on muokattava vaiheita, jotta voit lisätä yhteystietoja ja linkittää DataStagen täyttämiin tietojoukkotiedostoihin.
Vaiheilla on valmiiksi määritettyjä ominaisuuksia, joita voi muokata. Tässä muutamme joitakin näistä ominaisuuksista STAGEDB_ASN_PRODUCT_CCD_ex-tiedostolle.tract rinnakkaistyö.
Vaihe 1) Selaa Designerin tietovarastopuuta. Valitse SQLREP-kansiosta STAGEDB_ASN_PRODUCT_CCD_ex.tracrinnakkaistyö. Muokkaaksesi napsauta työtä hiiren kakkospainikkeella. Rinnakkaistyön suunnitteluikkuna avautuu Suunnittelijapaletissa.
Vaihe 2) Etsi vihreä kuvake. Tämä kuvake merkitsee DB2-liitinvaihetta. Sitä käytetään esimerkiksitractietojen hakeminen yhtenäisten muutostietojen taulukosta. Double-klikkaa kuvaketta. Vaiheen muokkausikkuna avautuu.


Vaihe 3) Napsauta editorissa Lataa täyttääksesi kentät yhteystiedoilla. Sulje vaiheeditori ja tallenna muutokset napsauttamalla OK.
Vaihe 4) Palaa nyt STAGEDB_ASN_PRODUCT_CCD_ex-tiedoston suunnitteluikkunaan.tracrinnakkaistyö. Etsi get-komennon kuvake.SynchPoints DB2 -liitinvaihe. Kaksoisnapsauta sitten kuvaketta.
Vaihe 5) Napsauta nyt latauspainiketta täyttääksesi kentät yhteystiedoilla.
HUOMAUTUS: Jos käytät muutosten ohjauspalvelimena muuta tietokantaa kuin STAGEDB. Valitse sitten vaihtoehto ladata yhteystiedot getilleSynchPoints-vaihe, joka on vuorovaikutuksessa ohjaustaulukoiden kanssa CCD-taulukon sijaan.
Vaihe 6) Tässä vaiheessa
- Tee tyhjä tekstitiedosto järjestelmään, jossa InfoSphere DataStage toimii.
- Nimeä tämä tiedosto nimellä productdataset.ds ja merkitse muistiin, minne olet sen tallentanut.
- DataStage kirjoittaa muutokset tähän tiedostoon sen jälkeen, kun se on hakenut muutokset CCD-taulukosta.
- Tietojoukot tai tiedostot, joita käytetään tietojen siirtämiseen linkitettyjen töiden välillä, tunnetaan pysyvinä tietojoukkoina. Sitä edustaa DataSet-vaihe.
Vaihe 7) Avaa nyt vaiheeditori suunnitteluikkunassa ja kaksoisnapsauta kuvaketta insert_into_a_dataset. Se avaa toisen ikkunan.

Vaihe 8) Tässä ikkunassa

- Varmista Ominaisuudet-välilehden alla, että Target kansio on auki ja ominaisuus File = DATASETNAME on korostettuna.
- Oikealla on tiedostokenttä
- Anna koko polku productdataset.ds-tiedostoon
- Napsauta OK.
Olet nyt päivittänyt kaikki tarvittavat tuotteen CCD-taulukon ominaisuudet. Sulje suunnitteluikkuna ja tallenna kaikki muutokset.
Vaihe 9) Etsi ja avaa nyt STAGEDB_ASN_INVENTORY_CCD_extracrinnakkaistyö suunnittelijan tietovarastoruudusta ja toista vaiheet 3–8.
HUOMAUTUS:
- Sinun on ladattava ohjauspalvelimen tietokannan yhteystiedot vaiheeditoriin getiä vartenSynchPoints-vaihe. Jos ohjauspalvelimesi ei ole STAGEDB.
- STAGEDB_ST00_AQ00_getEx-muuttujalletractRange- ja STAGEDB_ST00_AQ00_markRangeProcessed-rinnakkaisten töiden jälkeen avaa kaikki DB2-liitinvaiheet. Lisää sitten STAGEDB-tietokannan yhteystiedot load-funktion avulla.
Kaikki ominaisuudet on nyt asetettu, joten työt voidaan kääntää ja suorittaa.
DataStage-töiden kääntäminen ja suorittaminen
Kun DataStage-työ on valmis kääntämään, suunnittelija vahvistaa työn suunnittelun tarkastelemalla syötteitä, muunnoksia, lausekkeita ja muita yksityiskohtia.
Kun työn kokoaminen on suoritettu onnistuneesti, se on valmis suoritettavaksi. Kokoamme kaikki viisi työtä, mutta suoritamme vain "työjärjestyksen". Tämä johtuu siitä, että tämä työ hallitsee kaikkia neljää rinnakkaista työtä.
Vaihe 1) SQLREP-kansiossa. Valitse jokainen viidestä työstä painamalla (Ctrl+Shift). Napsauta sitten hiiren kakkospainikkeella ja valitse Usean työn käännösvaihtoehto.

Vaihe 2) Näet viisi työtä valittuna ohjatussa DataStage Compilation Wizardissa. Napsauta Seuraava.

Vaihe 3) Kääntäminen alkaa ja näyttöön tulee viesti "Käännetty onnistui", kun se on valmis.

Vaihe 4) Käynnistä nyt DataStage ja QualityStage Director. Valitse Käynnistä > Kaikki ohjelmat > IBM Tietopalvelin > IBM WebSphere DataStage ja QualityStage Director.
Vaihe 5) Projektin navigointiruudussa vasemmalla. Napsauta SQLREP-kansiota. Tämä tuo kaikki viisi tehtävää johtajan tilataulukkoon.
Vaihe 6) Valitse STAGEDB_AQ00_S00_sequence-työ. Napsauta valikkoriviltä Työ > Suorita nyt.

Kun kokoelma on valmis, näet valmiin tilan.

Tarkista nyt, ovatko PRODUCT_CCD- ja INVENTORY_CCD-taulukoihin tallennetut muutetut rivit olleet käytössä.tracDataStage on määrittänyt ja lisännyt sen kahteen tietojoukkotiedostoon.
Vaihe 7) Palaa Designer-ohjelmaan ja avaa STAGEDB_ASN_PRODUCT_CCD_ex-tiedosto.tract-työ. Avaa vaihemuokkausohjelma Double-napsauta insert_into_a_dataset -kuvaketta. Napsauta sitten Näytä tiedot.
Vaihe 8) Hyväksy näytettävän ikkunan rivien oletusasetukset. Napsauta sitten OK. Tietojen selainikkuna avautuu näyttämään tietojoukkotiedoston sisällön.

SQL-replicaation ja DataStage-integraation testaus
Edellisessä vaiheessa kokosimme ja suoritimme työn. Tässä osiossa tarkistamme SQL-replikoinnin ja DataStagen integroinnin. Tätä varten teemme muutoksia lähdetaulukkoon ja katsomme, onko sama muutos päivitetty DataStageen.
Vaihe 1) Siirry käyttöjärjestelmäsi kansioon sqlrepl-datastage-scripts.
Vaihe 2) Käynnistä SQL-replikointi seuraavasti:
- Suorita startSQLCapture.bat (Windows) -tiedosto käynnistääksesi Capture-ohjelman SALES-tietokannassa.
- Suorita startSQLApply.bat (Windows) -tiedosto käynnistääksesi Apply-ohjelman STAGEDB-tietokannassa.
Vaihe 3) Avaa nyt updateSourceTables.sql-tiedosto. Vaihda SALES-tietokantaan yhdistämistä varten ja käyttäjätunnuksella ja salasanalla.
Vaihe 4) Avaa DB2-komentoikkuna. Vaihda hakemistoon sqlrepl-datastage-tutorial\scripts ja suorita ongelma annetulla komennolla:
db2 -tvf updateSourceTables.sql
SQL-skripti suorittaa erilaisia toimintoja, kuten päivitys, lisäys ja poisto molemmissa myyntitietokannan taulukoissa (TUOTE, INVENTORY).
Vaihe 5) Järjestelmässä, jossa DataStage on käynnissä. Avaa DataStage Director ja suorita STAGEDB_AQ00_S00_sequence-työ. Napsauta Työ > Suorita nyt.

Kun suoritat työtä, suoritetaan seuraavat toiminnot.
- Capture-ohjelma lukee kuuden rivin muutokset SALES-tietokannan lokista ja lisää ne CD-taulukoihin.
- Apply-ohjelma hakee muutosrivit CD-taulukoista SALES-sivustosta ja lisää ne STAGEDB:n CCD-taulukoihin.
- Kaksi DataStage-esimerkkiätract-työt poimivat muutokset CCD-taulukoista ja kirjoittavat ne productdataset.ds- ja inventory dataset.ds-tiedostoihin.
Voit tarkistaa, että yllä olevat vaiheet tapahtuivat katsomalla tietojoukkoja.
Vaihe 6) Noudata alla olevia ohjeita,
- Käynnistä suunnitteluohjelma. Avaa STAGEDB_ASN_PRODUCT_CCD_extract-työ.
- Sitten Double-napsauta insert_into_a_dataset -kuvaketta. Lavaeditorissa. Napsauta Näytä tiedot.
- Hyväksy näytettävien rivien oletusasetukset ja napsauta OK.
Tietojoukko sisältää kolme uutta riviä. Helpoin tapa tarkistaa muutosten toteutuminen on selata tietoselaimen oikeaa reunaa alaspäin. Katso nyt kolme viimeistä riviä (katso kuva alla)

Kirjain I, U ja D määrittelevät INSERT-, UPDATE- ja DELETE-toiminnot, jotka johtivat jokaiseen uuteen riviin.
Voit tehdä saman tarkistuksen Varastotaulukolle.
DataStage vs. muut suositut ETL-työkalut
Kun kokonaisvaltainen prosessi toimii, seuraava kysymys on yleensä se, missä DataStage sijoittuu tiimin jo omistamiin vaihtoehtoihin verrattuna. Alla olevassa taulukossa sitä verrataan kolmeen laajalti käytettyyn alustaan useimmin ostopäätökseen vaikuttavien kriteerien perusteella.
| Kriteeri | IBM DataStage | tietokone PowerCenter | Talend | SSIS |
|---|---|---|---|---|
| Käsittelymalli | Putkilinjan ja osioiden rinnakkaisuus | Metadatapohjainen osiointi | luotu Java or Spark koodi | Muistin sisäinen tiedonkulku |
| Parhaiten sopiva | Erittäin suuret yritystason erä- ja CDC-työkuormat | Monimutkaiset vanhat arkkitehtuurit ja raskas hallinta | Pilvinatiivit ja kustannusherkät tiimit | Microsoft SQL Server säädyt |
| Licensing | Kaupallinen, premium-taso | Kaupallinen | Avoimen lähdekoodin versio sekä kaupalliset tasot | Mukana SQL Server |
| Oppimiskäyrä | Jyrkkä, ETL-asiantuntijoita tarvitaan | Jyrkkä | Keskitasoinen, koodaustaito auttaa | Kohtalainen |
| Tietojen laatu | QualityStage sisältyy sviittiin | Erillinen datan laatua parantava tuote | Talend Data Quality sisältyy hintaan | Lisäosat |
Lyhyesti sanottuna DataStage valitaan, kun raaka läpimenoaika, keskustietokoneiden ulottuvuus ja auditointivalmius merkitsevät enemmän kuin lisenssikustannukset. Tiimit työskentelevät pääasiassa pilvessä. Data Lake -arkkitehtuuri tai vertaamalla esim.tract-järjestys ensin voi löytää kompromissit ETL vs ELT asiaankuuluvampi, ja laajempi lista näkyy koosteessa ETL-työkalut ja tietojen integrointityökalut.
