
Tietovarasto Architecture, komponentit ja kaavio Concepts
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
Tietovarasto ArchiRakenne määrittelee, miten useista lähteistä peräisin oleva historiallinen ja kumulatiivinen data järjestetään porrastetuiksi kerroksiksi ja toisiinsa kytketyiksi komponenteiksi, mikä mahdollistaa luotettavan raportoinnin, analyysin ja yhden version totuudesta organisaation päätöksentekoon ja ennustamiseen.
Tietovarasto Concepts
A tietovarasto on olemassa antaakseen yritykselle yhden version totuudesta päätöksentekoa ja ennustamista varten. Se on tietojärjestelmä, joka sisältää yhdestä tai useammasta lähteestä peräisin olevaa historiallista ja kumulatiivista dataa.
Järjestämällä tiedot analysointia varten tapahtumien sijaan, tietovarasto yksinkertaistaa koko organisaation raportointi- ja analysointityötä.
Tietovaraston ominaisuudet
Tietovarastolla on neljä määrittelevää ominaisuutta, jotka erottavat sen rutiininomaisesta operatiivisesta tietokannasta:
- Aihesuuntautunut
- Integroitu
- Aika-variantti
- Haihtumaton
Aihesuuntautunut
Tietovarasto on aihekohtainen, koska se tarjoaa tietoa tietystä teemasta pikemminkin kuin yrityksen jatkuvista toiminnoista. Tyypillisiä aiheita ovat myynti, markkinointi ja jakelu.
Päivittäisen prosessoinnin sijaan tietovarasto painottaa päätöksenteon mallintamista ja analysointia. Se tarjoaa yksinkertaisen ja tiiviin kuvan jokaisesta aiheesta ja jättää pois tiedot, jotka eivät tue päätöksentekoprosessia.
Integroitu
Integrointi on läheisesti sidoksissa aihekeskeisyyteen. Tietovarastossa integrointi tarkoittaa yhteisen mittayksikön luomista kaikille samankaltaisille tiedoille, jotka on saatu erilaisista tietokannoista, ja kyseisen tiedon tallentamista yhteisellä, yleisesti hyväksyttävällä tavalla.
Tietovarasto rakennetaan yhdistämällä tietoja eri lähteistä, kuten keskustietokoneesta, relaatiotietokannoista ja flat-tiedostoista. Sen on myös noudatettava yhdenmukaisia nimeämiskäytäntöjä, muotoja ja koodauskäytäntöjä.
Tämä nimeämisen, attribuuttimittareiden ja koodausrakenteen yhdenmukaisuus mahdollistaa tehokkaan analyysin. Tarkastellaan seuraavaa esimerkkiä:
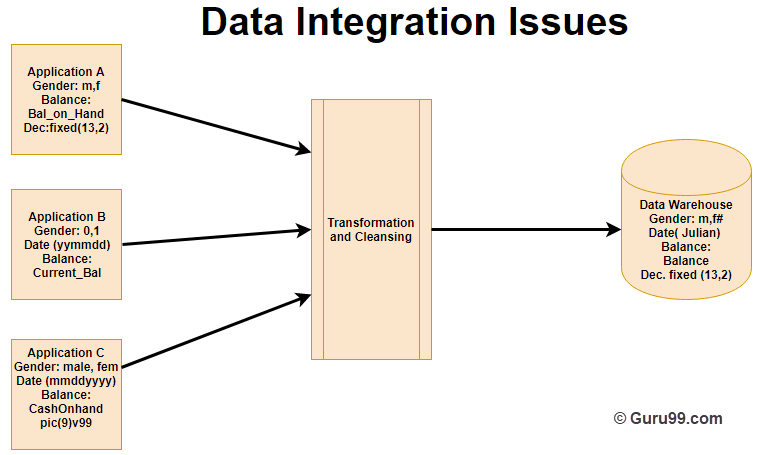
Yllä olevassa esimerkissä kolme A:lla, B:llä ja C:llä merkittyä sovellusta tallentaa kukin sukupuolen, päivämäärän ja saldon tiedot, mutta jokainen sovellus tallentaa ne eri tavalla:
- Sovellus A tallentaa sukupuolikentän loogisten arvoina, kuten M tai F.
- Sovellus B tallentaa sukupuolikentän numeerisena arvona.
- Sovellus C tallentaa sukupuolikentän merkkiarvona.
- Sama muutos koskee Päivämäärä- ja Saldo-kenttiä.
Muunnos- ja puhdistusprosessin jälkeen kaikki tämä data tallennetaan yhteiseen muotoon tietovaraston sisällä.
Aika-variantti
Tietovaraston aikahorisontti on paljon laajempi kuin operatiivisen järjestelmän. Data tunnistetaan tietyllä ajanjaksolla ja tarjoaa historiallisen näkökulman, joten se sisältää aina ajan elementin, joko eksplisiittisesti tai implisiittisesti.
Yksi paikka, jossa tämä aikavarianssi esiintyy, on tietueavaimen rakenne. Jokaisessa tietovaraston ensisijaisessa avaimessa tulisi olla aikaelementti, kuten päivä, viikko tai kuukausi.
Toinen aikavarianssin näkökohta on, että kun tiedot on syötetty varastoon, niitä ei voida päivittää tai muuttaa.
Haihtumaton
Tietovarasto on myös pysyvä, mikä tarkoittaa, että aiempia tietoja ei poisteta uuden datan saapuessa. Data on vain luku -tilassa ja sitä päivitetään säännöllisesti, mikä auttaa analyytikoita tutkimaan historiallisia tietoja ja ymmärtämään, mitä tapahtui ja milloin.
Koska tietovarasto ei tarvitse tapahtumien käsittelyä, palautusta tai samanaikaisuuden hallintaa, se jättää pois operatiivisissa sovelluksissa yleiset poisto-, päivitys- ja lisäystoiminnot. Tietovarastoinnissa suoritetaan vain kaksi datatoimintoa:
- Tietojen lataaminen
- Tietojen käyttö
Alla oleva taulukko korostaa joitakin merkittäviä eroja operatiivisen sovelluksen ja tietovaraston välillä:
| Operakansallinen sovellus | Tietovarasto |
|---|---|
| Monimutkainen ohjelma on koodattava sen varmistamiseksi, että tietojen päivitysprosessit säilyttävät lopputuotteen korkean eheyden. | Tällaista ongelmaa ei esiinny, koska datapäivitystä ei suoriteta. |
| Tiedot sijoitetaan normalisoituun muotoon minimaalisen redundanssin varmistamiseksi. | Tietoja ei tallenneta normalisoidussa muodossa. |
| Transaktioiden, tietojen palautuksen, palautuksen ja umpikujien ratkaisemisen tukemiseen tarvittava teknologia on melko monimutkaista. | Se tarjoaa suhteellisen yksinkertaisuuden tekniikassa. |
Tietovarasto Archirakenne
Tietovarasto ArchiRakenne on monimutkainen, koska järjestelmä tallentaa historiallista ja kumulatiivista dataa useista lähteistä. Varastokerrosten rakentamiseen on kolme lähestymistapaa: yksikerroksinen, kaksikerroksinen ja kolmikerroksinen.
Yksitasoinen arkkitehtuuri pyrkii minimoimaan tallennettavan tiedon määrän poistamalla redundanssia. Sitä käytetään käytännössä harvoin.
Kaksikerroksinen arkkitehtuuri erottaa fyysisesti saatavilla olevat lähteet tietovarastosta. Sitä ei ole helppo laajentaa, se tukee vähemmän loppukäyttäjiä ja voi kohdata yhteysongelmia verkon rajoitusten vuoksi.
Kolmikerroksinen arkkitehtuuri on tietovaraston yleisimmin käytetty suunnittelutapa.
Se koostuu ylä-, keski- ja alatasoista:
- Alin taso: Tietovaraston tietokanta toimii pohjakerroksena. Se on yleensä relaatiotietokantajärjestelmä, ja tiedot puhdistetaan, muunnetaan ja ladataan tälle kerrokselle taustatyökalujen avulla.
- Keskitaso: Keskimmäinen taso on OLAP-palvelin, joka on toteutettu joko ROLAP- tai MOLAP-mallilla. Se esittää abs.tracnäkymä tietokantaan ja toimii välittäjänä loppukäyttäjän ja tietokannan välillä.
- Ylin taso: Ylin taso on käyttöliittymäasiakastaso. Se sisältää työkalut ja API:t, joita käytetään tiedon yhdistämiseen ja hakemiseen tietovarastosta, kuten kyselytyökalut, raportointityökalut, hallitut kyselytyökalut, analyysityökalut ja tiedonlouhintatyökalut.
Tietovaraston komponentit
Tietovaraston komponentit ja kokonaisarkkitehtuuri toimivat yhdessä alla olevan kaavion mukaisesti.
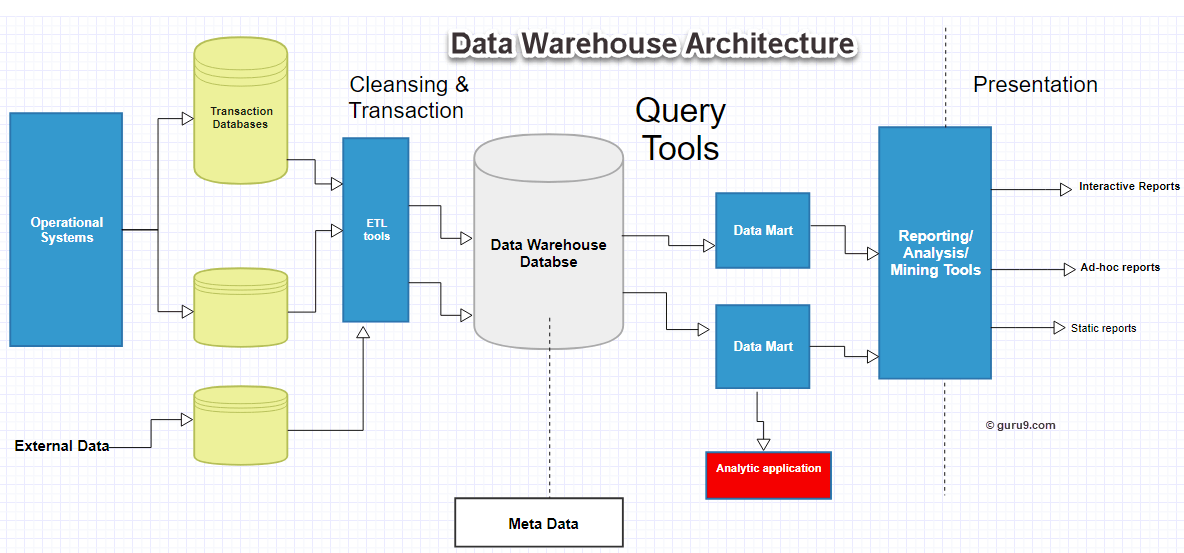
Tietovarasto perustuu RDBMS-palvelimeen, joka on keskeinen tietovarasto ja jota ympäröivät keskeiset komponentit, jotka pitävät koko ympäristön toimivana, hallittavana ja saavutettavana.
Tietovarastolla on viisi pääkomponenttia, jotka on kuvattu alla.
Data Warehouse -tietokanta
Keskustietokanta on varastointiympäristön perusta ja se on toteutettu RDBMS teknologia. Koska perinteinen RDBMS on viritetty tapahtumien käsittelyyn eikä varastointiin, resursseja vaativat toiminnot, kuten ad-hoc-kyselyt, usean taulukon liitokset ja aggregaatit, voivat hidastaa sitä.
Tästä syystä käytetään vaihtoehtoisia tietokantamenetelmiä:
- Relaatiotietokantoja otetaan käyttöön rinnakkain skaalautuvuuden mahdollistamiseksi käyttämällä jaettua muistia tai jaettua ei-mitään -malleja erilaisissa moniprosessori- tai massiivisesti rinnakkaisissa kokoonpanoissa.
- Uusia indeksirakenteita käytetään relaatiotaulukoiden skannausten ohittamiseen ja nopeuden parantamiseen.
- Moniulotteisia tietokantoja (MDDB) käytetään relaatiomallien rajoitusten voittamiseen. Esimerkkinä tästä on Essbase Oracle.
Sourcing, Acquisition, Clean-up and Transformation Tools (ETL)
Tiedonhankinta-, muunnos- ja migraatiotyökalut suorittavat kaikki muunnokset, yhteenvedot ja muutokset, joita tarvitaan tiedon muuttamiseksi yhtenäiseen tietovarastomuotoon. Niitä kutsutaan myös Ex-työkaluiksi.tract-, muunto- ja lataustyökalut (ETL).
Niiden toiminnallisuuteen kuuluvat seuraavat:
- Anonymisoi tiedot säännösten mukaisesti.
- Poista ei-toivotut tiedot operatiivisista tietokannoista ennen niiden lataamista varastoon.
- Etsi ja korvaa yleisiä nimiä ja määritelmiä eri lähteistä tulevalle tiedolle.
- Laske yhteenvedot ja johdetut tiedot.
- Täytä puuttuvat tiedot oletusarvoilla.
- Poista useista lähteistä tuleva toistuva datan duplikaatit.
Nämä ETL-työkalut voi luoda cron-töitä, taustatöitä, Cobol-ohjelmia ja komentosarjoja, jotka päivittävät säännöllisesti tietovarastoa ja auttavat ylläpitämään metatietoja.
Koska ETL-työkalut hyödyntävät monia järjestelmiä, niiden on myös kyettävä selviytymään tietokantojen ja datan heterogeenisyydestä.
Metadata
Metadata saattaa kuulostaa monimutkaiselta, mutta se on yksinkertaisesti tietoa datasta, joka määrittelee varaston. Sitä käytetään varaston rakentamiseen, ylläpitoon ja hallintaan.
Arkkitehtuurin sisällä metatiedot määrittävät datan lähteen, käytön, arvot ja ominaisuudet sekä sen, miten dataa voidaan muuttaa ja käsitellä, jotta se pysyy tiiviisti yhteydessä tietovarastoon.
Esimerkiksi myyntitietokannan rivi voi sisältää:
4030 KJ732 299.90
Tämä on merkityksetöntä, kunnes metatiedoissa selitetään, että se edustaa mallinumeroa 4030, myyntiedustajan tunnusta KJ732 ja kokonaismyyntisummaa 299.90 dollaria.
Metadata on siksi olennainen osa datan muuntamista tiedoksi, ja se auttaa vastaamaan kysymyksiin, kuten:
- Mitä taulukoita, attribuutteja ja avaimia varasto sisältää?
- Mistä tiedot ovat peräisin?
- Kuinka monta kertaa tiedot ladataan uudelleen?
- Mitä muutoksia ja puhdistusmenetelmiä sovellettiin?
Metadata jaetaan kahteen luokkaan:
- Tekniset metatiedot: Tämä kuvaa varastoa suunnittelijoille ja ylläpitäjille, jotka rakentavat ja ylläpitävät sitä.
- Yrityksen metatiedot: Tämä antaa loppukäyttäjille helpon tavan ymmärtää varastossa tallennettuja tietoja.
Kyselytyökalut
Tietovarastoinnin ensisijainen tavoite on antaa yrityksille tiedot, joita ne tarvitsevat strategisten päätösten tekemiseen, ja kyselytyökalut ovat tapa, jolla käyttäjät ovat vuorovaikutuksessa järjestelmän kanssa.
Nämä työkalut voidaan jakaa neljään luokkaan:
- Kysely- ja raportointityökalut
- Sovelluskehitystyökalut
- Tiedonlouhintatyökalut
- OLAP-työkalut
Kysely- ja raportointityökalut
Kysely- ja raportointityökalut voidaan jakaa kahteen ryhmään: raportointityökaluihin ja hallittuihin kyselytyökaluihin.
Raportointityökalut jaetaan edelleen tuotantoraportointityökaluihin ja työpöytäraporttien kirjoittajiin:
- Raportin kirjoittajat: Nämä on suunniteltu loppukäyttäjille, jotka rakentavat omia analyysejään.
- Tuotantoraportointi: Näiden avulla organisaatiot voivat luoda säännöllisiä operatiivisia raportteja ja tukea suuren volyymin erätöitä, kuten tulostusta ja laskentaa. Suosittuja esimerkkejä ovat Brio, Business Objects, Oracle, PowerSoft ja SAS-instituutti.
Hallitut kyselytyökalut auttaa loppukäyttäjiä lisäämällä metakerroksen käyttäjän ja tietokannan väliin, mikä piilottaa SQL:n ja tietokannan rakenteen monimutkaisuuden.
Sovelluskehitystyökalut
Kun sisäänrakennetut graafiset ja analytiikkatyökalut eivät pysty vastaamaan organisaation analytiikkatarpeisiin, mukautetut raportit luodaan sovelluskehitystyökaluilla.
Tiedonlouhintatyökalut
Tiedonlouhinta löytää merkittäviä uusia korrelaatioita, malleja ja trendejä suurista datamääristä, ja tiedonlouhintatyökalut automatisoivat tämän löydön.
OLAP-työkalut
OLAP Työkalut perustuvat moniulotteiseen tietokantaan ja antavat käyttäjien analysoida tietoja monimutkaisten, moniulotteisten näkymien kautta.
Tietovarastoväylä Archirakenne
Tietovaraston väylä määrittää, miten data virtaa varaston läpi. Tämä virtaus voidaan luokitella sisäänvirtaukseksi, ylösvirtaukseksi, alasvirtaukseksi, ulosvirtaukseksi ja metavirtaukseksi.
Väylää suunniteltaessa on otettava huomioon datamarttien yhteiset ulottuvuudet ja faktat.
Data Marts
A data mart on käyttöoikeustaso, jota käytetään datan toimittamiseen käyttäjille. Se sopii suurille varastoille, koska sen rakentaminen vie vähemmän aikaa ja rahaa, vaikka datamartille ei olekaan yhtä ainoaa hyväksyttyä määritelmää.
Yksinkertaisesti sanottuna datamart on tietovaraston tytäryhtiö. Se osioi tiedot tietylle käyttäjäryhmälle ja voi sijaita samassa tietokannassa kuin tietovarasto tai fyysisesti erillisessä tietokannassa.
Tietovarasto Architecture Best Practices
Suunnitellaksesi toimivan tietovarastoarkkitehtuurin, noudata seuraavia parhaita käytäntöjä:
- Käytä tietovarastomalleja, jotka on optimoitu tiedonhakuun, olipa kyseessä sitten ulotteinen, denormalisoitu tai hybridi-lähestymistapa.
- Valitse sopiva suunnittelutapa, olipa se sitten ylhäältä alas tai alhaalta ylös.
- Varmista, että tiedot käsitellään nopeasti ja tarkasti samalla, kun ne yhdistetään yhdeksi totuuden versioksi.
- Suunnittele huolellisesti varaston tiedonkeruu- ja puhdistusprosessi.
- Suunnittele metadata-arkkitehtuuri, joka mahdollistaa metadatan jakamisen tietovaraston komponenttien välillä.
- Harkitse Operanational data store (ODS) -mallia, kun hakutarpeet ovat lähellä data-abstraktion pohjaatraction pyramidissa tai kun on käytettävä useita toiminnallisia lähteitä.
- Varmista, että datamalli on integroitu eikä pelkästään konsolidoitu; käytä siinä tapauksessa 3NF-datamallia, joka on myös ihanteellinen ETL:ää ja datanpuhdistustyökaluja hankittaessa.
