
Hive ETL: Ladataan JSON-, XML-, tekstitietoesimerkkejä
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
Hive ETL muuntaa teksti-, XML- ja JSON-tiedostot kyselykelpoisiksi taulukoiksi lataamalla ne Hiveen ja ex-tiedostoihin.tracarvojen syöttäminen xpath():lla ja get_json_object():lla, mikä antaa analyytikoille SQL-rajapinnan puolistrukturoidun Hadoop-datan yli.
Hive ETL- ja tietovarastointityökaluna Hadoop ekosysteemi tarjoaa toimintoja, kuten datan mallinnuksen, datan manipuloinnin, datan käsittelyn ja datakyselyt. Data extracHivessä tarkoitetaan taulukoiden luomista Hiveen ja strukturoidun ja puolistrukturoidun datan lataamista sekä datan kyselyä vaatimusten perusteella.
Eräkäsittelyä varten aiomme kirjoittaa mukautettuja komentosarjoja käyttämällä mukautettua karttaa ja lyhentää komentosarjoja komentosarjakielellä. Se tarjoaa SQL kuten ympäristö ja tuki helppoa kyselyä varten.
Työskentely strukturoidun tiedon kanssa Hiven avulla
Rakenteinen data tarkoittaa, että data on oikeassa rivi- ja sarakemuodossa. Tämä on pikemminkin kuin RDBMS tiedot oikeilla riveillä ja sarakkeilla.
Tässä lataamme Hive-tiedostoissa olevia strukturoituja tietoja.
Vaihe 1) Tässä vaiheessa luomme taulukon "employees_guru" sarakkeiden nimillä, kuten Id, Nimi, Ikä, Osoite, Palkka ja Osasto tietotyypeineen.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Taulukon "employees_guru" luominen
- Ladataan tietoja Employees.txt-tiedostosta taulukkoon “employees_guru”
Vaihe 2) Tässä vaiheessa näytämme tähän taulukkoon tallennetun sisällön käyttämällä "Select"-komentoa. Voimme tarkastella taulukon sisältöä seuraavassa kuvakaappauksessa.

Esimerkki koodinpätkästä
Suoritettavat kyselyt
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
Puolistrukturoidun datan käsittely Hiven avulla (XML, JSON)
Hive suorittaa ETL-toimintoja Hadoop-ekosysteemissä toimimalla ETL työkaluMapReducen suorittaminen voi olla vaikeaa tietyntyyppisissä sovelluksissa; Hive voi vähentää tätä monimutkaisuutta ja tarjoaa parhaan ratkaisun IT-sovelluksille tietovarastointisektorin kannalta.
Puolistrukturoitua dataa, kuten XML:ää ja JSON:ia, voidaan käsitellä vähemmän monimutkaisesti Hiven avulla. Ensin katsomme, miten voimme käyttää Hiveä seuraaviin tarkoituksiin: XML.
XML Hive-taulukkoon
Tässä aiomme ladata XML-tietoja Hive-taulukoihin ja haemme XML-tunnisteisiin tallennetut arvot.
Vaihe 1) Taulukon ”xmlsample_guru” luonti, jonka tietotyyppi on merkkijono ja jonka sarake on merkkijono.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Taulukon "xmlsample_guru" luominen
- Ladataan tietoja test.xml-tiedostosta taulukkoon “xmlsample_guru”
Vaihe 2) Käyttäen XPath xpath()-metodin avulla voimme hakea XML-tageihin tallennetut tiedot.
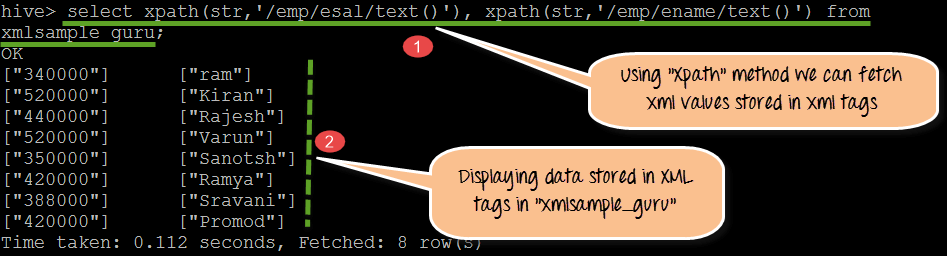
Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Käyttämällä xpath()-metodia noudamme /emp/esal/- ja /emp/ename/-hakemistoihin tallennetut arvot.
- XML-tunnisteiden sisällä olevat arvot. Tässä vaiheessa näytämme XML-tunnisteiden alle tallennetut todelliset arvot taulukossa ”xmlsample_guru”.
Huomaa, että xpath() palauttaa merkkijonotaulukon; xpath_string(), xpath_int() ja xpath_double() palauttavat yhden tyypityn arvon.
Vaihe 3) Tässä vaiheessa noudamme ja näytämme taulukon ”xmlsample_guru” raaka-XML-tiedoston.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Varsinainen XML-data, joka näytetään tunnisteiden kanssa
- Jos havaitsemme vain yhden tagin, sen päätagina on "emp" ja lapsitagina "ename" ja "esal".
Code katkelma:
Suoritettavat kyselyt
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
JSON (JavaScript Object Notation)
Sosiaalisen median ja verkkosivustojen tiedot tallennetaan yleensä JSON-muodossa. Aina kun yritämme hakea tietoja verkkopalvelimilta, se palauttaa JSON-tiedostoja. Käyttämällä Hiveä tietovarastona voimme ladata JSON-tietoja Hive-taulukoihin luomalla skeemoja.
JSON Hive-taulukkoon
Tässä lataamme JSON-dataa Hive-taulukoihin ja noudamme JSON-skeemaan tallennetut arvot.
Vaihe 1) Tässä vaiheessa luomme JSON-taulukon nimeltä ”json_guru”. Kun se on luotu, lataamme ja näytämme varsinaisen skeeman sisällön.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Taulukon "json_guru" luominen
- Ladataan dataa test.json-tiedostosta taulukkoon “json_guru”
- json_guru-taulukkoon tallennetun JSON-tiedoston todellisen skeeman näyttäminen
Vaihe 2) get_json_object()-metodin avulla voimme hakea JSON-hierarkiaan tallennetut data-arvot.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Käyttämällä get_json_object(str,'$.ecode') se voi hakea ecode-arvoja taulukosta json_guru. Vastaavasti käyttämällä get_json_object(str,'$.ename') ja get_json_object(str,'$.sal') se hakee ename- ja sal-arvot taulukosta json_guru.
- JSON-hierarkian sisällä json_guru-tiedostossa tallennetut arvot
Koska get_json_object() jäsentää dokumentin kerran kutsua kohden, json_tuple() on halvempi, kun tarvitaan useita avaimia, ja JSON SerDe mappaa dokumentin tyypitettyihin sarakkeisiin latausaikana.
Code pätkä
Suoritettavat kyselyt
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
Monimutkainen JSON Hive-taulukkoon
Tässä lataamme monimutkaista JSON-dataa Hive-taulukoihin ja noudamme JSON-skeemaan tallennetut arvot.
Vaihe 1) Yhden sarakkeen kentän avulla luodaan complexjson_guru.

Yllä olevasta kuvakaappauksesta voimme havaita seuraavaa:
- Yhden merkkijonotyyppisen sarakekentän luonti taulukossa complexjson_guru
- Datan lataaminen complexjson_guru-tiedostoon emp.json-kompleksisesta JSON-tiedostosta
Vaihe 2) Käyttämällä get_json_object-metodia voimme hakea JSON-tiedostohierarkiaan tallennetun varsinaisen sisällön.
Seuraavasta kuvakaappauksesta näemme complexjson_guru-muuttujaan tallennetun datan tulosteen.
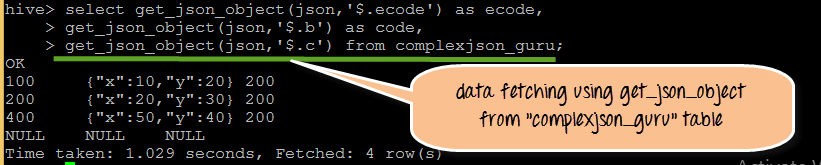
Vaihe 3) Tässä vaiheessa käyttämällä ”Select”-komentoa voimme nähdä ”complexjson_guru”-taulukkoon tallennetut monimutkaiset JSON-tiedot.

Esimerkki koodinpätkästä
Suoritettavat kyselyt
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
Hive reaaliaikaisissa projekteissa – milloin ja missä käyttää
Milloin ja missä Hiveä käytetään Hadoop-ekosysteemissä:
Kun
- Kun työskentelet vahvojen ja tehokkaiden tilastollisten funktioiden kanssa Hadoop-ekosysteemissä
- Kun työskentelet strukturoidun ja puolistrukturoidun tiedonkäsittelyn parissa
- Tietovarastotyökaluna Hadoopin kanssa
- Reaaliaikainen datan syöttäminen HBasen avulla, jossa Hiveä voidaan käyttää
Missä
- Helppokäyttöisyyttä varten ETL- ja tietovarastointityökaluna
- SQL-tyyppiympäristön tarjoaminen ja SQL-kyselyiden tekeminen HiveQL:n avulla
- Käyttää ja ottaa käyttöön mukautettuja kartta- ja reducer-skriptejä tiettyjen asiakasvaatimusten mukaisesti
