
Luo ja pudota INDEX Cassandra
 David Carter
⚡ Älykäs yhteenveto
Luo ja pudota indeksi Cassandra mahdollistaa suodatuksen sarakkeissa, jotka eivät ole osa ensisijaista avainta. Tämä sivu käsittelee CREATE INDEX- ja DROP INDEX -komentoja, nimeämissääntöjä, käytettävissä olevia indeksityyppejä ja tapauksia, joissa indeksi on väärä vastaus.
Cassandra Luo hakemisto
Komento "Create index" luo indeksin käyttäjän määrittelemään sarakkeeseen. Jos indeksoitavan sarakkeen tiedot ovat jo olemassa, Cassandra luo indeksejä dataan "create index" -käskyn suorittamisen aikana.
- Indeksin luomisen jälkeen Cassandra indeksoi uudet tiedot automaattisesti, kun tietoja lisätään.
- Indeksiä ei voida luoda ensisijaiselle avaimelle, koska ensisijainen avain on jo indeksoitu.
- Kokoelmasarakkeiden indeksejä tuetaan KEYS-, VALUES- tai ENTRIES-lomakkeen avulla riippuen siitä, mitä on haettava.
- Ilman indeksointia sarakkeeseen, Cassandra Saraketta ei voi suodattaa, ellei se ole ensisijainen avain.
Siksi sarakkeiden suodattamiseen Cassandra, indeksit on luotava.
Syntaksi
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
esimerkki
Tässä on tilannekuva, jossa yritettiin suodattaa "dept" -saraketta luomatta hakemistoa. Vastauksena virhe palautettiin.

Tässä on tilannekuva, jossa indeksi luodaan osastosarakkeeseen.

CREATE INDEX DeptIndex ON University.Student (dept);
Tässä on tilannekuva, jossa se suodatetaan onnistuneesti "osasto"-sarakkeessa.

SELECT * FROM University.Student WHERE dept = 'CS';
Indeksin nimi on valinnainen. Sen poisjättäminen antaa Cassandra luo sellaisen automaattisesti, millä on merkitystä, kun indeksi on myöhemmin poistettava.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Pudota indeksi
Komento "Drop index" pudottaa määritetyn indeksin. Jos indeksin nimeä ei annettu indeksin luomisen aikana, indeksin nimi on TaulukonNimi_SarakkeenNimi_idx.
- Jos indeksiä ei ole, se palauttaa virheilmoituksen, ellei IF EXISTS -toimintoa käytetä, joka palauttaa no-op.
- Sinun on määritettävä avainavaruuden nimi indeksin nimen kanssa, muuten indeksiä etsitään nykyisestä avainavaruudesta.
Syntaksi
DROP INDEX IF EXISTS KeyspaceName.IndexName;
esimerkki
Tässä on tilannekuva suoritetusta komennosta "Drop index", joka pudottaa indeksin DeptIndexin.
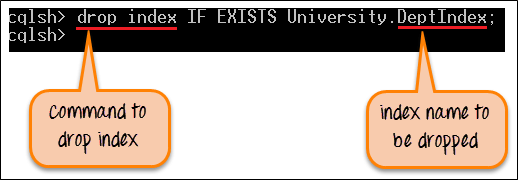
DROP INDEX IF EXISTS University.DeptIndex;
Onnistuneen komennon suorittamisen jälkeen DeptIndex pudotetaan näppäinavaruudesta. Nyt tietoja ei voi suodattaa sarakeosaston mukaan.
Vahvistaaksesi, mitkä indeksit ovat olemassa ennen pudottamistaping yksi, kuvaile taulukko ja lue tulosteen alareunassa olevat indeksimääritelmät.
DESCRIBE TABLE University.Student;
Indeksityypit Cassandra
Yllä oleva komento luo standardin mukaisen toissijaisen indeksin, mutta on olemassa kolme erillistä mekanismia, ja ne käyttäytyvät hyvin eri tavalla.
| Tyyppi | Kuinka se toimii | Parasta |
|---|---|---|
| Toissijainen indeksi | Jokainen solmu indeksoi vain omat paikalliset tietonsa, joten kyselyn, jossa ei ole osioavainta, on otettava yhteyttä jokaiseen solmuun. | Kohtalaisen kardinaalisuuden sarakkeita haetaan osioavaimen rinnalla. |
| SASI-indeksi | Liitetty indeksi, joka tukee LIKE-etuliitteiden ja -päätteiden täsmäytystä sekä numeerisia alueita. | Tekstihakumallit. Vielä kokeellinen, joten testaa ennen tuotantokäyttöä. |
| Tallennustilaan liitetty indeksi (SAI) | Esiteltiin sisään Cassandra 5.0, jakaen yhden indeksirakenteen sarakkeiden kesken pienemmällä kirjoituskululla. | Molempien edellä mainittujen moderni korvaaja Cassandra 5 klusteria. |
Kokoelmasarakkeen indeksoinnissa käytetään muokkaajaa, joka määrittää, mikä osa indeksoidaan.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES etsii joukon tai listan alkioista, KEYS etsii kartoitusavaimista ja ENTRIES yhdistää avain- ja arvoparin. Kokoelman indeksointia käsitellään tarkemmin seuraavassa. Cassandra kokoelmat opetusohjelma.
Milloin indeksiä ei pidä käyttää Cassandra
Toissijainen indeksi on kätevä, mutta se ei ole relaatioindeksi, ja sen käyttäminen väärässä paikassa on yleinen syy klusterien hitauteen. Neljä tilannetta vaatii erilaista lähestymistapaa.
- Erittäin korkea kardinaliteetti. Lähes yksilöllisen kohteen, kuten sähköpostiosoitteen, indeksointi tarkoittaa, että lähes jokaisessa osiossa on yksi vastaava rivi, joten kysely leviää koko klusteriin ja palauttaa yhden tietueen.
- Hyvin alhainen kardinaliteetti. Kaksiarvoisen lipun, kuten active tai inactive, indeksointi tuottaa valtavia indeksiosioita, ja yhden lukeminen palauttaa puolet taulukosta.
- Usein päivitettävät sarakkeet. Jokainen muutos kirjoittaa hakemistomerkinnän ja hautakiven vanhan tilalle, joten hautakivien kertyminen heikentää lukutehoa ajan myötä.
- Kyselyt ilman osioavainta. Ilman sitä koordinaattorin on otettava yhteyttä jokaiseen solmuun ja yhdistettävä tulokset, mikä ei skaalaudu solmujen lisäyksen myötä.
Kestävä vaihtoehto on toinen taulukko, jonka avain on haettavan sarakkeen mukaan ja joka kirjoitetaan samaan aikaan ensimmäisen kanssa. Tämä noudattaa kysely ensin -periaatetta, joka on kuvattu kohdassa Cassandra datamallin säännöt, ja se pitää jokaisen lukeman yhdessä osiossa yhdessä solmussa.
Toimivana sääntönä indeksi sopii kohtuullisen kardinaalisuudeltaan kohtuulliseen sarakkeeseen, jota kyselyssä käytetään yhdessä tunnetun osioavaimen kanssa. Kaikkeen tämän kuvauksen ulkopuoliseen sopii paremmin tarkoitukseen rakennettu taulukko.
