
GLM R-is: üldistatud lineaarne mudel ja logistiline regressioon
 Evelyn Clarke
⚡ Nutikas kokkuvõte
Üldistatud lineaarne mudel (GLM) R-is laiendab tavalist regressiooni tulemustele, mis on binaarsed, loenduspõhised või mitte-normaalsed. See läbivaatus loob täiskasvanute sissetulekute andmestikule logistilise GLM-i ja hindab seda täpsuse, korrektsuse, meeldejäävuse ja ROC-iga.
Mis on üldistatud lineaarne mudel (GLM) R-is?
A Üldistatud lineaarne mudel (GLM) laiendab tavalist lineaarset regressiooni, nii et vastusemuutuja võib järgida muud jaotust kui normaalne. R, paigaldate ühe sisseehitatud glm() funktsioon statistikapaketist.
Iga GLM-i defineerivad kolm komponenti:
- Juhuslik komponent: vastusemuutuja tõenäosusjaotus, mis on võetud eksponentsiaalsest perekonnast (binomiaalne, Poissoni, gamma, Gaussi ja teised).
- Süstemaatiline komponent: lineaarne ennustaja ehk teie selgitavate muutujate kaalutud kombinatsioon.
- Linkimise funktsioon: funktsioon, mis seob vastuse keskmise lineaarse ennustajaga, näiteks binaarandmete logitne seos või loenduste logaritmiline seos.
See struktuur muudab mudeli "üldistatud". Normaalselt jaotatud tulemuse sundimise asemel deklareeritakse õige jaotus läbi pere argument ja R hindab koefitsiente maksimaalse tõenäosuse abil. Logistiline regressioon on lihtsalt binoomperekonna ja logitilise seosega GLM, seega on see loomulik lähtepunkt.
Mis on logistiline regressioon R-is?
Logistilist regressiooni kasutatakse klassi, st tõenäosuse ennustamiseks. Logistiline regressioon võib binaarset tulemust täpselt ennustada.
Kujutage ette, et soovite paljude tunnuste põhjal ennustada, kas laen keeldutakse/võttakse vastu. Logistiline regressioon on kujul 0/1. y = 0, kui laen lükatakse tagasi, y = 1, kui laen võetakse vastu.
Logistiline regressioonimudel erineb lineaarsest regressioonimudelist kahel viisil.
- Esiteks aktsepteerib logistiline regressioon sõltuva muutujana ainult dihhotoomset (binaarset) sisendit (st vektorit 0 ja 1).
- Teiseks kaardistatakse tulemus tõenäosusliku seosefunktsiooni abil, mida nimetatakse sigmoidne (logistiline) funktsioon oma S-kuju tõttu:

Funktsiooni väljund on alati vahemikus 0 kuni 1. Kontrollige allolevat pilti
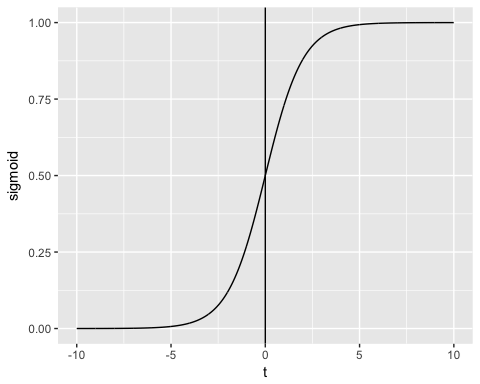
Sigmoidfunktsioon tagastab väärtused vahemikus 0 kuni 1. Klassifitseerimisülesande jaoks vajame diskreetset väljundit 0 või 1.
Pideva voolu teisendamiseks diskreetseks väärtuseks saame määrata otsuse piiriks 0.5. Kõik väärtused, mis ületavad seda läve, klassifitseeritakse kui 1

Nüüd, kui seosefunktsioon on selge, võrdle üldistatud mudelit juba tuttava tavalise lineaarse mudeliga.
GLM vs lineaarne regressioon: peamised erinevused R-is
Enne mis tahes koodi kirjutamist on kasulik täpselt teada, millal standard lineaarse regressiooni Funktsioon lm() ei ole enam sobiv ja selle asemele peaks tulema glm().
| Kriteeriumid | Lineaarne regressioon (lm) | Üldistatud lineaarne mudel (glm) |
|---|---|---|
| Vastuse muutuja | Pidev ja piiramatu | Binaarne, loendus-, proportsiooni- või positiivne pidev |
| Vea jaotus | Ainult tavaline | Iga eksponentsiaalse perekonna liige |
| Lingi funktsioon | Identiteet (kaudne) | Selgesõnaline: logit, log, inverse, probit |
| Hinnangumeetod | Harilikud vähimruudud | Maksimaalne tõenäosus (IRLS) |
| Dispersiooni eeldus | Konstantne kõigis vaatlustes | Lubatud keskmisest sõltuda |
| Sobivuse mõõt | R-ruut | AIC ja jääkhälve |
| R funktsioon | lm(valem, andmed) | glm(valem, andmed, perekond) |
Lühidalt, vali lm(), kui tulemus on normaaljaotusega mõõtmine, ja glm(), kui tulemus on jah/ei otsus – ülesanne, mille muidu saaksid anda spetsialist. otsustuspuu klassifikaator, sündmuste arv või rangelt positiivne suurus, mille levik kasvab koos oma keskmisega.
Kuidas luua üldistatud lineaarset mudelit (GLM) R-is
Kui teooria on paigas, rakendab ülejäänud õpetus binoom-GLM-i otsast lõpuni reaalsel andmestikul.
Kasutame täiskasvanud Andmekogum logistilise regressiooni illustreerimiseks. „Täiskasvanu” on klassifitseerimisülesande jaoks suurepärane andmekogum. Eesmärk on ennustada, kas üksikisiku aastane sissetulek USA dollarites ületab 50 000. Andmekogum sisaldab 48 842 vaatlust ja kümmet muutujat:
- vanus: isiku vanus. Numbriline
- haridus: indiviidi haridustase. tegur.
- perekonnaseis: Mariisiku staatus. Tegur, st mitte kunagi abielus, abielus-abikaasa, …
- sugu: indiviidi sugu. Tegur, st mees või naine
- sissetulek: Target muutuv. Sissetulek üle või alla 50 50. Tegur st >50K, <=XNUMXK
teiste seas
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
Väljund:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
Toimime järgmiselt:
- 1. samm: kontrollige pidevaid muutujaid
- 2. samm: kontrollige tegurimuutujaid
- 3. toiming: funktsioonide projekteerimine
- 4. samm: kokkuvõtlik statistika
- 5. samm: treening-/katsekomplekt
- 6. samm: looge mudel
- 7. samm: hinnake mudeli toimivust
- 8. samm: täiustage mudelit
Teie ülesanne on ennustada, kelle tulu on suurem kui 50 XNUMX.
Selles õpetuses kirjeldatakse üksikasjalikult kõiki samme, et viia läbi reaalse andmestiku analüüs.
1. samm) Kontrollige pidevaid muutujaid
Esimeses etapis näete pidevate muutujate jaotust.
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code Selgitus
- pidev <- select_if(data_adult, is.numeric): Kasutage dplyr teegi funktsiooni select_if(), et valida ainult arvulised veerud
- kokkuvõte (pidev): kokkuvõtliku statistika printimine
Väljund:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
Ülaltoodud tabelist näete, et andmetel on täiesti erinevad skaalad ja tundide kohta nädalas on suured kõrvalekalded (st vaadake viimast kvartiili ja maksimumväärtust).
Saate sellega toime tulla kahe sammuga:
- Joonista tundide nädalas jaotus
- Standardiseerige pidevad muutujad
- Joonistage jaotus
Vaatame lähemalt tundide.nädalas jaotust
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
Väljund:

Muutujal on palju kõrvalekaldeid ja mitte täpselt määratletud jaotus. Saate selle probleemi osaliselt lahendada, kustutades nädalas ülemised 0.01 protsenti tundidest.
Kvantiili põhisüntaks:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
Me arvutame iganädalase töötundide 99. protsentiili.
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code Selgitus
- quantile(data_adult$hours.per.week, .99): Arvutab nädalase tööaja 99. protsentiili
Väljund:
## 99%
##  80
99 protsenti elanikkonnast töötab alla 80 tunni nädalas.
Saate jätta vaatlused sellest künnisest kõrgemale. Kasutate filtrit alates dplyr raamatukogu.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
Väljund:
## [1] 45537 10
- Standardiseerige pidevad muutujad
Toimivuse parandamiseks saate iga veeru standardida, kuna teie andmete skaala ei ole sama. Saate kasutada dplyr teegi funktsiooni mute_if. Põhiline süntaks on:
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
Saate numbrilisi veerge standardida järgmiselt.
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code Selgitus
- mute_if(is.numeric, funs(scale)): tingimus on ainult numbriline veerg ja funktsioon on skaala
Väljund:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
2. samm) Kontrollige tegurimuutujaid
Sellel etapil on kaks eesmärki:
- Kontrollige taset igas kategooria veerus
- Määratlege uued tasemed
Jagame selle sammu kolmeks osaks:
- Valige kategoorilised veerud
- Salvestage iga veeru tulpdiagramm loendis
- Printige graafikud
Saame valida teguriveerud alloleva koodiga:
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code Selgitus
- data.frame(select_if(data_adult, is.factor)): salvestame teguriveerud faktorina andmekaadri tüübis. Teek ggplot2 nõuab andmeraami objekti.
Väljund:
## [1] 6
Andmekogum sisaldab 6 kategoorilist muutujat
Teine samm on nõudlikum. Sa tahad iga andmeraami teguri veeru jaoks tulpdiagrammi joonistada. Protsessi on mugavam automatiseerida, eriti olukorras, kus veerge on palju.
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code Selgitus
- lapply(): Kasutage funktsiooni lapply() funktsiooni edastamiseks kõigis andmestiku veergudes. Salvestate väljundi loendisse
- Funktsioon(x): funktsiooni töödeldakse iga x jaoks. Siin on x veerud
- ggplot(faktor, aes(get(x))) + geom_bar()+ theme(axis.text.x = element_text(angle = 90)): looge iga x-elemendi jaoks tulpdiagramm. Pange tähele, et x-i tagastamiseks veeruna peate selle lisama get()
Viimane samm on suhteliselt lihtne. Soovite printida 6 graafikut.
# Print the graph
graph
Väljund:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

Märkus. Järgmise graafiku juurde liikumiseks kasutage nuppu Järgmine

Samm 3) Funktsioonide projekteerimine
Kahel kategoorilisel muutujal on rohkem tasemeid, kui mudelil vaja on. Te rühmitate need laiematesse ja paremini asustatud kategooriatesse.
Haridus uuesti sõnastatud
Ülaltoodud graafikult näete, et muutuv haridus on 16 tasemega. See on märkimisväärne ja mõnel tasemel on vaatlusi suhteliselt vähe. Kui soovite parandada sellest muutujast saadava teabe hulka, saate selle ümber sõnastada kõrgemale tasemele. Nimelt loote suuremaid sarnase haridustasemega gruppe. Näiteks madal haridustase muudetakse väljalangevaks. Kõrgemad haridustasemed muudetakse meistriks.
Siin on detail:
| Vana tase | Uus tase |
|---|---|
| koolieelne | välja kukkuma |
| 10. | Välja kukkuma |
| 11. | Välja kukkuma |
| 12. | Välja kukkuma |
| 1.-4 | Välja kukkuma |
| 5th-6th | Välja kukkuma |
| 7th-8th | Välja kukkuma |
| 9. | Välja kukkuma |
| HS-Grad | HighGrad |
| Mingi kolledž | kogukond |
| Assoc-acdm | kogukond |
| Assoc-voc | kogukond |
| Bakalaureuseõpe | Bakalaureuseõpe |
| Masters | Masters |
| Professionaalkool | Masters |
| Doktorikraad | PhD |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code Selgitus
- Me kasutame dplyr raamatukogust verbi mute. Hariduse väärtushinnanguid muudame lausega ifelse
Allolevas tabelis loote kokkuvõtliku statistika, et näha, mitu aastat keskmiselt kulub haridusele (z-väärtus) bakalaureuse-, magistri- või doktorikraadini jõudmiseks.
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
Väljund:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
Uuesti sõnastamine Marital-staatus
Samuti on võimalik luua madalamaid perekonnaseisu tasemeid. Järgmises koodis muudate taset järgmiselt:
| Vana tase | Uus tase |
|---|---|
| Ei abiellunud kunagi | Ei ole abielus |
| Abielus-abikaasa-puudulik | Ei ole abielus |
| Abielus-AF-abikaasa | Abielus |
| Abielus-kodanik-abikaasa | |
| Lahutatud | Lahutatud |
| Lahutatud | |
| Lese | Lesk |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
Saate kontrollida iga rühma kuuluvate isikute arvu.
table(recast_data$marital.status)
Väljund:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
4. etapp) kokkuvõtlik statistika
On aeg vaadata statistikat meie sihtmuutujate kohta. Alloleval graafikul loendate nende inimeste protsenti, kes teenivad oma soo järgi üle 50 XNUMX.
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
Väljund:

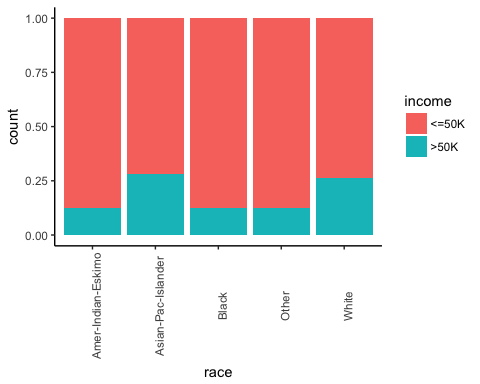
Järgmisena kontrollige, kas isiku päritolu mõjutab tema sissetulekuid.
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
Väljund:
Töötundide arv soo järgi.
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
Väljund:

Kastigraafik kinnitab, et tööaja jaotus sobib erinevatele rühmadele. Kastdiagrammil pole mõlemal sugupoolel homogeenseid vaatlusi.
Nädala tööaja tihedust saab kontrollida haridustüübi järgi. Jaotustel on palju erinevaid valikuid. Seda saab ilmselt seletada haridustüübiga.tract USA-s.
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code Selgitus
- ggplot(recast_data, aes(x= hours.per.week)): tihedusgraafik nõuab ainult ühte muutujat
- geom_density(aes(värv = haridus), alfa =0.5): geomeetriline objekt tiheduse juhtimiseks
Väljund:

Oma mõtete kinnitamiseks võite sooritada ühesuunalise ANOVA test:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
Väljund:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
ANOVA test kinnitab rühmade keskmise erinevust.
Mittelineaarsus
Enne mudeli käivitamist näete, kas töötundide arv on vanusega seotud.
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code Selgitus
- ggplot(recast_data, aes(x = vanus, y = tunnid.nädalas)): määrake graafiku esteetika
- geom_point(aes(värv=sissetulek), suurus =0.5): Koostage punktdiagramm
- stat_smooth(): lisage trendijoon järgmiste argumentidega:
- method='lm': joonistage sobitatud väärtus, kui lineaarse regressiooni
- valem = y~poly(x,2): sobitada polünoomi regressioon
- se = TRUE: lisage standardviga
- aes(värv= sissetulek): jagage mudel sissetulekute järgi
Väljund:

Lühidalt, saate testida mudelis interaktsioonitermineid, et tuvastada mittelineaarsuse efekt nädalase tööaja ja muude funktsioonide vahel. Oluline on tuvastada, millistel tingimustel tööaeg erineb.
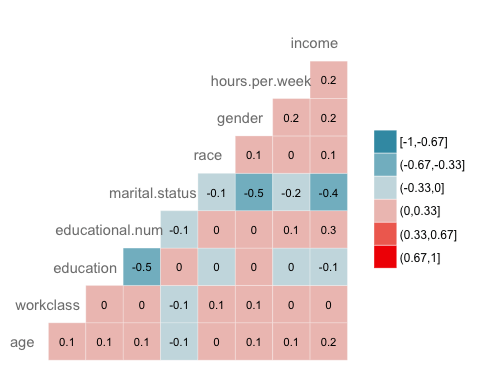
Korrelatsioon
Järgmine kontroll on muutujate vahelise korrelatsiooni visualiseerimine. Teisendate teguri taseme tüübi numbriliseks, et saaksite joonistada soojuskaardi, mis sisaldab Spearmani meetodiga arvutatud korrelatsioonikordajat.
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Selgitus
- data.frame(lapply(recast_data,as.integer)): teisenda andmed numbriteks
- ggcorr() joonistab soojuskaardi järgmiste argumentidega:
- meetod: korrelatsiooni arvutamise meetod
- nbreaks = 6: Katkeste arv
- hjust = 0.8: muutuja nime juhtpositsioon graafikul
- silt = TRUE: lisage sildid akende keskele
- label_size = 3: suurussildid
- värv = “grey50”): sildi värv
Väljund:
5. samm) Treeni/katsekomplekt
Igasugune järelevalve all masinõpe See ülesanne nõuab andmete jagamist rongikomplekti ja testkomplekti vahel. Rongi-/testkomplekti loomiseks võite kasutada teistes juhendatud õppematerjalides loodud „funktsiooni“.
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
Väljund:
## [1] 36429 9
dim(data_test)
Väljund:
## [1] 9108 9
6. samm) Ehitage mudel
Algoritmi toimivuse nägemiseks kasutate stats paketi funktsiooni glm(). Üldistatud lineaarne mudel on mudelite kogu. Põhiline süntaks on:
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
Olete valmis hindama logistilist mudelit, et jagada sissetuleku tase funktsioonide komplekti vahel.
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code Selgitus
- valem <- sissetulek ~ .: Looge sobiv mudel
- logit <- glm(valem, andmed = data_train, family = 'binomial'): sobitage logistiline mudel (pere = 'binomial') andmerongi andmetega.
- summary(logit): printige mudeli kokkuvõte
Väljund:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
Meie mudeli kokkuvõte paljastab huvitavat teavet. Logistilise regressiooni toimivust hinnatakse konkreetsete võtmemõõdikute abil.
- AIC (Akaike teabekriteeriumid): see on samaväärne R2 logistilises regressioonis. See mõõdab sobivust, kui parameetrite arvule määratakse karistus. Väiksem AIC väärtused näitavad, et mudel on tõele lähemal.
- Nullhälve: sobib mudeliga ainult lõikepunktiga. Vabadusaste on n-1. Saame tõlgendada seda kui hii-ruut väärtust (sobitatud väärtus, mis erineb tegeliku väärtuse hüpoteesi testimisest).
- Jääkhälve: mudel kõigi muutujatega. Seda tõlgendatakse ka kui hii-ruudu hüpoteesi testimist.
- Fisheri skoori iteratsioonide arv: iteratsioonide arv enne lähenemist.
Funktsiooni glm() väljund salvestatakse loendisse. Allolev kood näitab kõiki logiti muutujas saadaolevaid üksusi, mille koostasime logistilise regressiooni hindamiseks.
# Loend on väga pikk, printige ainult kolm esimest elementi
lapply(logit, class)[1:3]
Väljund:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
Iga väärtus võib olla nttracmärgiga $, millele järgneb mõõdikute nimi. Näiteks salvestasite mudeli nimega logit. NäitekstracAIC kriteeriumide täitmiseks kasutate:
logit$aic
Väljund:
## [1] 27086.65
7. samm) Hinnake mudeli jõudlust
Segadusmaatriks
. segaduse maatriks on parem valik klassifitseerimise toimivuse hindamiseks võrreldes varem nähtud erinevate mõõdikutega. Üldine mõte on lugeda kordade arv, mil tõesed eksemplarid on klassifitseeritud Väärteks.

Segadusmaatriksi arvutamiseks peab teil esmalt olema ennustuste kogum, et neid saaks võrrelda tegelike sihtmärkidega.
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code Selgitus
- ennusta(logit,andmete_test, tüüp = 'response'): arvutab ennustuse testikomplektis. Määrake vastuse tõenäosuse arvutamiseks tüüp = 'response'.
- tabel(andmed_test$sissetulek, ennustada > 0.5): arvutage segadusmaatriks. ennustada > 0.5 tähendab, et see tagastab 1, kui prognoositud tõenäosused on üle 0.5, muidu 0.
Väljund:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
Segadusmaatriksi iga rida tähistab tegelikku sihtmärki, iga veerg aga ennustatud sihtmärki. Selle maatriksi esimene rida käsitleb sissetulekut alla 50 000 (negatiivne klass): 6,310 vaatlust klassifitseeriti õigesti isikuteks, kelle sissetulek oli alla 50 000 (Tõeline negatiivne), samas kui 495 liigitati ekslikult üle 50 000 (Valepositiivne). Teises reas arvestatakse sissetulekut üle 50 000: 1,229 tuvastati õigesti (Tõeliselt positiivne), samas kui 1,074 jäi vahele (Valenegatiivne).
Saate arvutada mudeli täpsus tõelise positiivse + tõelise negatiivse summeerimisel kogu vaatluse kohta

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code Selgitus
- summa(diag(tabel_matt)): diagonaali summa
- summa(tabeli_matt): maatriksi summa.
Väljund:
## [1] 0.8277339
Mudelil näib olevat üks probleem: see annab liiga palju vale-negatiivseid tulemusi. Seda nimetatakse täpsustesti paradoksMe väitsime, et täpsus on õigete ennustuste ja juhtumite koguarvu suhe. Meil võib olla suhteliselt kõrge täpsus, aga mudel on kasutu. See juhtub siis, kui on domineeriv klass. Kui vaadata tagasi segadusmaatriksile, siis näete, et enamik juhtumeid on klassifitseeritud tõeliselt negatiivseteks. Kujutage nüüd ette, mudel klassifitseerib iga vaatluse negatiivseks (st alla 50 000). Te saaksite ikkagi umbes 75-protsendilise täpsuse (6,805 / 9,108). Teie mudel toimib paremini, aga tal on raskusi tõeliselt positiivse ja tõeliselt negatiivse eristamisega.
Sellises olukorras on parem kasutada kokkuvõtlikumat mõõdikut. Saame vaadata:
- Täpsus = TP/(TP+FP)
- Meenuta = TP/(TP+FN)
Täpsus vs meenutamine
Täpsus vaatleb positiivse ennustuse täpsust. Tagasikutsumine on klassifikaatori poolt õigesti tuvastatud positiivsete juhtumite suhe;
Nende kahe mõõdiku arvutamiseks saate koostada kaks funktsiooni
- Konstruktsiooni täpsus
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code Selgitus
- mat[1,1]: tagastab andmeraami esimese veeru esimese lahtri, st tõelise positiivse
- matt[1,2]; Tagastab andmeraami teise veeru esimese lahtri, st valepositiivse
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code Selgitus
- mat[1,1]: tagastab andmeraami esimese veeru esimese lahtri, st tõelise positiivse
- matt[2,1]; Tagastab andmeraami esimese veeru teise lahtri, st valenegatiivse
Saate oma funktsioone testida
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
Väljund:
## [1] 0.712877
## [2] 0.5336518
Lugege neid kahte numbrit hoolikalt. Täpsus on 0.71, seega kui mudel ütleb, et inimene teenib üle 50 000, on see õige 71 protsendil juhtudest. Meenutusmäär on 0.53, seega tuvastab mudel ainult 53 protsenti inimestest, kes tegelikult teenivad üle 50 000.
Saate luua  skoor täpsuse ja meeldetuletuse põhjal. The on nende kahe mõõdiku harmooniline keskmine, mis tähendab, et see annab suurema kaalu madalamatele väärtustele.

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
Väljund:
## [1] 0.6103799
Kompromiss täpsuse ja tagasikutsumisega
On võimatu saavutada nii suurt täpsust kui ka suurt meeldejäämist.
Kui me suurendame täpsust, ennustatakse õiget isikut paremini, kuid me jätaksime paljud neist kahe silma vahele (väiksem meeldetuletus). Mõnes olukorras eelistame suuremat täpsust kui tagasikutsumist. Täpsuse ja meenutamise vahel on nõgus seos.
- Kujutage ette, peate ennustama, kas patsiendil on haigus. Tahad olla võimalikult täpne.
- Kui teil on vaja näotuvastuse abil tuvastada tänaval potentsiaalseid petturid, oleks parem tabada palju petturiteks märgitud inimesi, kuigi täpsus on madal. Politseil on võimalik mittepetturlik isik vabastada.
ROC kõver
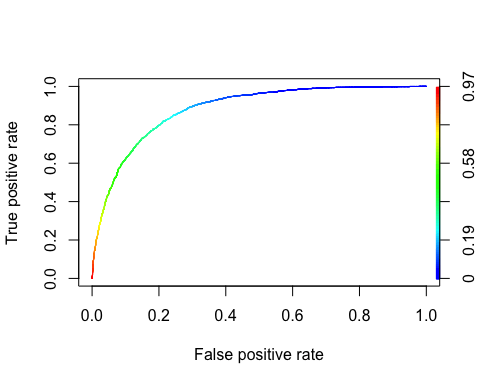
. Vastuvõtja Operating Iseloomulik kõver on teine levinud tööriist, mida kasutatakse binaarse klassifikatsiooni korral. See on väga sarnane täpsuse/tagasikutsumise kõveraga, kuid täpsuse ja meeldetuletamise kõvera asemel näitab ROC kõver tõelist positiivset määra (st tagasikutsumist) valepositiivse määra suhtes. Valepositiivsuse määr on negatiivsete juhtumite suhe, mis on valesti positiivseteks liigitatud. See on võrdne ühega, millest on lahutatud tegelik negatiivne määr. Nimetatakse ka tõeliseks negatiivseks määraks spetsiifilisus. Siit ka ROC kõvera joonised tundlikkus (meenutamine) versus 1-spetsiifilisus
ROC-kõvera joonistamiseks peame installima paketi nimega ROCR. Selle leiame kondast raamatukogu. Saate sisestada koodi:
conda install -c r r-rocr --yes
ROC-i saame joonistada funktsioonide ennustus () ja performance () abil.
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code Selgitus
- ennustus(prognoos, data_test$income): ROCR-i teek peab sisendandmete teisendamiseks looma ennustusobjekti
- performance (ROCRpred, 'tpr', 'fpr'): tagastab kaks kombinatsiooni graafikus loomiseks. Siin konstrueeritakse tpr ja fpr. Joonistage graafiku täpsus ja meeldetuletus koos, kasutage "pre", "rec".
Väljund:
8. samm) Täiustage mudelit
Võite proovida lisada mudelile mittelineaarsust interaktsiooniga
- vanus ja tunnid.nädalas
- sugu ja tunnid.nädalas.
Seejärel võrdlete mõlema mudeli F1 skoori.
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
Väljund:
## [1] 0.6109181
F1 tulemus on eelmisest veidi kõrgem. Võid andmete kallal edasi töötada ja proovida tulemust ületada.
Kuidas tõlgendada GLM-i koefitsiente ja koefitsientide suhteid R-is
6. etapis prinditud kokkuvõtlik tabel annab koefitsiendid log-odds skaala, mida on mitte-tehnilisele publikule raske selgitada. Nende teisendamine koefitsientideks muudab mudeli edastamise palju lihtsamaks.
Järgige neid nelja sammu.
- Astmesta koefitsiendid. Rakenda exp() igale hinnangule, nii et log-oddsidest saaksid multiplikatiivsed koefitsiendid.
- Lisa usaldusvahemik. Mähi confint() funktsiooni exp() funktsiooni, et saada 95-protsendiline intervall samal koefitsiendi skaalal.
- Võrdle iga väärtust 1-ga. Koefitsient üle 1 suurendab positiivse klassi tõenäosust, väärtus alla 1 vähendab seda ja väärtus, mis on lähedane 1-le, tähendab, et ennustaja lisab vähe.
- Kontrollige statistilist olulisust. Tõlgenda ainult neid ennustajaid, mille p-väärtus kokkuvõtte väljundis on alla teie valitud läve, tavaliselt 0.05.
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
Väljundi lugemine. Meie mudeli tundide nädalas koefitsient on 0.41942. Selle astmestamine annab exp(0.41942) = 1.52, mis tähendab, et ühe standardhälbe võrra suurem iganädalane töötundide arv korrutab üle 50 000 tunni teenimise tõenäosuse umbes 1.5-ga, hoides kõiki teisi muutujaid konstantsena.
Negatiivsed koefitsiendid toimivad samamoodi. abielustatusNot_married on -2.50346, seega exp(-2.50346) = 0.08: vallalistel inimestel on umbes 8 protsenti abielus inimese tõenäosusest. Kuna pidevad ennustajad standardiseeriti 1. etapis, kirjeldage muutusi standardhälbe ühikutes, mitte toortundides.
Märkus teistele peredele: Eksponentseeritud koefitsiendid on koefitsiendid ainult binoomperekonna puhul, millel on logitne seos. Kui perekond = „poisson“ ja seos on logaritmiline, loetakse samad exp() väärtused hoopis määrade suhtarvudena.
GLM R-is: funktsioonide kiirjuhend
Hoia seda tabelit programmeerimise ajal enda kõrval. See loetleb kõik ülaltoodud kaheksas etapis kasutatud funktsioonid koos neid pakkuva paketiga ja oodatavate argumentidega.
| Pakend | Eesmärk | funktsioon | Argument |
|---|---|---|---|
| - | Loo rongi-/katseandmekogum | create_train_set() | andmed, suurus, rong |
| glm | Treenige üldistatud lineaarset mudelit | glm() | valem, andmed, perekond* |
| glm | Tehke mudelist kokkuvõte | kokkuvõte() | varustatud mudel |
| baas | Tehke ennustus | ennustama () | sobitatud mudel, andmestik, tüüp = 'vastus' |
| baas | Looge segaduse maatriks | tabel () | y, ennusta() |
| baas | Looge täpsusskoor | summa(diag(tabel())/summa(tabel() | |
| ROCR | Loo ROC: 1. samm Loo ennustus | ennustus () | ennustama(), y |
| ROCR | Looge ROC: 2. samm Loo jõudlus | jõudlus () | ennustus (), 'tpr', 'fpr' |
| ROCR | Looge ROC: 3. samm Joonistage graafik | süžee() | jõudlus () |
Teine GLM Perekonnaargumendi kaudu kättesaadavad pered on:
- binoomne: (link = “logit”)
- gaussi: (link = „identiteet”)
- Gamma: (link = „pöördvõrdeline“)
- inverse.gaussian: (link = “1/mu^2”)
- poisson: (link = „log”)
- kvaasi: (seos = „identsus“, dispersioon = „konstant“)
- kvaasibinomiaalne: (link = “logit”)
- kvaasipoisson: (link = „log”)
