
Incrustaciones de palabras y Word2Vec con ejemplo
 Equipo editorial
⚡ Resumen inteligente
Word Embedding y Word2Vec convierten texto en vectores numéricos densos para que los modelos de aprendizaje automático reconozcan palabras con significado similar. Este recurso explica la técnica, sus arquitecturas CBOW y Skip-Gram, las funciones de activación y una implementación completa en Gensim para aplicaciones reales.
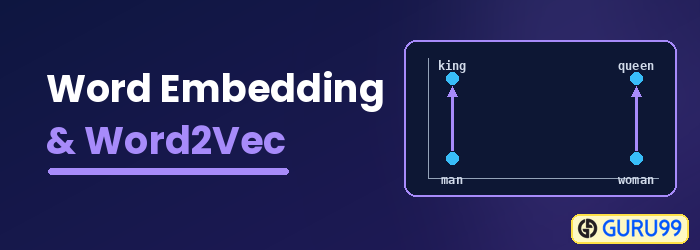
¿Qué es la incrustación de Word?
Incrustación de palabras es un tipo de representación de palabras que permite a los algoritmos de aprendizaje automático comprender palabras con significados similares. Es una técnica de modelado de lenguaje y aprendizaje de características para mapear palabras en vectores de números reales utilizando redes neuronales, modelos probabilísticos o reducción de dimensionalidad en la matriz de coocurrencia de palabras. Algunos modelos de incrustación de palabras son Word2vec (Google), GloVe (Stanford) y fastText (Facebook).
La incrustación de palabras también se denomina modelo semántico distribuido, modelo representado distribuido, espacio vectorial semántico o modelo de espacio vectorial. Al leer estos nombres, se encuentra con la palabra semánticoEsto significa agrupar palabras similares. Por ejemplo, frutas como manzana, mango y plátano deberían agruparse, mientras que los libros se ubicarían lejos de ellas. En un sentido más amplio, la incrustación de palabras creará un vector de frutas que se ubicará lejos de la representación vectorial de los libros.
¿Dónde se utiliza la incrustación de Word?
La incrustación de palabras ayuda en la generación de características, la agrupación de documentos, la clasificación de texto y las tareas de procesamiento del lenguaje natural. Enumeremos estas aplicaciones y analicemos cada una.
- Calcular palabras similares: La representación vectorial de palabras se utiliza para sugerir palabras similares a la palabra que se está analizando con el modelo de predicción. Además, también sugiere palabras diferentes, así como las palabras más comunes.
- Crea un grupo de palabras relacionadas: Se utiliza para grupos semánticosping, que agrupa cosas con características similares y aleja los elementos diferentes.
- Característica para la clasificación de texto: El texto se transforma en matrices de vectores que se introducen en el modelo para su entrenamiento y predicción. Los modelos clasificadores basados en texto no pueden entrenarse con cadenas de caracteres, por lo que este proceso convierte el texto a un formato que la máquina puede entrenar. Sus características de construcción semántica facilitan aún más la clasificación basada en texto.
- Agrupación de documentos: Esta es otra aplicación donde Word Embedding y Word2vec se utilizan ampliamente.
- Procesamiento natural del lenguaje: Hay muchas aplicaciones donde la incrustación de palabras es útil y supera a las características.tracfases de análisis, como el etiquetado de partes de la oración, el análisis de sentimientos y el análisis sintáctico.
Ahora que ya entiendes dónde se aplica la incrustación de palabras, veamos el modelo más popular que se utiliza para crear estas incrustaciones.
¿Qué es Word2vec?
palabra2vec Es una técnica o modelo que genera incrustaciones de palabras para una mejor representación de las mismas. Es un método de procesamiento del lenguaje natural que captura un gran número de relaciones sintácticas y semánticas precisas entre palabras. Se trata de una red neuronal de dos capas, poco profunda, que puede detectar sinónimos y sugerir palabras adicionales para oraciones incompletas una vez entrenada.
Antes de continuar, vea la diferencia entre una red neuronal superficial y una profunda, como se muestra en el siguiente diagrama de ejemplo de incrustación de palabras:
Una red neuronal superficial consta de una sola capa oculta entre la entrada y la salida, mientras que una red neuronal profunda contiene múltiples capas ocultas entre la entrada y la salida. La entrada se procesa mediante nodos, mientras que la capa oculta, al igual que la capa de salida, contiene neuronas.
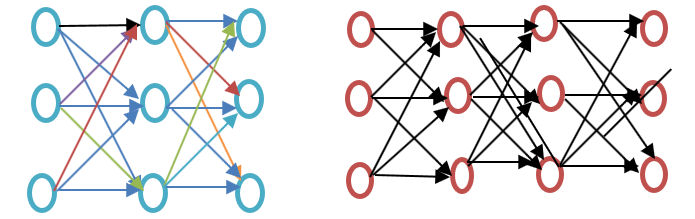
Word2vec es una red de dos capas, compuesta por una capa de entrada, una capa oculta y una capa de salida.
Word2vec fue desarrollado por un grupo de investigadores encabezado por Tomas Mikolov en GoogleWord2vec es mejor y más eficiente que el modelo de análisis semántico latente.
¿Por qué Word2vec?
Word2vec representa las palabras en un espacio vectorial. Las palabras se representan como vectores, y su ubicación se realiza de forma que las palabras con significados similares aparezcan juntas y las palabras con significados diferentes se encuentren alejadas. Esto también se denomina relación semántica. Las redes neuronales no entienden texto; solo entienden números. La incrustación de palabras (Word Embedding) proporciona una forma de convertir texto en un vector numérico.
Word2vec reconstruye el contexto lingüístico de las palabras. Antes de continuar, entendamos qué es el contexto lingüístico. En general, cuando hablamos o escribimos para comunicarnos, otras personas intentan comprender el objetivo de la oración. Por ejemplo, "¿Cuál es la temperatura de la India?". En este caso, el contexto es que el usuario quiere saber la temperatura de la India. En resumen, el objetivo principal de una oración es el contexto. Las palabras o frases que rodean el lenguaje hablado o escrito ayudan a determinar el significado del contexto. Word2vec aprende la representación vectorial de las palabras a través de estos contextos.
¿Qué hace Word2vec?
Antes de incrustar Word
Es importante conocer el enfoque utilizado antes de la incrustación de palabras y sus desventajas. A continuación, veremos cómo se superan dichas desventajas mediante la incrustación de palabras con el enfoque Word2vec. Finalmente, explicaremos cómo funciona Word2vec, ya que es fundamental comprender su funcionamiento.
Enfoque para el análisis semántico latente
Este es el método que se utilizaba antes de las incrustaciones de palabras. Emplea el concepto de bolsa de palabras, donde las palabras se representan mediante vectores codificados. Se trata de una representación vectorial dispersa cuya dimensión es igual al tamaño del vocabulario. Si la palabra aparece en el diccionario, se contabiliza; de lo contrario, no. Para obtener más información, consulte el programa a continuación.
Ejemplo de Word2vec

from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer()
data_corpus = ["guru99 is the best site for online tutorials. I love to visit guru99."]
vocabulary = vectorizer.fit(data_corpus)
X = vectorizer.transform(data_corpus)

print(X.toarray())
print(vectorizer.get_feature_names_out())
Salida:
[[1 2 1 1 1 1 1 1 1 1]]
[u'best', u'guru99', u'is', u'love', u'online', u'sitefor', u'the', u'to', u'tutorials', u'visit']
Code Explicación
- CountVectorizer es el módulo que se utiliza para almacenar el vocabulario en función de las palabras que contiene. Se importa desde sklearn.
- Crea el objeto usando la clase CountVectorizer.
- Escriba en la lista los datos que se van a ajustar en el CountVectorizer.
- Los datos se ajustan al objeto creado a partir de la clase CountVectorizer.
- Aplique un enfoque de bolsa de palabras para contar las palabras en los datos utilizando el vocabulario. Si una palabra o token no está disponible en el vocabulario, su posición de índice se establece en cero.
- La variable de la línea 5, que es x, se convierte en una matriz (un método disponible para x). Esto proporciona el recuento de cada token en la oración o lista proporcionada en la línea 3.
- Esto muestra las características que forman parte del vocabulario cuando se ajusta utilizando los datos de la línea 4.
En el enfoque de semántica latente, la fila representa palabras únicas, mientras que la columna representa la cantidad de veces que esa palabra aparece en el documento. Se trata de una representación de palabras en forma de matriz de documento. La frecuencia de término-frecuencia inversa de documento (TF-IDF) se utiliza para contar la frecuencia de las palabras en el documento, que es la frecuencia del término en el documento dividida por la frecuencia del término en todo el corpus.
Defecto del método Bolsa de palabras
- Ignora el orden de la palabra; por ejemplo, esto es malo = Esto es malo.
- Ignora el contexto de las palabras. Supongamos que escribimos la oración «Le encantaban los libros. La mejor educación se encuentra en los libros». Esto crearía dos vectores: uno para «Le encantaban los libros» y otro para «La mejor educación se encuentra en los libros». Los trataría como ortogonales, lo que los haría independientes, pero en realidad están relacionados entre sí.
Para superar estas limitaciones, se desarrolló la técnica de incrustación de palabras, y Word2vec es uno de los métodos utilizados para implementarla.
¿Cómo funciona Word2vec?
Word2vec aprende una palabra prediciendo su contexto circundante. Por ejemplo, tomemos la palabra "Él" ama. Fútbol americano."
Queremos calcular el Word2vec para la palabra: ama..
Supongamos:
loves = Vin. P(Vout / Vin) is calculated
where,
Vin is the input word.
P is the probability of likelihood.
Vout is the output word.
La palabra ama. El algoritmo recorre cada palabra del corpus. Se codifican tanto las relaciones sintácticas como semánticas entre las palabras. Esto facilita la búsqueda de palabras similares y análogas.
Todas las características aleatorias de la palabra. ama. se calculan. Estas características se modifican o actualizan con respecto a las palabras vecinas o de contexto con la ayuda de un Propagación hacia atrás método.
Otra forma de aprendizaje es que si los contextos de dos palabras son similares, o si dos palabras tienen características similares, entonces esas palabras están relacionadas.
palabra2vec Architectura
Word2vec utiliza dos arquitecturas:
- Bolsa continua de palabras (CBOW)
- Saltar gramo
Antes de continuar, analicemos la importancia de estas arquitecturas o modelos desde la perspectiva de la representación de palabras. El aprendizaje de la representación de palabras es esencialmente no supervisado, pero se necesitan etiquetas para entrenar el modelo. Skip-gram y CBOW transforman la representación no supervisada en una representación supervisada para el entrenamiento del modelo.
En CBOW, la palabra actual se predice utilizando la ventana de ventanas de contexto circundantes. Por ejemplo, si wi-1, Wi-2, Wi + 1, Wi + 2 se les dan palabras o contexto, este modelo proporcionará wi.
Skip-Gram realiza lo opuesto a CBOW, lo que implica que predice la secuencia o el contexto dado a partir de la palabra. Puedes invertir el ejemplo para entenderlo. Si wi Se da, esto predecirá el contexto, o wi-1, Wi-2, Wi + 1, Wi + 2.
Word2vec ofrece la opción de elegir entre CBOW (Continuous Bag of Words) y skip-gram. Estos parámetros se proporcionan durante el entrenamiento del modelo. Se puede optar por utilizar muestreo negativo o una capa softmax jerárquica.
Bolsa continua de palabras
Dibujemos un diagrama de ejemplo sencillo de Word2vec para comprender la arquitectura continua de bolsa de palabras.

Calculemos las ecuaciones matemáticamente. Supongamos que V es el tamaño del vocabulario y N es el tamaño de la capa oculta. La entrada se define como {xi-1, Xi-2, Xi + 1, Xi + 2 }. Obtenemos la matriz de pesos multiplicando V * N. Otra matriz se obtiene multiplicando el vector de entrada por la matriz de pesos. Esto también se puede entender mediante la siguiente ecuación.
h = xitW
donde xit y W son el vector de entrada y la matriz de pesos, respectivamente.
Para calcular la coincidencia entre el contexto y la siguiente palabra, consulte la siguiente ecuación.
u = representación predicha * h
donde la representación predicha se obtiene del modelo en la ecuación anterior.
Modelo de salto de gramo
El método Skip-Gram se utiliza para predecir una oración a partir de una palabra de entrada. Para comprenderlo mejor, veamos el diagrama que aparece en el siguiente ejemplo de Word2vec.

Se puede considerar como el inverso del modelo de bolsa de palabras continua, donde la entrada es la palabra y el modelo proporciona el contexto o la secuencia. También podemos concluir que la palabra objetivo se introduce en la entrada, y la capa de salida se replica varias veces para dar cabida al número de palabras de contexto elegido. El vector de error de todas las capas de salida se suma para ajustar los pesos mediante un método de retropropagación.
¿Qué modelo elegir?
CBOW es varias veces más rápido que skip-gram y proporciona una mejor frecuencia para las palabras frecuentes, mientras que skip-gram requiere una pequeña cantidad de datos de entrenamiento y representa incluso palabras o frases poco comunes. La siguiente tabla compara ambas arquitecturas de un vistazo.
| Aspecto | CBOW | Saltar-Gramo |
|---|---|---|
| Predicción | Predice la palabra objetivo a partir del contexto. | Predice el contexto a partir de la palabra objetivo. |
| Velocidad de entrenamiento | Más rápido | Más lento |
| Palabras frecuentes | Mayor precisión | Menor precisión |
| Palabras raras | Representación más débil | Mayor representación |
| Datos de entrenamiento | Necesita más datos | Funciona con menos datos |
La relación entre Word2vec y NLTK
NLTK es lo natural Language ToolKit. Se utiliza para el preprocesamiento de texto. Permite realizar diversas operaciones como el etiquetado de partes de la oración, la lematización, la derivación, la eliminación de palabras vacías y la eliminación de palabras poco frecuentes o de uso escaso. Ayuda a limpiar el texto y a extraer características de las palabras más relevantes. Por otro lado, Word2vec se utiliza para la coincidencia semántica (relaciona elementos cercanos) y sintáctica (secuencia). Con Word2vec, se pueden encontrar palabras similares y diferentes, realizar reducciones dimensionales y mucho más. Otra característica importante de Word2vec es la conversión de la representación de texto de alta dimensión en vectores de baja dimensión.
¿Dónde utilizar NLTK y Word2vec?
Si se necesitan realizar tareas de propósito general como las mencionadas anteriormente, como la tokenización, el etiquetado POS y el análisis sintáctico, se debe optar por NLTK, mientras que para predecir palabras según algún contexto, modelado de temas o similitud de documentos, se debe usar Word2vec.
Relación de NLTK y Word2vec con ayuda de código
NLTK y Word2vec se pueden usar juntos para encontrar representaciones de palabras similares o coincidencias sintácticas. El kit de herramientas de NLTK permite cargar muchos paquetes incluidos, y se puede crear un modelo con Word2vec. Posteriormente, se puede probar con palabras reales. Veamos la combinación de ambos en el siguiente código. Antes de continuar, consulte los corpus que proporciona NLTK. Puede descargarlos con el siguiente comando:
nltk(nltk.download('all'))

Consulte la captura de pantalla del código.
import nltk
import gensim
from nltk.corpus import abc

model = gensim.models.Word2Vec(abc.sents())
X = list(model.wv.vocab)
data = model.most_similar('science')
print(data)

Salida:
[('law', 0.9415997266769409), ('practice', 0.9276568293571472), ('discussion', 0.9259148836135864), ('agriculture', 0.9257254004478455), ('media', 0.9232194423675537), ('policy', 0.922248125076294), ('general', 0.9166069030761719), ('undertaking', 0.916458249092102), ('tight', 0.9129181504249573), ('board', 0.9107444286346436)]
Explicación de Code
- Se importa la biblioteca nltk, desde donde se puede descargar el corpus abc que utilizaremos en el siguiente paso.
- Gensim se ha importado. Si Gensim Word2vec no está instalado, instálelo con el comando “pip3 install gensim”. Consulte la captura de pantalla a continuación.

- Importa el corpus abc, que se ha descargado usando nltk.download('abc').
- Pasa los archivos al modelo Word2vec, que se importa usando Gensim, como oraciones.
- El vocabulario se almacena en forma de variable.
- El modelo se prueba con la palabra de muestra. ciencia, ya que estos archivos están relacionados con la ciencia.
- Aquí, el modelo predice la palabra similar "ciencia".
Activadores y Word2Vec
La función de activación de una neurona define su respuesta ante una serie de estímulos. Se inspira biológicamente en la actividad cerebral, donde diferentes neuronas se activan con distintos estímulos. Veamos la función de activación a través del siguiente diagrama.

Aquí, x1, x2, … x4 son los nodos de la red neuronal.
w1, w2, w3 son los pesos de los nodos.
La suma (Σ) de todos los pesos y valores de los nodos funciona como la función de activación.
¿Por qué la función de activación?
Si no se utiliza ninguna función de activación, la salida sería lineal, pero la funcionalidad de una función lineal es limitada. Para lograr una funcionalidad compleja como la detección de objetos, la clasificación de imágenes, etc.ping Para la generación de texto mediante voz y muchas otras salidas no lineales, se necesita una función de activación.
Cómo se calcula la capa de activación en la incrustación de palabras (Word2vec)
La capa Softmax (función exponencial normalizada) es la función de la capa de salida que activa o dispara cada nodo. Otro enfoque utilizado es Softmax jerárquico, donde la complejidad se calcula mediante O(log2En softmax, la complejidad es O(V), mientras que en softmax es O(V), donde V es el tamaño del vocabulario. La diferencia radica en la reducción de la complejidad en la capa softmax jerárquica. Para comprender su funcionamiento, consulte el siguiente ejemplo de incrustación de palabras:

Supongamos que queremos calcular la probabilidad de observar la palabra amor dado un contexto determinado. El flujo desde la raíz hasta el nodo hoja se moverá primero al nodo 2 y luego al nodo 5. Entonces, si tenemos un tamaño de vocabulario de 8, solo se necesitan tres cálculos. Esto permite descomponer el cálculo de la probabilidad de una palabra (amor).
¿Qué otras opciones están disponibles además de Softmax jerárquico?
En términos generales, las opciones de incrustación de palabras disponibles son Softmax diferenciado, CNN-Softmax, muestreo de importancia, muestreo de importancia adaptativo, estimación contrastiva de ruido, muestreo negativo, autonormalización y normalización infrecuente.
Hablando específicamente de Word2vec, disponemos de muestreo negativo.
El muestreo negativo es una forma de muestrear los datos de entrenamiento. Es similar al descenso de gradiente estocástico, pero con algunas diferencias. El muestreo negativo busca únicamente ejemplos de entrenamiento negativos. Se basa en la estimación contrastiva del ruido y muestrea aleatoriamente palabras que no están en el contexto. Es un método de entrenamiento rápido y elige el contexto al azar. Si la palabra predicha aparece en el contexto elegido aleatoriamente, ambos vectores están cerca uno del otro.
¿Qué conclusión se puede sacar?
Los activadores estimulan las neuronas de la misma manera que lo hacen ante estímulos externos. La capa Softmax es una de las funciones de la capa de salida que activa las neuronas en el caso de las incrustaciones de palabras. En Word2vec, disponemos de opciones como Softmax jerárquico y muestreo negativo. Mediante los activadores, se puede convertir una función lineal en una no lineal, y se puede implementar un algoritmo complejo de aprendizaje automático utilizando dichas funciones.
¿Qué es Gensim?
Gensim es un conjunto de herramientas de código abierto para modelado de temas y procesamiento de lenguaje natural que se implementa en Python y Cython. El conjunto de herramientas Gensim permite a los usuarios importar Word2vec para el modelado de temas y descubrir estructuras ocultas en el texto. Gensim ofrece no solo una implementación de Word2vec, sino también de Doc2vec y FastText.
Esta sección se centra en Word2vec, así que nos ceñiremos al tema actual.
Cómo implementar Word2vec usando Gensim
Hasta ahora, hemos hablado de qué es Word2vec, sus diferentes arquitecturas, por qué se está produciendo un cambio de una bolsa de palabras a Word2vec, la relación entre Word2vec y NLTK con código en vivo y las funciones de activación.
A continuación se describe el método paso a paso para implementar Word2vec usando Gensim:
Paso 1) Recopilación de datos
El primer paso para implementar cualquier modelo de aprendizaje automático o procesamiento del lenguaje natural es la recopilación de datos.
Observe los datos para crear un chatbot inteligente como se muestra en el siguiente ejemplo de Gensim Word2vec.
[{"tag": "welcome",
"patterns": ["Hi", "How are you", "Is any one to talk?", "Hello", "hi are you available"],
"responses": ["Hello, thanks for contacting us", "Good to see you here", "Hi there, how may I assist you?"]
        },
{"tag": "goodbye",
"patterns": ["Bye", "See you later", "Goodbye", "I will come back soon"],
"responses": ["See you later, thanks for visiting", "have a great day ahead", "Wish you Come back again soon."]
        },
{"tag": "thankful",
"patterns": ["Thanks for helping me", "Thank your guidance", "That's helpful and kind from you"],
"responses": ["Happy to help!", "Any time!", "My pleasure", "It is my duty to help you"]
        },
        {"tag": "hoursopening",
"patterns": ["What hours are you open?", "Tell your opening time?", "When are you open?", "Just your timing please"],
"responses": ["We're open every day 8am-7pm", "Our office hours are 8am-7pm every day", "We open office at 8 am and close at 7 pm"]
        },
{"tag": "payments",
"patterns": ["Can I pay using credit card?", "Can I pay using Mastercard?", "Can I pay using cash only?"],
"responses": ["We accept VISA, Mastercard and credit card", "We accept credit card, debit cards and cash. Please don't worry"]
        }
   ]
Esto es lo que entendemos de los datos:
- Estos datos contienen tres elementos: etiqueta, patrón y respuestas. La etiqueta representa la intención (cuál es el tema de discusión).
- Los datos están en formato JSON.
- Un patrón es una pregunta que los usuarios le harán al bot.
- Las respuestas son las soluciones que el chatbot proporcionará a la pregunta o patrón correspondiente.
Paso 2) Preprocesamiento de datos
Es muy importante procesar los datos sin procesar. Si se introducen datos limpios en la máquina, el modelo responderá con mayor precisión y aprenderá los datos de manera más eficiente.
Este paso implica eliminar palabras vacías, aplicar la lematización, eliminar palabras innecesarias, etc. Antes de continuar, es importante cargar los datos y convertirlos en un marco de datos. Consulte el código a continuación para obtener más información.
import json
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
Explicación de Code:
- Como los datos están en formato JSON, se importa JSON.
- El archivo se almacena en la variable.
- El archivo se abre y se carga en la variable de datos.
Ahora que los datos se han importado, es momento de convertirlos en un marco de datos. Consulte el código a continuación para ver el siguiente paso.
import pandas as pd
df = pd.DataFrame(data)
df['patterns'] = df['patterns'].apply(', '.join)
Explicación de Code:
1. Los datos se convierten en un marco de datos utilizando pandas, que se importó anteriormente.
2. Convierte la lista de patrones de columna en una cadena de texto.
from nltk.corpus import stopwords
from textblob import Word
stop = stopwords.words('english')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
Code Explicación:
1. Las palabras vacías en inglés se importan utilizando el módulo stop-word del kit de herramientas nltk.
2. Todas las palabras del texto se convierten a minúsculas usando una condición for y una función lambda. función lambda Es una función anónima.
3. Se comprueba si hay signos de puntuación en todas las filas del texto del marco de datos, y estas se filtran.
4. Los caracteres como números o puntos se eliminan mediante una expresión regular.
5. DigiLos ts se eliminan del texto.
6. En esta etapa se eliminan las palabras vacías.
7. Ahora se filtran las palabras y se eliminan las variantes de una misma palabra mediante lematización. Con esto, hemos finalizado el preprocesamiento de los datos.
Salida:
, patterns, responses, tag
0,hi one talk hello hi available,"['Hello, thanks for contacting us', 'Good to see you here', ' Hi there, how may I assist you?']",welcome
1,bye see later goodbye come back soon,"['See you later, thanks for visiting', 'have a great day ahead', 'Wish you Come back again soon.']",goodbye
2,thanks helping thank guidance thats helpful kind,"['Happy to help!', 'Any time!', 'My pleasure', 'It is my duty to help you']",thankful
3,hour open tell opening time open timing please,"[""We're open every day 8am-7pm"", 'Our office hours are 8am-7pm every day', 'We open office at 8 am and close at 7 pm']",hoursopening
4,pay using credit card pay using mastercard pay using cash,"['We accept VISA, Mastercard and credit card', 'We accept credit card, debit cards and cash. Please dont worry']",payments
Paso 3) Construcción de redes neuronales usando Word2vec
Ahora es el momento de crear un modelo utilizando el módulo Word2vec de Gensim. Debemos importar Word2vec desde Gensim. Hagámoslo, luego lo construiremos y, en la etapa final, comprobaremos el modelo con datos en tiempo real.
from gensim.models import Word2Vec
Ahora podemos construir el modelo con éxito usando Word2Vec. Consulte la siguiente línea de código para aprender cómo crear el modelo con Word2Vec. El texto se proporciona al modelo en forma de lista, por lo que convertiremos el texto del marco de datos a una lista usando el siguiente código.
Bigger_list = []
for i in df['patterns']:
     li = list(i.split(""))
     Bigger_list.append(li)
Model = Word2Vec(Bigger_list, min_count=1, size=300, workers=4)
Explicación de Code:
1. Se creó la lista más grande donde se agrega la lista interna. Este es el formato que se le pasa al modelo Word2Vec.
2. Se implementa un bucle y se itera sobre cada entrada de la columna de patrones del marco de datos.
3. Cada elemento de los patrones de columna se divide y se almacena en la lista interna li.
4. La lista interna se añade a la lista externa.
5. Esta lista se proporciona al modelo Word2Vec. Analicemos algunos de los parámetros que se incluyen aquí.
Recuento_mínimo: Ignora todas las palabras con una frecuencia total inferior a esta.
Tamaño: Indica la dimensionalidad de los vectores de palabras.
Trabajadores: Estos son los hilos para entrenar el modelo.
También existen otras opciones disponibles, y algunas de las más importantes se explican a continuación.
Ventana: Distancia máxima entre la palabra actual y la prevista dentro de una oración.
Sg: Se trata de un algoritmo de entrenamiento: 1 para skip-gram y 0 para bolsa de palabras continua. Ya hemos hablado de esto en detalle anteriormente.
HS: Si el valor es 1, entonces utilizamos softmax jerárquico para el entrenamiento, y si es 0, se utiliza el muestreo negativo.
Alfa: Tasa de aprendizaje inicial.
Mostremos el código final a continuación:
# list of libraries used by the code
import string
from gensim.models import Word2Vec
import logging
from nltk.corpus import stopwords
from textblob import Word
import json
import pandas as pd
# data in json format
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
# displaying the list of stopwords
stop = stopwords.words('english')
# dataframe
df = pd.DataFrame(data)

df['patterns'] = df['patterns'].apply(', '.join)
# cleaning the data using the NLP approach
print(df)
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
# taking the outer list
bigger_list = []
for i in df['patterns']:
    li = list(i.split(" "))
    bigger_list.append(li)
# structure of data to be taken by the model.word2vec
print("Data format for the overall list:", bigger_list)
# custom data is fed to machine for further processing
model = Word2Vec(bigger_list, min_count=1, size=300, workers=4)
Paso 4) Guardar modelo
El modelo se puede guardar en formato binario (bin) o como archivo de modelo. El formato binario es el que se muestra a continuación. Consulte las siguientes líneas para guardar el modelo.
model.save("word2vec.model")
model.save("model.bin")
Explicación del código anterior.
1. El modelo se guarda en forma de archivo .model.
2. El modelo se guarda en formato de archivo .bin.
Utilizaremos este modelo para realizar pruebas en tiempo real, como por ejemplo, palabras similares, palabras diferentes y palabras más comunes.
Paso 5) Cargar el modelo y realizar pruebas en tiempo real
El modelo se carga utilizando el siguiente código:
model = Word2Vec.load('model.bin')
Si desea imprimir el vocabulario, puede hacerlo utilizando el siguiente comando:
vocab = list(model.wv.vocab)
Por favor vea el resultado:
['see', 'thank', 'back', 'thanks', 'soon', 'open', 'mastercard', 'card', 'time', 'pay', 'talk', 'cash', 'one', 'please', 'goodbye', 'thats', 'helpful', 'hour', 'credit', 'hi', 'later', 'guidance', 'opening', 'timing', 'hello', 'helping', 'bye', 'tell', 'come', 'using', 'kind', 'available']
Paso 6) Verificación de palabras más similares
Implementemos las cosas de manera práctica:
similar_words = model.most_similar('thanks')
print(similar_words)
Por favor vea el resultado:
[('kind', 0.16104359924793243), ('using', 0.1352398842573166), ('come', 0.11500970274209976), ('later', 0.09989878535270691), ('helping', 0.04855936020612717), ('credit', 0.04659383371472359), ('pay', 0.0329081267118454), ('thank', 0.02484947443008423), ('hour', 0.0202352125197649), ('opening', 0.018177658319473267)]
Paso 7) No coincide con las palabras proporcionadas
dissimlar_words = model.doesnt_match('See you later, thanks for visiting'.split())
print(dissimlar_words)
Hemos proporcionado las palabras ¡Hasta luego, gracias por su visita!Esto imprime la palabra más diferente de entre estas palabras. Ejecutemos este código y veamos el resultado.
El resultado después de la ejecución del código anterior:
Thanks
Paso 8) Encontrar la similitud entre dos palabras
Esto indica el resultado en términos de la probabilidad de similitud entre dos palabras. Consulte el código a continuación para ver cómo ejecutar esta sección.
similarity_two_words = model.similarity('please', 'see')
print("Please provide the similarity between these two words:")
print(similarity_two_words)
El resultado del código anterior es el siguiente:
0.13706
Puedes encontrar palabras similares ejecutando el siguiente código:
similar = model.similar_by_word('kind')
print(similar)
Salida del código anterior:
[('credit', 0.11764447391033173), ('cash', 0.11440904438495636), ('one', 0.11151769757270813), ('hour', 0.0944807156920433), ('using', 0.0705675333738327), ('thats', 0.05206916481256485), ('later', 0.04502468928694725), ('bye', 0.03960943967103958), ('back', 0.03837274760007858), ('thank', 0.0380823090672493)]
