
NLTK Tokenize: Tokenizador de palabras y oraciones con ejemplo
 Equipo editorial
⚡ Resumen inteligente
NLTK Tokenize divide textos extensos en unidades más pequeñas llamadas tokens, un paso fundamental en el procesamiento del lenguaje natural. El conjunto de herramientas proporciona word_tokenize para dividir oraciones en palabras y sent_tokenize para dividir texto en oraciones individuales.
¿Qué es la tokenización?
Tokenization Es el proceso mediante el cual una gran cantidad de texto se divide en partes más pequeñas llamadas tokens. Estos tokens son muy útiles para encontrar patrones y se consideran un paso base para la derivación y la lematización. La tokenización también ayuda a sustituir elementos de datos confidenciales por elementos de datos no confidenciales.
El procesamiento del lenguaje natural se utiliza para crear aplicaciones como clasificación de texto, chatbot inteligente, análisis sentimental, traducción de idiomas, etc. Se vuelve vital comprender el patrón en el texto para lograr el propósito mencionado anteriormente.
Por el momento, no te preocupes por la lematización y la derivación, sino que trátalas como pasos para la limpieza de datos textuales mediante NLP (procesamiento del lenguaje natural). Hablaremos de la lematización y la derivación más adelante en el tutorial. Tareas como Clasificación de texto o filtrado de spam hace uso de PNL junto con bibliotecas de aprendizaje profundo como Keras y Flujo tensor.
El kit de herramientas de lenguaje natural tiene un módulo muy importante NLTK tokenize oraciones que además se componen de submódulos
- palabra tokenizar
- tokenizar oración
Tokenización de palabras
Usamos el método palabra_tokenize() dividir una oración en palabras. El resultado de la tokenización de palabras se puede convertir a Data Frame para una mejor comprensión del texto en aplicaciones de aprendizaje automático. También se puede proporcionar como entrada para pasos adicionales de limpieza de texto, como eliminación de puntuación, eliminación de caracteres numéricos o derivación. Los modelos de aprendizaje automático necesitan datos numéricos para entrenarse y hacer una predicción. La tokenización de palabras se convierte en una parte crucial de la conversión de texto (cadena) a datos numéricos. Por favor lea sobre Bolsa de Palabras o CountVectorizer. Consulte el ejemplo de NLTK de tokenización de palabras a continuación para comprender mejor la teoría.
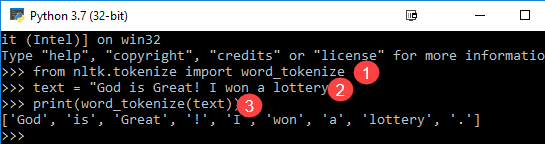
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
Code Explicación
- El módulo word_tokenize se importa de la biblioteca NLTK.
- Un “texto” variable se inicializa con dos oraciones.
- La variable de texto se pasa al módulo word_tokenize y se imprime el resultado. Este módulo divide cada palabra con puntuación que puede ver en el resultado.
Tokenización de oraciones
El submódulo disponible para lo anterior es sent_tokenize. Una pregunta obvia en tu mente sería ¿Por qué es necesaria la tokenización de oraciones cuando tenemos la opción de tokenización de palabras?. Imagina que necesitas contar el promedio de palabras por oración, ¿cómo lo calcularás? Para realizar tal tarea, necesita tanto el tokenizador de oraciones NLTK como el tokenizador de palabras NLTK para calcular la proporción. Este resultado sirve como una característica importante para el entrenamiento de máquinas, ya que la respuesta sería numérica.
Consulte el siguiente ejemplo de tokenizador NLTK para saber en qué se diferencia la tokenización de oraciones de la tokenización de palabras.
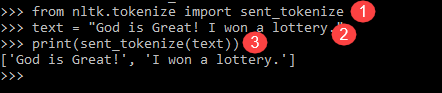
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Tenemos 12 palabras y dos oraciones para la misma entrada.
Explicación del programa.
- En una línea como el programa anterior, importe el módulo sent_tokenize.
- Hemos tomado la misma frase. Un tokenizador de oraciones adicional en el módulo NLTK analiza esas oraciones y muestra el resultado. Está claro que esta función rompe cada frase.
Tokenizador de palabras encima Python Algunos ejemplos son buenos escenarios para comprender la mecánica de la tokenización de palabras y oraciones.
