
Python Archivo XML: cómo leer, escribir y analizar
 ana blake
⚡ Resumen inteligente
Python El procesamiento XML le permite leer, escribir y analizar documentos XML utilizando los módulos integrados minidom y ElementTree. La clase minidom carga un archivo en la memoria como un DOM, mientras que ElementTree ofrece una forma más rápida y eficiente de hacerlo. PythonAPI de árbol ic.
Las secciones siguientes cubren el análisis, la escritura y la lectura de archivos XML en Python.
¿Qué es XML?
XML significa lenguaje de marcado extensible. Fue diseñado para almacenar y transportar cantidades pequeñas y medianas de datos y se usa ampliamente para compartir información estructurada.
Python te permite analizar y modificar documentos XML. Para analizar un documento XML, necesitas tener todo el documento XML en memoria. En este tutorial, veremos cómo podemos usar la clase XML minidom en Python para cargar y analizar archivos XML.
Cómo analizar XML usando minidom
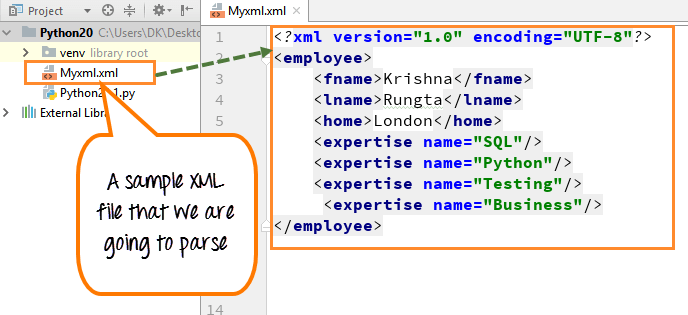
Hemos creado un archivo XML de muestra que vamos a analizar.
Paso 1) Crear un archivo XML de muestra
Dentro del archivo podemos ver el nombre, apellido, domicilio y el área de especialización (SQL, Python, Pruebas y Negocios).
Paso 2) Utilice la función de análisis para cargar y analizar el archivo XML
Una vez analizado el documento, imprimiremos el nombre del nodo raíz y el nombre de la primera etiqueta hija. El nombre de la etiqueta y el nombre del nodo son propiedades estándar del archivo XML.
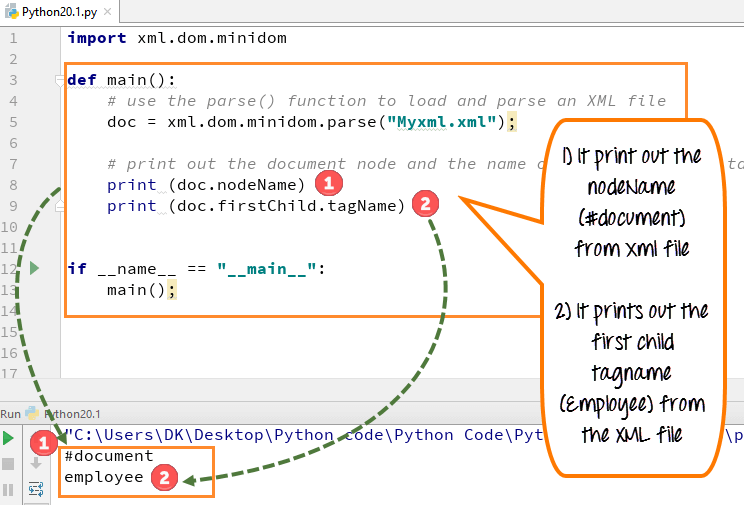
- Importa el módulo xml.dom.minidom y declara el archivo que debe ser analizado (myxml.xml).
- Este archivo contiene información básica sobre un empleado, como nombre, apellido, domicilio, experiencia, etc.
- Usamos la función de análisis en el minidom XML para cargar y analizar el archivo XML.
- Tenemos una variable llamada `doc`, y `doc` obtiene el resultado de la función de análisis.
- Queremos imprimir el nombre del nodo y el nombre de la etiqueta hija del archivo, así que lo declaramos en la función print.
- Ejecute el código: imprime el nombre de nodo (#documento) del archivo XML y el nombre de la primera etiqueta secundaria (empleado) del archivo XML.
Nota: : El nombre del nodo y el nombre de la etiqueta secundaria son los nombres o propiedades estándar de un DOM XML.
Paso 3) Obtener la lista de etiquetas XML del documento XML e imprimirla.
A continuación, también podemos llamar a la lista de etiquetas XML del documento XML e imprimirla. Aquí imprimimos el conjunto de habilidades como SQL, Python, Pruebas y negocios.

- Declara la experiencia variable, de la cual vamos a extraertractodos los nombres de experiencia que tiene el empleado
- Utilice la función estándar dom llamada "getElementsByTagName"
- Esto obtendrá todos los elementos llamados habilidad.
- Declara un bucle sobre cada una de las etiquetas de habilidad.
- Ejecuta el código: te dará una lista de cuatro habilidades.
Cómo escribir un nodo XML
Podemos crear un nuevo atributo utilizando la función "createElement" y luego agregar este nuevo atributo o etiqueta a las etiquetas XML existentes. Agregamos una nueva etiqueta "BigData" en nuestro archivo XML.
- Tienes que escribir código para añadir el nuevo atributo (BigData) a la etiqueta XML existente.
- Luego, debes imprimir la etiqueta XML con el nuevo atributo agregado a la etiqueta XML existente.
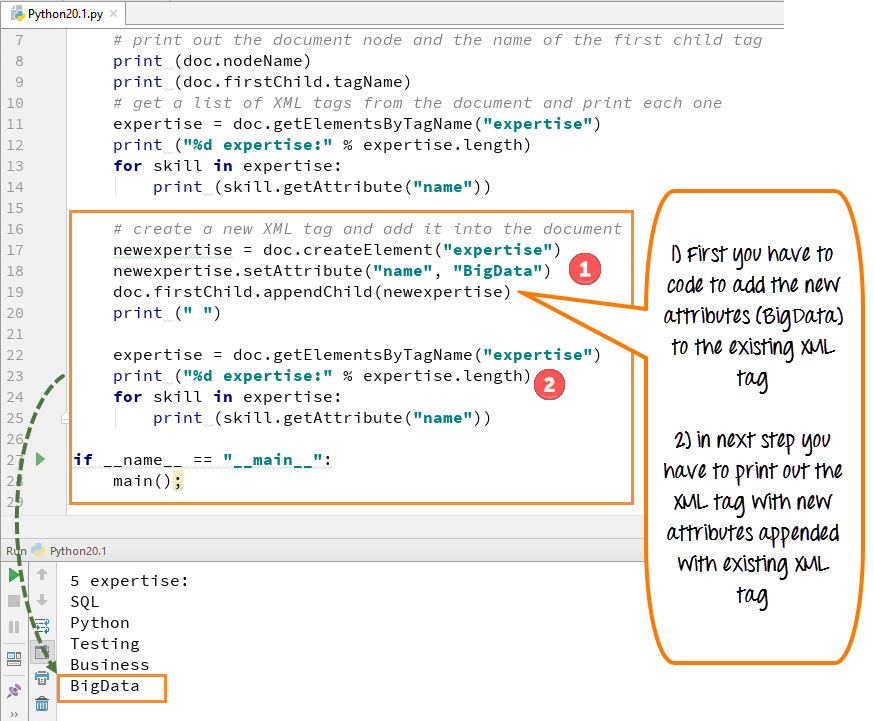
- Para agregar una nueva etiqueta XML e incorporarla al documento, utilizamos el código “doc.createElement”.
- Este código creará una nueva etiqueta de habilidad para nuestro nuevo atributo “BigData”.
- Agregue esta etiqueta de habilidad al primer elemento secundario del documento (empleado).
- Ejecuta el código: la nueva etiqueta "BigData" aparecerá junto con la otra lista de conocimientos especializados.
Ejemplo de analizador XML
Python 2 Ejemplo
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Ejemplo
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Cómo analizar XML usando ElementTree
ElementTree es una API para manipular XML. ElementTree es una forma sencilla de procesar archivos XML.
Estamos utilizando el siguiente documento XML como datos de muestra:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Leyendo XML usando ElementTree:
Primero debemos importar el módulo xml.etree.ElementTree.
import xml.etree.ElementTree as ET
Ahora vamos a obtener el elemento raíz:
root = tree.getroot()
A continuación se muestra el código completo para leer los datos XML anteriores:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Salida:
Expertise Data:
SQL
Python
