
Tutorial de DataStage para principiantes: IBM Herramienta ETL
 David Carter
⚡ Resumen inteligente
DataStage de IBM InfoSphere extracEsta herramienta procesa, transforma y carga datos empresariales a gran escala. Explica la arquitectura, los componentes, el procesamiento paralelo, la configuración de la replicación SQL, la creación de proyectos, la compilación de trabajos y las pruebas de integración mediante un ejemplo práctico de DB2 Retail.
¿Qué es DataStage?
Etapa de Datos es una herramienta ETL utilizada para extracDataStage permite transferir, transformar y cargar datos desde el origen hasta el destino. El origen de estos datos puede incluir archivos secuenciales, archivos indexados, bases de datos relacionales, fuentes de datos externas, archivos comprimidos, aplicaciones empresariales, etc. DataStage facilita el análisis empresarial al proporcionar datos de calidad que contribuyen a la obtención de inteligencia de negocio.
La herramienta ETL DataStage se utiliza en grandes organizaciones como interfaz entre diferentes sistemas. Se encarga de...tracción, traducción y carga de datos desde el origen al destino. Fue lanzado por primera vez por VMark a mediados de los 90. Con IBM Al adquirir DataStage en 2005, pasó a llamarse IBM WebSphere DataStage y posteriores a IBM Infoesfera.
Varias versiones de Datastage disponibles en el mercado hasta ahora eran Enterprise Edition (PX), Server Edition, MVS Edition, DataStage para PeopleSoft, etc. La última edición es IBM InfoSphere DataStage.
IBM El servidor de información incluye los siguientes productos:
- IBM Etapa de datos de InfoSphere
- IBM Etapa de calidad de InfoSphere
- IBM Director de servicios de información de InfoSphere
- IBM Analizador de información InfoSphere
- IBM Servidor de información rápidoTrack
- IBM Glosario empresarial de InfoSphere
Una vez establecida la definición, la siguiente sección analiza lo que el producto puede hacer realmente dentro de un almacenamiento de datos ambiente.
Descripción general de DataStage
Datastage tiene las siguientes capacidades:
- Puede integrar datos de la más amplia gama de fuentes de datos empresariales y externas.
- Implementa reglas de validación de datos.
- Es útil para procesar y transformar grandes cantidades de datos.
- Utiliza un enfoque de procesamiento paralelo escalable.
- Puede manejar transformaciones complejas y gestionar múltiples procesos de integración.
- Aproveche la conectividad directa a aplicaciones empresariales como fuentes u objetivos
- Aproveche los metadatos para análisis y mantenimiento
- OperaPruebas por lotes, en tiempo real o como servicio web.
En las siguientes secciones de este tutorial de DataStage, describimos brevemente los siguientes aspectos de IBM Etapa de datos de InfoSphere:
- Transformación de datos
- Ofertas de empleo
- Procesamiento en paralelo
InfoSphere DataStage y QualityStage pueden acceder a datos en aplicaciones empresariales y fuentes de datos como:
- Bases de datos relacionales
- Bases de datos de computadora central
- Aplicaciones empresariales y analíticas
- Planificación de recursos empresariales (ERP) o bases de datos de gestión de relaciones con el cliente (CRM)
- Procesamiento analítico en línea (OLAP) o bases de datos de gestión del rendimiento
Tipos de etapas de procesamiento
IBM El trabajo de la infosfera consta de etapas individuales que están interconectadas. Describe el flujo de datos desde una fuente de datos a un destino de datos. Normalmente, una etapa tiene como mínimo una entrada de datos y/o una salida de datos. Sin embargo, algunas etapas pueden aceptar más de una entrada de datos y salida a más de una etapa.
En el diseño del trabajo, varias etapas que puede utilizar son:
- etapa de transformación
- Etapa de filtrado
- Etapa agregadora
- Eliminar etapa duplicada
- Unirse al escenario
- etapa de búsqueda
- Copiar etapa
- Ordenar etapa
- Tanques Flexibles
¿Por qué utilizar DataStage para la integración de datos?
Una cosa es conocer la lista de funciones; otra muy distinta es saber cuándo la herramienta justifica el coste de su licencia. DataStage se elige para cargas de trabajo donde el volumen, la gobernanza y las fuentes heterogéneas hacen que los scripts escritos manualmente sean inmanejables.
La razón más evidente es el rendimiento. Dado que el motor particiona los datos entre nodos y transmite registros entre etapas simultáneamente, añadir hardware aumenta el rendimiento de forma casi lineal. Un trabajo diseñado en un entorno de desarrollo de dos nodos se ejecuta sin cambios en un clúster de producción de ocho nodos.
Las otras razones son organizativas más que técnicas:
- Metadatos compartidos: Las definiciones de tablas, las conexiones y los términos comerciales se almacenan una sola vez en el repositorio y se reutilizan en cada tarea, lo que elimina la inconsistencia que se produce cuando cada desarrollador define una fuente de forma independiente.
- Calidad de datos integrada: QualityStage ejecuta la investigación, la estandarización, la comparación y la detección de supervivencia junto con el flujo ETL, por lo que la limpieza no necesita un segundo producto.
- Amplia conectividad: Los conectores nativos llegan a DB2, Oracle, Teradata, VSAM de mainframe, SAPSalesforce y el almacenamiento de objetos en la nube sin código personalizado.
- Operacontrol cional: El sistema Director proporciona el historial de ejecución, el recuento de filas, las advertencias y los puntos de reinicio, que los auditores aceptan como evidencia de una canalización de datos controlada.
- Reutilización: Los contenedores y conjuntos de parámetros compartidos permiten que una transformación probada sirva para muchos trabajos en lugar de copiarse en cada uno de ellos.
Estas ventajas dependen directamente de cómo se ensambla el producto, lo cual se explica en la siguiente sección.
Componentes de DataStage y Architectura
DataStage tiene cuatro componentes principales, a saber,
- Administrador: Se utiliza para tareas de administración. Esto incluye configurar usuarios de DataStage, configurar criterios de depuración y crear y mover proyectos.
- Manager: Es la interfaz principal del Repositorio de ETL DataStage. Se utiliza para el almacenamiento y gestión de Metadatos reutilizables. A través del administrador de DataStage, se puede ver y editar el contenido del Repositorio.
- Diseñador: Una interfaz de diseño utilizada para crear aplicaciones O trabajos de DataStage. Especifica el origen de los datos, la transformación requerida y el destino de los datos. Los trabajos se compilan para crear un ejecutable que el Director programa y ejecuta el Servidor.
- Dirección: Se utiliza para validar, programar, ejecutar y monitorear trabajos del servidor DataStage y trabajos paralelos.

La imagen de arriba explica cómo IBM Infosphere DataStage interactúa con otros elementos del IBM Plataforma de servidor de información. DataStage se divide en dos secciones, Componentes compartidos y tiempo de ejecución ArchitecturaLa tabla que aparece a continuación detalla la contribución de cada una de esas dos secciones.
|
Compartido |
Interfaz de usuario unificada |
|
|
Servicios comunes |
|
|
|
Procesamiento paralelo común |
|
|
|
Runtime Architectura |
Guión de SST |
|
Cómo funciona el procesamiento paralelo en DataStage
La tabla de arquitectura anterior identifica el procesamiento paralelo común como un servicio compartido. Esta sección explica cómo dicho servicio ejecuta una tarea, ya que este concepto se mencionó en la descripción general y determina la velocidad de finalización de la tarea.
Un proceso paralelo utiliza dos mecanismos al mismo tiempo, y ambos se aplican automáticamente en tiempo de ejecución en lugar de ser programados manualmente.
1. Paralelismo de tuberías. Cada etapa de un trabajo comienza simultáneamente, sin esperar a que finalice la anterior. La etapa de origen comienza a leer las filas y las introduce en una canalización en memoria. El transformador se inicia en cuanto llegan las primeras filas y envía su salida a una segunda canalización. El conector de destino comienza a escribir inmediatamente después. No se escribe ningún archivo intermedio, por lo que un trabajo de tres etapas superpone la lectura, la transformación y la escritura, en lugar de ejecutarlas secuencialmente.
2. Paralelismo de partición. Las filas se dividen en particiones separadas, y una copia completa de la lógica de la etapa se ejecuta en cada partición en su propio nodo. Ocho particiones implican ocho instancias de Transformer simultáneas. Al final del flujo, las particiones se recopilan en un único flujo para el destino.
Elegir el método de particionamiento adecuado es la principal decisión de optimización que toma un desarrollador:
- Coches: Por defecto, el motor elige un método en función de las necesidades de la etapa.
- Hash: Envía filas con el mismo valor de clave al mismo nodo. Es necesario antes de Unir, Agregar y Eliminar duplicados para que las claves coincidentes se encuentren.
- Ronda Robin: Trata las filas uniformemente una por una. Mejores para cargar un archivo plano donde la clave grouping no importa.
- Completo: Copia el conjunto completo de datos a cada nodo. Se utiliza para tablas de referencia pequeñas en una etapa de búsqueda.
- Mismo: Mantiene intacta la partición existente, lo que evita una nueva partición innecesaria entre dos etapas.
- Rango y módulo: Distribuya las filas por rango de valor o por resto de clave numérica cuando se necesite una distribución uniforme.
Un archivo de configuración (APT_CONFIG_FILE) declara la cantidad de nodos existentes. Dado que el número de nodos reside fuera del trabajo, el mismo trabajo compilado se adapta desde una computadora portátil a una red de producción sin necesidad de modificar el diseño.
Antes de poder poner en práctica cualquiera de estas ideas, es necesario que se den las condiciones adecuadas.
Requisito previo para la herramienta Datastage
Para DataStage, necesitará la siguiente configuración.
- Infosfera
- Servidor DataStage 9.1.2 o superior
- Microsoft Edición Express de Visual Studio .NET 2010 C++
- Oracle cliente (cliente completo, no un cliente instantáneo) si se conecta a un Oracle base de datos de CRISPR Medicine News
- Cliente DB2 si se conecta a una base de datos DB2
Ahora, en esta serie de tutoriales de DataStage para principiantes, aprenderemos cómo descargar e instalar el servidor de información InfoSphere.
Descarga e instalación de InfoSphere Information Server
Para acceder a DataStage, descargue e instale la última versión de IBM Servidor de InfoSphere. El servidor es compatible con AIX, Linux y Windows Sistema operativo. Puedes elegir según tus necesidades.
Para migrar sus datos de una versión anterior de infosphere a una nueva versión, utilice la herramienta de intercambio de activos.
Archivos de instalación
Para instalar y configurar Infosphere Datastage, debe tener los siguientes archivos en su configuración.
Para Windows,
- Paquete de implementación Etl-windows-oracle.pkg
- Paquete de implementación Etl-windows-db2.pkg
Para linux
- EtlDeploymentPackage-linux-db2.pkg
- Paquete de implementación Etl-linux-oracle.pkg
Una vez instalado el servidor, el ejemplo práctico que se muestra en el resto de esta página utiliza la captura de datos de cambios, por lo que resulta útil ver cómo se transmiten los datos de cambios antes de implementarlo.
Flujo de proceso de datos de cambio en un trabajo de etapa de transacción CDC

El diagrama de arriba traces un único cambio de la base de datos de origen a la de destino, en el orden que se indica a continuación.
- El servicio 'InfoSphere CDC' para la base de datos monitorea y captura el cambio desde una base de datos de origen
- Según la definición de replicación, “InfoSphere CDC” transfiere los datos de cambio a “InfoSphere CDC para InfoSphere DataStage”.
- El servidor “InfoSphere CDC para InfoSphere DataStage” envía datos a la “etapa de transacción CDC” a través de una sesión TCP/IP. El servidor “InfoSphere CDC para InfoSphere DataStage” también envía un mensaje COMMIT (junto con información de marcador) para marcar el límite de la transacción en el registro capturado.
- Para cada mensaje COMMIT enviado por el servidor “InfoSphere CDC para InfoSphere DataStage”, la “etapa de transacción CDC” crea marcadores de fin de onda (EOW). Estos marcadores se envían en todos los enlaces de salida a la etapa del conector de la base de datos de destino.
- Cuando la "etapa del conector de la base de datos de destino" recibe un marcador de fin de onda en todos los enlaces de entrada, escribe información de marcador en una tabla de marcadores y luego confirma la transacción en la base de datos de destino.
- El servidor “InfoSphere CDC para InfoSphere DataStage” solicita información de marcadores de una tabla de marcadores en la “base de datos de destino”.
- El servidor “InfoSphere CDC para InfoSphere DataStage” recibe la información del marcador.
Esta información se utiliza para,
- Determine el punto de partida en el registro de transacciones donde se leen los cambios cuando comienza la replicación.
- Para determinar si el registro de transacciones existente se puede limpiar
Configurar la replicación SQL
Antes de comenzar con Datastage, necesita configurar la base de datos. Creará dos bases de datos DB2.
- Uno para servir como fuente de replicación y
- Uno como objetivo.
También creará dos tablas (Producto e Inventario) y las completará con datos de muestra. Entonces puedes probar tu integración entre SQL Replicación y etapa de datos.
En el futuro, configurará la replicación de SQL creando tablas de control, conjuntos de suscripción, registros y miembros del conjunto de suscripciónAprenderemos más sobre esto en detalle en la siguiente sección.
Aquí tomaremos un ejemplo de artículo de ventas minoristas como nuestra base de datos y crearemos dos tablas Inventario y Producto. Estas tablas cargarán datos desde el origen al destino a través de estos conjuntos. (tablas de control, conjuntos de suscripción, registros y miembros del conjunto de suscripción.)
Paso 1) Cree una base de datos de origen denominada OFERTAS. Bajo esta base de datos, cree dos tablas. producto y Inventario.
Paso 2) Ejecute el siguiente comando para crear la base de datos VENTAS.
db2 create database SALES
Paso 3) Active el registro de archivo para la base de datos SALES. Además, realice una copia de seguridad de la base de datos mediante los siguientes comandos
db2 update db cfg for SALES using LOGARCHMETH3 LOGRETAIN
db2 backup db SALES
Paso 4) En el mismo símbolo del sistema, cambie al subdirectorio setupDB en el directorio sqlrepl-datastage-tutorial que usted extracted del archivo comprimido descargado.

Paso 5) Utilice el siguiente comando para crear la tabla de Inventario e importar datos a la tabla ejecutando el siguiente comando.
db2 import from inventory.ixf of ixf create into inventory
Paso 6) Cree una tabla de destino. Nombra la base de datos de destino como ETAPADB.
Como ahora ha creado tanto el origen como el destino de la base de datos, en el siguiente paso de este tutorial de DataStage veremos cómo replicarlo.
La siguiente información puede ser útil en Configuración de una fuente de datos ODBC en el IBM Documentación de InfoSphere Information Server.
Crear los objetos de replicación SQL
La imagen a continuación muestra cómo se entrega el flujo de datos de cambios desde la base de datos de origen a la de destino. Se crea un mapa de origen a destino.ping entre mesas conocidas como miembros del conjunto de suscripción y agrupar a los miembros en un suscripción.

La unidad de replicación dentro de InfoSphere CDC (Change Data Capture) se denomina suscripción.
- Los cambios realizados en la fuente se capturan en la “tabla de control de captura” que se envía a la tabla CD y luego a la tabla de destino. Mientras que el programa de aplicación tendrá los detalles sobre la fila desde donde se deben realizar los cambios. También unirá la tabla CD en el conjunto de suscripción.
- Una suscripción incluye un mapa.ping detalles que especifican cómo se aplican los datos de un almacén de datos de origen a un almacén de datos de destino. Nota: ahora se hace referencia a CDC como Replicación de datos de infosfera.
- Cuando se ejecuta una suscripción, InfoSphere CDC captura los cambios en la base de datos de origen. InfoSphere CDC envía los datos de los cambios a la base de datos de destino y almacena la información del punto de sincronización en una tabla de marcadores en la base de datos de destino.
- InfoSphere CDC utiliza la información del marcador para supervisar el progreso del trabajo de InfoSphere DataStage.
- En caso de error, la información del marcador se utiliza como punto de reinicio. En nuestro ejemplo, el ASN.IBMLa tabla SNAP_FEEDETL almacena información de punto de sincronización relacionada con DataStage que se utiliza para track progreso de DataStage.
En esta sección de IBM Tutorial de capacitación de DataStage, debes hacer lo siguiente:
- Cree tablas CAPTURE CONTROL y APPLY CONTROL para almacenar opciones de replicación
- Registre las tablas PRODUCTO e INVENTARIO como fuentes de replicación
- Crear un conjunto de suscripción con dos miembros
- Crear miembros del conjunto de suscripción y tablas CCD de destino
Utilice el programa de línea de comandos ASNCLP para configurar la replicación SQL
Paso 1) Localice el archivo de script crtCtlTablesCaptureServer.asnclp en el directorio sqlrepl-datastage-tutorial/setupSQLRep.
Paso 2) En el archivo, reemplace y “” con su ID de usuario y contraseña para conectarse a la base de datos de VENTAS.
Paso 3) Cambie al directorio sqlrepl-datastage-tutorial/setupSQLRep y ejecute el script. Utilice el siguiente comando. El comando se conectará a la base de datos SALES y generará un script SQL para crear las tablas de control de Capture.
asnclp –f crtCtlTablesCaptureServer.asnclp
Paso 4) Localice el archivo de script crtCtlTablesApplyCtlServer.asnclp en el mismo directorio. Ahora reemplace dos instancias de y “” con el ID de usuario y la contraseña para conectarse a la base de datos STAGEDB.
Paso 5) Ahora, en el mismo símbolo del sistema, utilice el siguiente comando para crear tablas de control de aplicación.
asnclp –f crtCtlTablesApplyCtlServer.asnclp
Paso 6) Localice los archivos de script crtRegistration.asnclp y reemplace todas las instancias de con el ID de usuario para conectarse a la base de datos SALES. Además, cambie “” por la contraseña de conexión.
Paso 7) Para registrar las tablas de origen, utilice el siguiente script. Como parte de la creación del registro, el programa ASNCLP creará dos tablas de CD: CDPRODUCT Y CDINVENTORY.
asnclp –f crtRegistration.asnclp
El comando CREAR REGISTRO utiliza las siguientes opciones:
- Actualización diferencial: Solicita al programa Aplicar que actualice la tabla de destino solo cuando cambian las filas en la tabla de origen
- Imagen de ambos: Esta opción se utiliza para registrar el valor en la columna de origen antes de que se produjera el cambio y una para el valor después de que se produjera el cambio.
Paso 8) Para conectarse a la base de datos de destino (STAGEDB), siga los siguientes pasos.
- Busque el archivo crtTableSpaceApply.bat, ábralo en un editor de texto
- Reemplace y con el ID de usuario y la contraseña.
- En la ventana de comandos de DB2, ingrese crtTableSpaceApply.bat y ejecute el archivo.
- Este archivo por lotes crea un nuevo espacio de tabla en la base de datos de destino (STAGEDB)
Paso 9) Localice los archivos de script crtSubscriptionSetAndAddMembers.asnclp y realice los siguientes cambios.
- Reemplace todas las instancias de y con el ID de usuario y la contraseña para conectarse a la base de datos de VENTAS (fuente).
- Reemplace todas las instancias de y con el ID de usuario para conectarse a la base de datos STAGEDB (destino).
Después de los cambios, ejecute el script para crear un conjunto de suscripción (ST00) que agrupe las tablas de origen y de destino. El script también crea dos miembros del conjunto de suscripción y CCD (datos de cambio consistentes) en la base de datos de destino que almacenará los datos modificados. Estos datos serán consumidos por Infosphere DataStage.
Paso 10) Ejecute el script para crear el conjunto de suscripción, los miembros del conjunto de suscripción y las tablas CCD.
asnclp –f crtSubscriptionSetAndAddMembers.asnclp
Varias opciones utilizadas para crear un conjunto de suscripción y dos miembros incluyen
- Completo en condensado
- Externo
- Tipo de carga importación exportación
- Temporización continua
Paso 11) Por defecto en las herramientas de administración de replicación. Debe ejecutar otro archivo por lotes para configurar la columna TARGET_CAPTURE_SCHEMA en el IBMTabla de control SNAP_SUBS_SET a nula.
- Localice el archivo updateTgtCapSchema.bat. Ábrelo en un editor de texto. Reemplace y con el ID de usuario para conectarse a la base de datos STAGEDB.
- En la ventana de comandos de DB2, ingrese el comando updateTgtCapSchema.bat y ejecute el archivo.
Creación de archivos de definición para asignar tablas CCD a DataStage
Antes de realizar la replicación en el siguiente paso, debemos conectar la tabla CCD con DataStage. En esta sección, veremos cómo conectar SQL con DataStage.
Para conectar una tabla CCD con DataStage, es necesario crear archivos de definición de DataStage (.dsx). DataStage utiliza el formato de archivo .dsx para importar y exportar definiciones de trabajos. Se utiliza el script ASNCLP para crear dos archivos .dsx. Por ejemplo, aquí se muestran dos archivos .dsx.
- stagedb_AQ00_SET00_sJobs.dsx: Crea una secuencia de trabajos que dirige el flujo de trabajo de los cuatro trabajos paralelos.
- stagedb_AQ00_SET00_pJobs.dsx : Crea los cuatro trabajos paralelos
El programa ASNCLP asigna automáticamente la columna CCD al formato de columna Datastage. Sólo se admite cuando ASNCLP se ejecuta en Windows, Linux o Unix.

Los trabajos de Datastage extraen filas de la tabla CCD.
- Un trabajo establece un punto de sincronización donde DataStage se quedó en extracdatos de las dos tablas. El trabajo obtiene esta información seleccionando el valor SYNCHPOINT para el conjunto de suscripción ST00 de la IBMTabla SNAP_SUBS_SET e insertarla en la columna MAX_SYNCHPOINT de la IBMTabla SNAP_FEEDETL.
- Dos trabajos que extract datos de las tablas PRODUCT_CCD e INVENTORY_CCD. Los trabajos saben qué filas deben comenzar.tracting seleccionando los valores MIN_SYNCHPOINT y MAX_SYNCHPOINT del IBMTabla SNAP_FEEDETL para el conjunto de suscripción.
Una vez asignadas las definiciones, se puede iniciar la replicación para que las tablas CCD comiencen a llenarse.
Iniciando la replicación
Para iniciar la replicación, seguirá los pasos siguientes. Cuando las tablas CCD se completan con datos, indica que la configuración de replicación está validada. Para ver los datos replicados en las tablas CCD de destino, utilice la interfaz gráfica de usuario del Centro de control de DB2.
Paso 1) Asegúrese de que DB2 se esté ejecutando; de lo contrario, utilice inicio de db2 mando.
Paso 2) Luego use el comando asncap desde el indicador del sistema operativo para comenzar a capturar el programa. Por ejemplo.
asncap capture_server=SALES
El comando anterior especifica la base de datos SALES como servidor de captura. Mantenga abierta la ventana de comandos mientras se ejecuta la captura.
Paso 3) Ahora abra un nuevo símbolo del sistema. Entonces comienza el RESERVAR programa utilizando el comando asnapply.
asnapply control_server=STAGEDB apply_qual=AQ00

- El comando especifica la base de datos STAGEDB como servidor de control de Apply (la base de datos que contiene las tablas de control de Apply)
- AQ00 como calificador de Aplicar (el identificador de este conjunto de tablas de control)
Deje abierta la ventana de comandos con Aplicar en ejecución.
Paso 4) Ahora abra otro símbolo del sistema y ejecute el comando db2cc para iniciar el Centro de control de DB2. Acepte el Centro de control predeterminado.
Paso 5) Ahora, en el árbol de navegación izquierdo, abra Todas las bases de datos > STAGEDB y luego haga clic en Tablas. Double haga clic en el nombre de la tabla (Product CCD) para abrir la tabla. Se verá algo como esto.

Asimismo, también puedes abrir la tabla CCD para INVENTARIO.

Ahora la replicación alimenta las tablas CCD, por lo que la atención se traslada del lado de la base de datos a los clientes de DataStage.
Cómo crear proyectos en la herramienta Datastage
En primer lugar, creará un proyecto en DataStage. Para ello, debe ser administrador de InfoSphere DataStage.
Una vez realizadas la instalación y la replicación, debe crear un proyecto. En DataStage, los proyectos son un método para organizar sus datos. Incluye la definición de archivos de datos, etapas y trabajos de construcción en un proyecto específico.
Para crear un proyecto en DataStage, siga los pasos a continuación:
Paso 1) Inicie el software DataStage
Inicie el administrador de DataStage y QualityStage. Luego haga clic en Inicio > Todos los programas > IBM Servidor de información > IBM Administrador de WebSphere DataStage y QualityStage.
Paso 2) Conecte el servidor y el cliente de DataStage
Para conectarse al servidor DataStage desde su cliente DataStage, ingrese detalles como el nombre de dominio, el ID de usuario, la contraseña y la información del servidor.
Paso 3) Agregar un nuevo proyecto
En la ventana Administración de WebSphere DataStage. Haga clic en la pestaña Proyectos y luego haga clic en Agregar.
Paso 4) Ingrese los detalles del proyecto
En la ventana Administración de WebSphere DataStage, ingrese detalles como
- Nombre
- Ubicación del archivo
- Haga clic en Aceptar'

Cada proyecto contiene:
- Empleos de DataStage
- Componentes incorporados. Estos son componentes predefinidos que se utilizan en un trabajo.
- Componentes definidos por el usuario. Estos son componentes personalizados creados utilizando DataStage Manager o DataStage Designer.
Veremos cómo importar trabajos de replicación en Datastage Infosphere.
Cómo importar trabajos de replicación en Datastage y QualityStage Designer
Importarás trabajos en el IBM Cliente InfoSphere DataStage y QualityStage Designer. Y los ejecutas en el IBM Cliente InfoSphere DataStage y QualityStage Director.
El diseñador-cliente es como un lienzo en blanco para los trabajos de construcción.tracts, transformar, cargar y verificar la calidad de los datos. Proporciona herramientas que forman los bloques de construcción básicos de un trabajo. Incluye
- Cíclos: Se conecta a fuentes de datos para leer o escribir archivos y procesar datos.
- Enlaces: Conecta las etapas por las que fluyen tus datos.
Las etapas del cliente InfoSphere DataStage y QualityStage Designer se almacenan en la paleta de herramientas del Diseñador.
Las siguientes etapas están incluidas en InfoSphere QualityStage:
- etapa de investigación
- Estandarizar etapa
- Etapa de frecuencia de coincidencia
- Etapa de coincidencia de fuente única
- Etapa de coincidencia de dos fuentes
- Etapa de supervivencia
- Etapa de Evaluación de la Calidad de la Estandarización (SQA)
Puede crear 4 tipos de trabajos en la infoesfera de DataStage.
- trabajo paralelo
- Trabajo de secuencia
- Trabajo de computadora central
- Trabajo del servidor
Veamos paso a paso cómo importar archivos de trabajos de replicación.
Paso 1) Inicie DataStage y QualityStage Designer. Haga clic en Inicio > Todos los programas > IBM Servidor de información > IBM WebSphere DataStage y QualityStage Designer
Paso 2) En la ventana Adjuntar al proyecto, ingrese los siguientes detalles.
- Dominio
- Nombre de usuario
- Contraseña
- Nombre del Proyecto
- OK

Paso 3) Ahora desde el menú Archivo, haga clic en importar -> Componentes de DataStage.
Se abrirá una nueva ventana de importación del repositorio de DataStage.
- En esta ventana navega STAGEDB_AQ00_ST00_sTrabajos.dsx archivo que habíamos creado anteriormente
- Seleccione la opción "Importar todo".
- Marque la casilla de verificación “Realizar análisis de impacto”.
- Haga clic en Aceptar.'

Una vez importado el trabajo, DataStage creará el trabajo STAGEDB_AQ00_ST00_sequence.
Paso 4) Siga los mismos pasos para importar el Archivo STAGEDB_AQ00_ST00_pJobs.dsx. Esta importación crea los cuatro trabajos paralelos.
Paso 5) En el panel Repositorio de Designer -> Abra la carpeta SQLREP. Dentro de la carpeta, verá Sequence Job y cuatro trabajos paralelos.
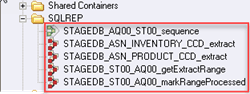
Paso 6) Para ver el trabajo de secuencia. Vaya al árbol del repositorio, haga clic derecho en el trabajo STAGEDB_AQ00_ST00_sequence y haga clic en Editar. Mostrará el flujo de trabajo de los cuatro trabajos paralelos que controla la secuencia de trabajos.

Cada icono es un escenario,
- obtenerExtracEtapa de rango: Actualiza el IBMTabla SNAP_FEEDETL. Establecerá el punto de partida para los datos.tracción hasta el punto donde DataStage ex últimotracted filas y establecer el punto final en la última transacción que se procesó para el conjunto de suscripción.
- obtenerExtractRangeSuccess: Esta etapa alimenta los puntos de partida a la extracEtapa y ex de tFromINVENTORY_CCDtracEtapa tFromPRODUCT_CCD
- AllExtractsSuccess: Esta etapa garantiza que ambos extractFromINVENTORY_CCD y extractFromPRODUCT_CCD se completó correctamente. Luego, pasa los puntos de sincronización de las últimas filas recuperadas a la etapa setRangeProcessed.
- etapa setRangeProcessed: Se actualiza IBMTabla SNAP_FEEDETL. Por lo tanto, DataStage sabe desde dónde comenzar la siguiente ronda de extracción de datos.tracdisrupción
Paso 7) Para ver los trabajos paralelos. Haga clic derecho en STAGEDB_ASN_INVENTORY_CCD y seleccione editar en el repositorio. Se abrirá una ventana como se muestra a continuación.

Aquí, en la imagen de arriba, puede ver que los datos de la tabla CCD de inventario y SyncLos detalles del punto h de la tabla FEEDETL se representan en la etapa Lookup_6.
Los trabajos importados siguen sin apuntar a nada, por lo que a continuación hay que definir un objeto de conexión de datos.
Creación de una conexión de datos desde DataStage a la base de datos STAGEDB
Ahora el siguiente paso es crear una conexión de datos entre InfoSphere DataStage y la base de datos de destino de SQL Replication. Contiene las tablas CCD.
En DataStage, utiliza objetos de conexión de datos con etapas de conector relacionadas para definir rápidamente una conexión a una fuente de datos en un diseño de trabajo.
Paso 1) STAGEDB contiene las tablas de control Apply que DataStage utiliza para sincronizar sus datos.tracción y las tablas CCD de las que se extraen los datostracted. Utilice los siguientes comandos
db2 catalog tcpip node SQLREP remote ip_address server 50000
db2 catalog database STAGEDB as STAGEDB2 at node SQLREP
Nota: : dirección IP del sistema donde se creó STAGEDB
Paso 2) Haga clic en Archivo > Nuevo > Otro > Conexión de datos.
Paso 3) Tendrás una ventana con dos pestañas, Parámetros y General.

Paso 4) En este paso,
- En general, pestaña, nombre la conexión de datos sqlreplConnect
- En la pestaña Parámetros, como se muestra a continuación
- Haga clic en el botón de exploración junto al campo "Conectar usando el tipo de etapa" y en el
- Ventana abierta, navegue por el árbol del repositorio hasta Tipos de etapa –> Paralelo– > Base de datos —-> Conector DB2.
- Haga clic en Abrir.

Paso 5) En la tabla de parámetros de conexión, ingrese detalles como
- Cadena de conexión: STAGEDB2
- Nombre de usuario: ID de usuario para conectarse a la base de datos STAGEDB
- Contraseña: Contraseña para conectarse a la base de datos STAGEDB
- Ejemplo: Nombre de la instancia de DB2 que contiene la base de datos STAGEDB
Paso 6) En la siguiente ventana guarde la conexión de datos. Haga clic en el botón "guardar".
Importación de definiciones de tablas desde STAGEDB a DataStage
En el paso anterior, vimos que InfoSphere DataStage y la base de datos STAGEDB están conectados. Ahora, importe la definición de columna y otros metadatos para las tablas PRODUCT_CCD e INVENTORY_CCD al repositorio del servidor de información.
En la ventana del diseñador, siga los pasos a continuación.
Paso 1) Seleccione Importar > Definiciones de tabla > Iniciar asistente de importación de conectores.
Paso 2) En la página de selección de conector del asistente, seleccione el conector DB2 y haga clic en Siguiente.

Paso 3) Haga clic en cargar en la página de detalles de la conexión. Esto completará los campos del asistente con información de conexión de la conexión de datos que creó en el capítulo anterior.

Paso 4) Haga clic en Probar conexión en la misma página. Esto hará que DataStage intente conectarse a la base de datos STAGEDB. Puede ver el mensaje "la conexión se realizó correctamente". Haga clic en Siguiente.

Paso 5) Asegúrese de que en la página Ubicación de la fuente de datos los campos Nombre de host y Nombre de base de datos estén correctamente completados. Luego haga clic en siguiente.
Paso 6) En la página de esquema. Ingrese el esquema de Aplicar tablas de control (ASN) o verifique que el esquema ASN esté completado previamente en el campo de esquema. Luego haga clic en siguiente. La página de selección mostrará la lista de tablas definidas en el esquema ASN.

Paso 7) La primera tabla desde la que necesitamos importar metadatos es IBMSNAP_FEEDETL, una tabla de control de aplicación. Contiene los detalles sobre los puntos de sincronización que permiten a DataStage mantener track de las cuales filas ha obtenido de las tablas CCD. Elija IBMSNAP_FEEDETL y haga clic en Siguiente.
Paso 8) Para completar la importación del IBMDefinición de tabla SNAP_FEEDETL. Haga clic en importar y luego, en la ventana abierta, haga clic en abrir.
Paso 9) Repita los pasos del 1 al 8 dos veces más para importar las definiciones de la tabla PRODUCT_CCD y luego la tabla INVENTORY_CCD.
NOTA: Al importar definiciones para el inventario y el producto, asegúrese de cambiar los esquemas de ASN al esquema bajo el cual se crearon PRODUCT_CCD e INVENTORY_CCD.
Ahora DataStage tiene todos los detalles que necesita para conectarse a la base de datos de destino de replicación SQL.
Configuración de propiedades para los trabajos de DataStage
Para cada uno de los cuatro trabajos paralelos de DataStage que tenemos, contiene una o más etapas que se conectan con la base de datos STAGEDB. Debe modificar las etapas para agregar información de conexión y vincular a los archivos del conjunto de datos que completa DataStage.
Las etapas tienen propiedades predefinidas que se pueden editar. Aquí cambiaremos algunas de estas propiedades para STAGEDB_ASN_PRODUCT_CCD_ex.tractrabajo paralelo.
Paso 1) Explore el árbol del repositorio del Diseñador. En la carpeta SQLREP, seleccione STAGEDB_ASN_PRODUCT_CCD_ex.tracTrabajo paralelo. Para editar, haga clic con el botón derecho en el trabajo. La ventana de diseño del trabajo paralelo se abrirá en la paleta de diseño.
Paso 2) Localice el icono verde. Este icono indica la etapa del conector DB2. Se utiliza para, por ejemplo:tracdatos de la tabla CCD. Double-haga clic en el icono. Se abre una ventana del editor de escenario.


Paso 3) En el editor, haga clic en Cargar para completar los campos con información de conexión. Para cerrar el editor de escenario y guardar los cambios, haga clic en Aceptar.
Paso 4) Ahora vuelva a la ventana de diseño para STAGEDB_ASN_PRODUCT_CCD_ex.tractrabajo paralelo. Localice el icono para obtenerSyncEtapa del conector DB2 de hPoints. A continuación, haga doble clic en el icono.
Paso 5) Ahora haga clic en el botón cargar para completar los campos con información de conexión.
NOTA: si está utilizando una base de datos distinta de STAGEDB como servidor de control de Apply. Luego seleccione la opción para cargar la información de conexión para obtenerSyncEtapa hPoints, que interactúa con las tablas de control en lugar de con la tabla CCD.
Paso 6) En este paso,
- Cree un archivo de texto vacío en el sistema donde se ejecuta InfoSphere DataStage.
- Nombra este archivo como productdataset.ds y toma nota de dónde lo guardaste.
- DataStage escribirá cambios en este archivo después de recuperar los cambios de la tabla CCD.
- Los conjuntos de datos o archivos que se utilizan para mover datos entre trabajos vinculados se conocen como conjuntos de datos persistentes. Está representado por una etapa DataSet.
Paso 7) Ahora abra el editor de escenarios en la ventana de diseño y haga doble clic en el icono insert_into_a_dataset. Se abrirá otra ventana.

Paso 8) En esta ventana

- En la pestaña de propiedades, asegúrese de que Target La carpeta está abierta y la propiedad Archivo = DATASETNAME está resaltada.
- A la derecha, tendrás un campo de archivo.
- Ingrese la ruta completa al archivo productdataset.ds
- Haga clic en Aceptar'.
Ahora ha actualizado todas las propiedades necesarias para la tabla CCD del producto. Cierre la ventana de diseño y guarde todos los cambios.
Paso 9) Ahora localice y abra STAGEDB_ASN_INVENTORY_CCD_extract trabajo paralelo desde el panel del repositorio del Diseñador y repita los pasos 3-8.
NOTA:
- Debe cargar la información de conexión para la base de datos del servidor de control en el editor de escenario para obtenerSyncEtapa de puntos. Si su servidor de control no es STAGEDB.
- Para STAGEDB_ST00_AQ00_getExtracLos trabajos paralelos tRange y STAGEDB_ST00_AQ00_markRangeProcessed abren todas las etapas del conector DB2. Luego, utiliza la función de carga para agregar información de conexión para la base de datos STAGEDB.
Todas las propiedades ya están configuradas, por lo que los trabajos pueden compilarse y ejecutarse.
Compilación y ejecución de trabajos de DataStage
Cuando el trabajo de DataStage está listo para compilarse, el Diseñador valida el diseño del trabajo observando entradas, transformaciones, expresiones y otros detalles.
Cuando la compilación del trabajo se realiza correctamente, estará listo para ejecutarse. Compilaremos los cinco trabajos, pero solo ejecutaremos la "secuencia de trabajos". Esto se debe a que este trabajo controla los cuatro trabajos paralelos.
Paso 1) En la carpeta SQLREP. Seleccione cada uno de los cinco trabajos con (Cntrl+Shift). Luego haga clic derecho y elija la opción de compilación de trabajos múltiples.

Paso 2) Verá que hay cinco trabajos seleccionados en el Asistente de compilación de DataStage. Haga clic en Siguiente.

Paso 3) La compilación comienza y muestra un mensaje "Compilado correctamente" una vez finalizada.

Paso 4) Ahora inicie DataStage y QualityStage Director. Seleccione Inicio > Todos los programas > IBM Servidor de información > IBM Director de WebSphere DataStage y QualityStage.
Paso 5) En el panel de navegación del proyecto a la izquierda. Haga clic en la carpeta SQLREP. Esto incluye los cinco puestos de trabajo en la tabla de estatus de director.
Paso 6) Seleccione el trabajo STAGEDB_AQ00_S00_sequence. En la barra de menú, haga clic en Trabajo > Ejecutar ahora.

Una vez finalizada la compilación, verá el estado finalizado.

Ahora verifique si las filas modificadas que se almacenan en las tablas PRODUCT_CCD e INVENTORY_CCD fueron extracprocesado por DataStage e insertado en los dos archivos de conjunto de datos.
Paso 7) Vuelva al Diseñador y abra STAGEDB_ASN_PRODUCT_CCD_ex.tractrabajo t. Para abrir el editor de escenarios Double-Haga clic en el icono insertar_en_un_conjunto de datos. Luego haga clic en ver datos.
Paso 8) Acepte los valores predeterminados en las filas que se mostrarán en la ventana. Luego haga clic en Aceptar. Se abrirá una ventana del navegador de datos para mostrar el contenido del archivo del conjunto de datos.

Prueba de integración entre replicación SQL y DataStage
En el paso anterior, compilamos y ejecutamos el trabajo. En esta sección, comprobaremos la integración de la replicación SQL y DataStage. Para eso, realizaremos cambios en la tabla de origen y veremos si el mismo cambio se actualiza en DataStage.
Paso 1) Navegue hasta la carpeta sqlrepl-datastage-scripts de su sistema operativo.
Paso 2) Inicie la replicación SQL siguiendo estos pasos:
- Ejecute startSQLCapture.bat (Windows) archivo para iniciar el programa Capture en la base de datos de VENTAS.
- Ejecute startSQLApply.bat (Windows) para iniciar el programa Apply en la base de datos STAGEDB.
Paso 3) Ahora abra el archivo updateSourceTables.sql. Para conectarse a la base de datos de VENTAS, reemplace y con el ID de usuario y la contraseña.
Paso 4) Abra una ventana de comandos de DB2. Cambie el directorio a sqlrepl-datastage-tutorial\scripts y ejecute el problema con el comando indicado:
db2 -tvf updateSourceTables.sql
El script SQL realizará varias operaciones como Actualizar, Insertar y eliminar en ambas tablas (PRODUCTO, INVENTARIO) en la base de datos de Ventas.
Paso 5) En el sistema donde se ejecuta DataStage. Abra DataStage Director y ejecute el trabajo STAGEDB_AQ00_S00_sequence. Haga clic en Trabajo > Ejecutar ahora.

Cuando se ejecuta el trabajo se llevarán a cabo las siguientes actividades.
- El programa Capture lee los cambios de seis filas en el registro de la base de datos de VENTAS y los inserta en las tablas del CD.
- El programa Apply recupera las filas de cambios de las tablas CD en SALES y las inserta en las tablas CCD en STAGEDB.
- Los dos DataStage extracLos trabajos t recogen los cambios de las tablas CCD y los escriben en los archivos productdataset.ds e inventory dataset.ds.
Puede comprobar que los pasos anteriores se llevaron a cabo observando los conjuntos de datos.
Paso 6) Siga los pasos a continuación,
- Inicie el Diseñador. Abra STAGEDB_ASN_PRODUCT_CCD_extractrabajo.
- Entonces Double-Haga clic en el icono insertar_en_un_conjunto de datos. En el editor de escenario. Haga clic en Ver datos.
- Acepte los valores predeterminados en las filas que se mostrarán en la ventana y haga clic en Aceptar.
El conjunto de datos contiene tres filas nuevas. La forma más sencilla de comprobar que se implementaron los cambios es desplazarse hacia abajo a la derecha del Explorador de datos. Ahora mira las últimas tres filas (ver imagen a continuación)

Las letras I, U y D especifican las operaciones INSERTAR, ACTUALIZAR y ELIMINAR que dieron como resultado cada nueva fila.
Puede hacer la misma verificación para la tabla de Inventario.
DataStage frente a otras herramientas ETL populares
Una vez que el flujo de trabajo integral funciona correctamente, la siguiente pregunta habitual es cómo se compara DataStage con las alternativas que el equipo ya posee. La siguiente tabla lo compara con tres plataformas ampliamente utilizadas según los criterios que suelen influir en la decisión de compra.
| Criterios | IBM Etapa de Datos | informática Centro de poder | Talend | SSIS |
|---|---|---|---|---|
| Modelo de procesamiento | Pipeline más paralelismo de partición | Particionamiento basado en metadatos | Generado Java or Spark código | Flujo de datos en memoria |
| Mejores ajuste | Cargas de trabajo empresariales muy grandes, tanto por lotes como de CDC. | Arquitecturas heredadas complejas con una gobernanza robusta | Equipos nativos de la nube y sensibles a los costos | Microsoft SQL Server fincas |
| Licencias | Comercial, nivel premium | Comercial | Edición de código abierto más niveles comerciales | Incluido con SQL Server |
| Curva de aprendizaje | Se necesitan especialistas en ETL con un alto nivel de desarrollo. | Empinado | Nivel moderado, la habilidad para programar ayuda | Moderado |
| Calidad de datos | QualityStage incluido en la suite | Producto independiente de calidad de datos | Calidad de datos de Talend incluida | Componentes adicionales |
En resumen, DataStage se elige cuando el rendimiento bruto, el alcance del mainframe y el linaje listo para auditoría importan más que el costo de la licencia. Equipos que trabajan principalmente en la nube. arquitectura del lago de datos o comparando extracEl orden t primero puede encontrar las compensaciones en ETL vs ELT más relevante, y una lista más amplia aparece en el resumen de Herramientas ETL y herramientas de integración de datos.
