
Python Acceso a Internet mediante Urllib.Request y urlopen()
 Equipo editorial
⚡ Resumen inteligente
urllib es el estándar Python módulo para acceder a datos de Internet, permitiendo que los programas se abran URLy recupera contenido HTML, JSON o binario. La función urllib.request.urlopen() se conecta a una dirección web y lee la respuesta del servidor directamente en Python.
Las secciones siguientes explican qué es urllib, cómo abrir un URL y leer su código HTML, y cómo manejar errores, descargar archivos y elegir entre urllib y la biblioteca requests.
¿Qué es urllib?
urllib es un Python módulo que se puede utilizar para abrir URLs. Define funciones y clases para ayudar en URL acciones.
Con PythonTambién puedes acceder y recuperar datos de Internet, como XML, HTML y JSON, y luego trabajar directamente con estos datos. En las secciones siguientes, veremos cómo recuperar datos de la web. Por ejemplo, aquí usamos un GuruVídeo 99 URL, accede a él usando Pythony imprime el archivo HTML de este URL.
El paquete urllib agrupa varios módulos: urllib.request para abrir URLs, urllib.error para las excepciones que pueden generar las solicitudes, urllib.parse para construir y analizar URLs, y urllib.robotparser para leer archivos robots.txt.
Como abrir URL usando Urllib
Antes de ejecutar el código para conectarnos a los datos de Internet, necesitamos importar el URL módulo de biblioteca, o “urllib”.
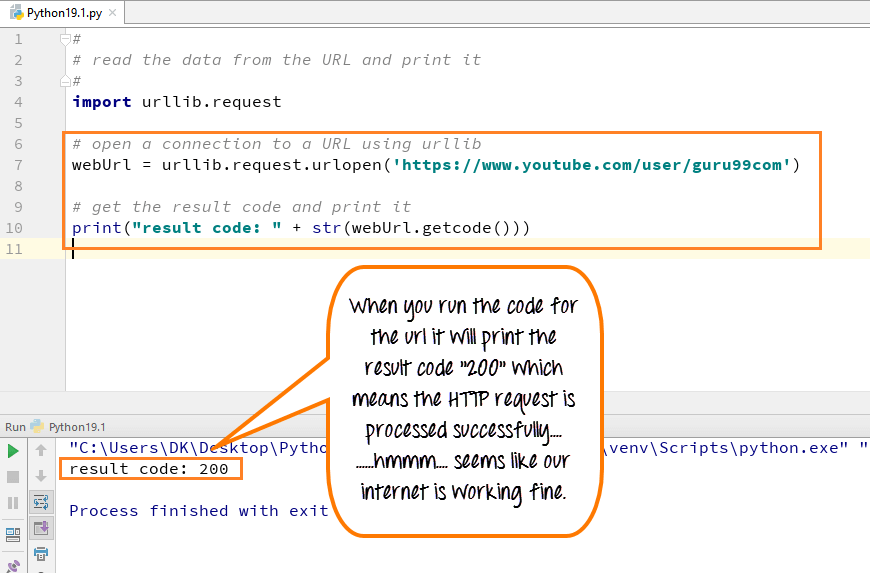
- Importar URLlib
- Define tu función principal
- Declarar la variable webUrl
- Luego, llama a la función urlopen de la biblioteca urllib.
- El URL estamos abriendo es el Guru99 tutorial sobre YouTube
- A continuación, imprimimos el código resultante.
- El código de resultado se obtiene llamando a la función getcode en la variable webUrl que hemos creado.
- Lo convertimos en una cadena, para que pueda concatenarse con nuestra cadena "código de resultado".
- Este será un código HTTP estándar "200", que indica que la solicitud HTTP se procesó correctamente.
Cómo obtener un archivo HTML de un URL in Python
También puede leer el archivo HTML utilizando la función read() en PythonAl ejecutar el código, el archivo HTML aparecerá en la consola.
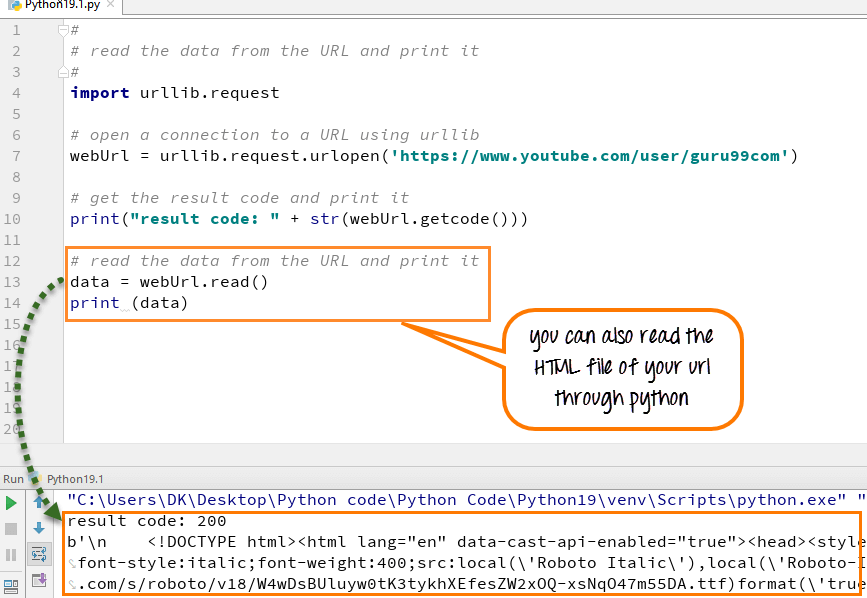
- Llama a la función read() en la variable webUrl.
- El método read() permite leer el contenido de los archivos de datos.
- Lea el contenido completo del URL en una variable llamada datos
- Ejecuta el código y se imprimirán los datos en formato HTML.
Aquí está el código completo:
Python 2 Ejemplo
#
# read the data from the URL and print it
#
import urllib2

def main():
# open a connection to a URL using urllib2
   webUrl = urllib2.urlopen("https://www.youtube.com/user/guru99com")

#get the result code and print it
   print "result code: " + str(webUrl.getcode())

# read the data from the URL and print it
   data = webUrl.read()
   print data

if __name__ == "__main__":
  main()
Python 3 Ejemplo
#
# read the data from the URL and print it
#
import urllib.request
# open a connection to a URL using urllib
webUrl  = urllib.request.urlopen('https://www.youtube.com/user/guru99com')

#get the result code and print it
print ("result code: " + str(webUrl.getcode()))

# read the data from the URL and print it
data = webUrl.read()
print (data)
Cómo solucionar los errores de urllib: URLError y HTTPError
Una solicitud no siempre tiene éxito. Cuando algo falla, urllib genera una excepción en lugar de devolver datos, por lo que es importante gestionar estos errores. El módulo urllib.error define dos clases de excepción principales.
- Error HTTP Se genera cuando el servidor devuelve un código de estado de error, como 404 Not Found o 500 Internal Server Error. Contiene el código de estado y el cuerpo de la respuesta.
- URLError Se genera cuando no se puede acceder al servidor, por ejemplo, debido a un nombre de dominio incorrecto o a la falta de conexión a internet. Incluye un atributo de motivo que explica el fallo.
Porque HTTPError es una subclase de URLEn caso de error, capture siempre primero el HTTPError para que cada tipo de error se gestione por separado:
from urllib.request import urlopen
from urllib.error import HTTPError, URLError

try:
    response = urlopen("https://www.guru99.com/no-such-page.html")
    data = response.read()
except HTTPError as error:
    print("HTTP error:", error.code)
except URLError as error:
    print("URL error:", error.reason)
Gestionar estas excepciones evita que el programa falle y permite registrar el problema, reintentar la solicitud o recurrir a los datos almacenados en caché.
Cómo descargar un archivo de un URL Usando urllib
la lectura de un URL Para páginas pequeñas, almacenar en memoria funciona, pero para imágenes, documentos PDF o conjuntos de datos es más sencillo guardar la respuesta directamente en el disco. El módulo urllib.request ofrece dos maneras sencillas de hacerlo.
La función urlretrieve() descarga un URL directamente a un archivo local en una sola línea:
from urllib.request import urlretrieve

urlretrieve("https://www.python.org/static/img/python-logo.png", "logo.png")
Para tener más control, abra el URL y escribe tú mismo los bytes. Abre el archivo local en modo binario porque urlopen() devuelve bytes, no texto:
from urllib.request import urlopen

with urlopen("https://example.com/data.zip") as response:
    with open("data.zip", "wb") as file:
        file.write(response.read())
Para archivos muy grandes, lea y escriba en un bucle usando response.read(8192) para que nunca se mantenga todo el archivo en la memoria a la vez.
urllib frente a la biblioteca requests en Python
urllib forma parte de Python Es una biblioteca estándar, por lo que funciona en cualquier lugar sin necesidad de instalación. La biblioteca requests de terceros no está integrada, pero muchos desarrolladores la prefieren para el trabajo HTTP cotidiano porque su sintaxis es más corta y legible.
Las principales diferencias son:
- Instalación: urllib se envía con Python, mientras que requests debe instalarse con pip.
- Descodificación: urllib devuelve bytes sin procesar que usted mismo decodifica, mientras que requests decodifica automáticamente el texto y el JSON.
- Conveniencia: requests gestiona las sesiones, las cookies y los encabezados personalizados con menos código.
- Dependencias: urllib no añade nada, mientras que requests se basa en urllib3 internamente.
Elige urllib si no necesitas dependencias o solo requieres una solicitud rápida y puntual. Para proyectos más grandes que impliquen autenticación, sesiones o llamadas frecuentes a la API, elige requests. Ambas opciones envían las mismas solicitudes HTTP subyacentes, por lo que la decisión se reduce a priorizar la comodidad frente a una menor cantidad de dependencias.
