
Στέλεχος και Λεμματοποίηση σε Python NLTK με Παραδείγματα
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Η ρίζα και η λημματοποίηση είναι τεχνικές κανονικοποίησης κειμένου Python NLTK που μειώνουν τις παραλλαγές λέξεων σε μια κοινή βάση, όπου τα επιθήματα stemding crops γρήγορα χωρίς συμφραζόμενα και λημματοποίηση επιστρέφουν μια αληθινή λέξη λεξικού χρησιμοποιώντας νόημα.
Τι είναι το Stemming και το Lemmatization Python NLTK;
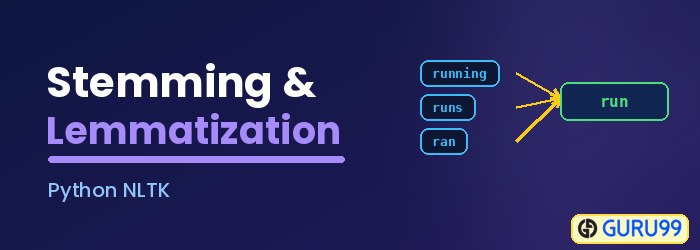
Στέλεχος και Λεμματοποίηση in Python Οι τεχνικές NLTK είναι τεχνικές κανονικοποίησης κειμένου για την Επεξεργασία Φυσικής Γλώσσας. Αυτές οι τεχνικές χρησιμοποιούνται ευρέως για την προεπεξεργασία κειμένου. Η διαφορά μεταξύ της δημιουργίας stemming και της λημματοποίησης είναι ότι η δημιουργία stemming είναι ταχύτερη επειδή κόβει λέξεις χωρίς να γνωρίζει τα συμφραζόμενα, ενώ η λημματοποίηση είναι πιο αργή επειδή γνωρίζει τα συμφραζόμενα των λέξεων πριν από την επεξεργασία.
Τι είναι το Stemming;
Βλάστηση είναι μια μέθοδος ομαλοποίησης λέξεων σε Επεξεργασία φυσικής γλώσσαςΕίναι μια τεχνική κατά την οποία ένα σύνολο λέξεων σε μια πρόταση μετατρέπεται σε μια ακολουθία για να συντομευτεί η αναζήτηση. Σε αυτήν τη μέθοδο, οι λέξεις που έχουν την ίδια σημασία αλλά κάποιες παραλλαγές ανάλογα με τα συμφραζόμενα ή την πρόταση κανονικοποιούνται. Με άλλα λόγια, υπάρχει μία ρίζα λέξης, αλλά υπάρχουν πολλές παραλλαγές της ίδιας λέξης. Για παράδειγμα, η ρίζα λέξης είναι «eat» και οι παραλλαγές της είναι «eats, eating, eaten, και ούτω καθεξής». Με τον ίδιο τρόπο, με τη βοήθεια του Stemming στο Python, μπορούμε να βρούμε τη ρίζα οποιασδήποτε παραλλαγής.
Για παράδειγμα:
He was riding.
He was taking the ride.
Στις δύο παραπάνω προτάσεις, η σημασία είναι η ίδια, δηλαδή, μια δραστηριότητα οδήγησης στο παρελθόν. Ένας άνθρωπος μπορεί εύκολα να καταλάβει ότι και οι δύο έννοιες είναι οι ίδιες. Αλλά για τις μηχανές, και οι δύο προτάσεις είναι διαφορετικές. Έτσι, γίνεται δύσκολο να τις μετατρέψουμε στην ίδια σειρά δεδομένων. Εάν δεν παρέχουμε το ίδιο σύνολο δεδομένων, τότε η μηχανή δεν μπορεί να προβλέψει. Επομένως, είναι απαραίτητο να διαφοροποιήσουμε τη σημασία κάθε λέξης για να προετοιμάσουμε το σύνολο δεδομένων για μηχανική μάθηση. Εδώ, η ρίζα χρησιμοποιείται για την κατηγοριοποίηση του ίδιου τύπου δεδομένων, λαμβάνοντας τη ριζική της λέξη.
Ας το εφαρμόσουμε αυτό με ένα Python πρόγραμμα. Το NLTK έχει έναν αλγόριθμο που ονομάζεται PorterStemmerΑυτός ο αλγόριθμος δέχεται τη λίστα των λέξεων με διακριτικά και τις ταξινομεί σε ριζικές λέξεις.
Πρόγραμμα για την κατανόηση του Stemming
from nltk.stem import PorterStemmer
e_words= ["wait", "waiting", "waited", "waits"]
ps =PorterStemmer()
for w in e_words:
    rootWord=ps.stem(w)
    print(rootWord)
Παραγωγή:
wait
wait
wait
wait
Code Επεξήγηση:
- Υπάρχει μια ενότητα stem στο NLTK η οποία εισάγεται. Εάν εισαγάγετε ολόκληρη την ενότητα, το πρόγραμμα γίνεται βαρύ καθώς περιέχει χιλιάδες γραμμές κώδικα. Έτσι, από ολόκληρη την ενότητα stem, εισαγάγαμε μόνο το "PorterStemmer".
- Ετοιμάσαμε μια εικονική λίστα δεδομένων παραλλαγής της ίδιας λέξης.
- Δημιουργείται ένα αντικείμενο που ανήκει στην κλάση nltk.stem.porter.PorterStemmer.
- Τα περάσαμε στο PorterStemmer ένα προς ένα χρησιμοποιώντας έναν βρόχο "for". Τέλος, λάβαμε την τελική ρίζα κάθε λέξης που αναφέρεται στη λίστα.
Από τα παραπάνω, η δημιουργία stemming είναι ένα σημαντικό βήμα προεπεξεργασίας επειδή αφαιρεί τον πλεονασμό και τις παραλλαγές στην ίδια λέξη. Ως αποτέλεσμα, τα δεδομένα φιλτράρονται, κάτι που βοηθά στην καλύτερη εκπαίδευση της μηχανής. Τώρα περνάμε μια ολοκληρωμένη πρόταση και ελέγχουμε την έξοδό της.
from nltk.stem import PorterStemmer
from nltk.tokenize import sent_tokenize, word_tokenize
sentence="Hello Guru99, You have to build a very good site and I love visiting your site."
words = word_tokenize(sentence)
ps = PorterStemmer()
for w in words:
	rootWord=ps.stem(w)
	print(rootWord)
Παραγωγή:
hello
guru99
,
you
have
build
a
veri
good
site
and
I
love
visit
your
site
Code Επεξήγηση:
- Το πακέτο PorterStemmer εισάγεται από το στέλεχος της ενότητας.
- Εισάγονται πακέτα για την μετατροπή προτάσεων καθώς και λέξεων σε tokenization.
- Γράφεται μια πρόταση που πρέπει να γίνει διακριτική στο επόμενο βήμα.
- Εδώ δημιουργείται ένα αντικείμενο για το PorterStemmer.
- Εκτελείται ένας βρόχος και η δημιουργία ρίζας κάθε λέξης γίνεται χρησιμοποιώντας το αντικείμενο που δημιουργήθηκε στη γραμμή κώδικα 5.
Εν ολίγοις, η stemming είναι μια ενότητα προεπεξεργασίας δεδομένων. Η αγγλική γλώσσα έχει πολλές παραλλαγές μιας μόνο λέξης, οι οποίες δημιουργούν ασάφεια στην εκπαίδευση και την πρόβλεψη μηχανικής μάθησης. Για να δημιουργήσετε ένα επιτυχημένο μοντέλο, είναι ζωτικής σημασίας να φιλτράρετε τέτοιες λέξεις στα ίδια αλληλουχημένα δεδομένα χρησιμοποιώντας stemming. Αυτό είναι επίσης γνωστό ως ομαλοποίηση.
Τι είναι η Λεμματοποίηση;
Εξευγενισμός Στο NLTK, η αλγοριθμική διαδικασία εύρεσης του λήματος μιας λέξης ανάλογα με τη σημασία και τα συμφραζόμενά της είναι η αλγοριθμική διαδικασία εύρεσης του λήματος μιας λέξης ανάλογα με τη σημασία και τα συμφραζόμενά της. Η λημματοποίηση συνήθως αναφέρεται στη μορφολογική ανάλυση των λέξεων, η οποία στοχεύει στην αφαίρεση των κλιτικών καταλήξεων. Βοηθά στην επιστροφή της βάσης ή της λεξικής μορφής μιας λέξης, γνωστής ως λήμμα. Η μέθοδος λημματοποίησης NLTK βασίζεται στην ενσωματωμένη συνάρτηση μορφοποίησης του WordNet. Η προεπεξεργασία κειμένου περιλαμβάνει τόσο την υιοθέτηση θεμάτων όσο και τη λημματοποίηση. Πολλοί άνθρωποι βρίσκουν τους δύο όρους συγκεχυμένους. Κάποιοι τους αντιμετωπίζουν ως ίδιους, αλλά υπάρχει μια διαφορά μεταξύ της υιοθέτησης θεμάτων και της λημματοποίησης. Η λημματοποίηση προτιμάται από την πρώτη για τον παρακάτω λόγο.
Γιατί το Lemmatization είναι καλύτερο από το Stemming;
Ο αλγόριθμος δημιουργίας ριζών λειτουργεί κόβοντας το επίθημα από τη λέξη. Με μια ευρύτερη έννοια, κόβει είτε την αρχή είτε το τέλος της λέξης. Αντίθετα, η Λημματοποίηση είναι μια πιο ισχυρή λειτουργία και λαμβάνει υπόψη τη μορφολογική ανάλυση των λέξεων. Επιστρέφει το λήμμα, το οποίο είναι η βασική μορφή όλων των κλιτικών μορφών της. Απαιτείται εις βάθος γλωσσική γνώση για τη δημιουργία λεξικών και την αναζήτηση της σωστής μορφής της λέξης. Η δημιουργία ριζών είναι μια γενική λειτουργία, ενώ η λημματοποίηση είναι μια έξυπνη λειτουργία όπου η σωστή μορφή αναζητείται στο λεξικό. Ως εκ τούτου, η λημματοποίηση βοηθά στη διαμόρφωση καλύτερων μάθηση μηχανής χαρακτηριστικά.
Code να διακρίνουν μεταξύ Λημματοποίησης και Βλαστοποίησης
Βλάστηση Code:
import nltk
from nltk.stem.porter import PorterStemmer
porter_stemmer  = PorterStemmer()
text = "studies studying cries cry"
tokenization = nltk.word_tokenize(text)
for w in tokenization:
print("Stemming for {} is {}".format(w,porter_stemmer.stem(w)))
Παραγωγή:
Stemming for studies is studi
Stemming for studying is studi
Stemming for cries is cri
Stemming for cry is cri
Εξευγενισμός Code:
import nltk
	from nltk.stem import 	WordNetLemmatizer
	wordnet_lemmatizer = WordNetLemmatizer()
	text = "studies studying cries cry"
	tokenization = nltk.word_tokenize(text)
	 for w in tokenization:
		print("Lemma for {} is {}".format(w, wordnet_lemmatizer.lemmatize(w)))
Παραγωγή:
Lemma for studies is study
Lemma for studying is studying
Lemma for cries is cry
Lemma for cry is cry
Συζήτηση του Output
Αν εξετάσουμε την stemming για studies και την studying, η έξοδος είναι η ίδια (studi), αλλά ο λημματοποιητής NLTK παρέχει διαφορετικό λήμμα και για τα δύο διακριτικά: study for studies και study for study. Έτσι, όταν χρειάζεται να δημιουργήσουμε ένα σύνολο χαρακτηριστικών για την εκπαίδευση μιας μηχανής, θα ήταν υπέροχο να προτιμηθεί η λημματοποίηση.
Χρήση Case of Lemmatizer
Ο Λημματοποιητής ελαχιστοποιεί την ασάφεια του κειμένου. Λέξεις όπως ποδήλατο ή ποδήλατα μετατρέπονται στη βασική λέξη ποδήλατο. Μετατρέπει όλες τις λέξεις με την ίδια σημασία αλλά διαφορετική αναπαράσταση στη βασική τους μορφή, μειώνοντας την πυκνότητα των λέξεων και τη βοήθεια.ping προετοιμάστε ακριβή χαρακτηριστικά για την εκπαίδευση μιας μηχανής. Όσο πιο καθαρά είναι τα δεδομένα, τόσο πιο ακριβές θα είναι το μοντέλο μηχανικής μάθησης. Ο Λημματοποιητής NLTK εξοικονομεί επίσης μνήμη και υπολογιστικό κόστος.
Παράδειγμα σε πραγματικό χρόνο που δείχνει τη χρήση της Λημματοποίησης WordNet και της Ετικέτας POS σε Python:
from nltk.corpus import wordnet as wn
	from nltk.stem.wordnet import WordNetLemmatizer
	from nltk import word_tokenize, pos_tag
	from collections import defaultdict
	tag_map = defaultdict(lambda : wn.NOUN)
	tag_map['J'] = wn.ADJ
	tag_map['V'] = wn.VERB
	tag_map['R'] = wn.ADV
	text = "guru99 is a totally new kind of learning experience."
	tokens = word_tokenize(text)
	lemma_function = WordNetLemmatizer()
	for token, tag in pos_tag(tokens):
		lemma = lemma_function.lemmatize(token, tag_map[tag[0]])
		print(token, "=>", lemma)
Παραγωγή:
guru99 => guru99
is => be
totally => totally
new => new
kind => kind
of => of
learning => learn
experience => experience
. => .
Code Επεξήγηση:
- Το πρόγραμμα ανάγνωσης corpus wordnet εισάγεται και το WordNetLemmatizer εισάγεται από το wordnet.
- Η ετικέτα Word tokenize και η ετικέτα μερών λόγου εισάγονται από το nltk και το Default Dictionary από συλλογές.
- Δημιουργείται ένα λεξικό όπου το πρώτο γράμμα του pos_tag είναι το κλειδί, το οποίο αντιστοιχίζεται στην τιμή από το λεξικό wordnet.
- Το κείμενο γράφεται και μετατρέπεται σε token, και το αντικείμενο lemma_function δημιουργείται για χρήση μέσα στον βρόχο.
- Ο βρόχος εκτελείται και η συνάρτηση lemmatize δέχεται δύο ορίσματα: το διακριτικό και έναν χάρτηping του pos_tag με την τιμή wordnet.
Python Η λημματοποίηση έχει στενή σχέση με την Λεξικό WordNet, επομένως είναι απαραίτητο να μελετήσουμε αυτό το θέμα στη συνέχεια.
