
Τι είναι η Ενισχυτική Μάθηση; Τύποι, Algorithms & Παράδειγμα
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Η Ενισχυτική Μάθηση είναι μια μέθοδος μηχανικής μάθησης στην οποία ένας πράκτορας λογισμικού μαθαίνει ενεργώντας μέσα σε ένα περιβάλλον, συλλέγοντας ανταμοιβές ή ποινές και προσαρμόζοντας τη συμπεριφορά του για να μεγιστοποιήσει τη σωρευτική ανταμοιβή σε πολλά βήματα.
Τι είναι η Ενισχυτική Μάθηση;
Μάθηση Ενίσχυσης είναι ένα Μηχανική μάθηση Μέθοδος που ασχολείται με τον τρόπο με τον οποίο οι πράκτορες λογισμικού πρέπει να αναλαμβάνουν ενέργειες σε ένα περιβάλλον. Στον πράκτορα δεν εμφανίζονται σωστές απαντήσεις. Μαθαίνει από την ανταμοιβή που λαμβάνει και προσαρμόζει τη συμπεριφορά του για να μεγιστοποιήσει τη σωρευτική ανταμοιβή.
Η Ενισχυτική Μάθηση είναι ένας κλάδος της μηχανικής μάθησης από μόνη της, παράλληλα με εποπτεία και χωρίς επίβλεψη μάθηση. Όταν η πολιτική ή η συνάρτηση τιμής του πράκτορα αναπαρίσταται από ένα νευρωνικό δίκτυο, ο συνδυασμός ονομάζεται μάθηση βαθιάς ενίσχυσης — ότι η σύζευξη είναι αυτό που επιτρέπει σε έναν πράκτορα να επιτύχει έναν σύνθετο στόχο ή να μεγιστοποιήσει μια συγκεκριμένη διάσταση σε πολλά βήματα.
Σημαντικά Στοιχεία της Μεθόδου Ενισχυτικής Μάθησης
Πριν οι αλγόριθμοι βγάλουν νόημα, είναι χρήσιμο να ονομάσουμε τα κομμάτια. Το παρακάτω διάγραμμα δείχνει πώς ο πράκτορας, το περιβάλλον, η δράση και το σήμα ανταμοιβής ταιριάζουν σε έναν βρόχο.
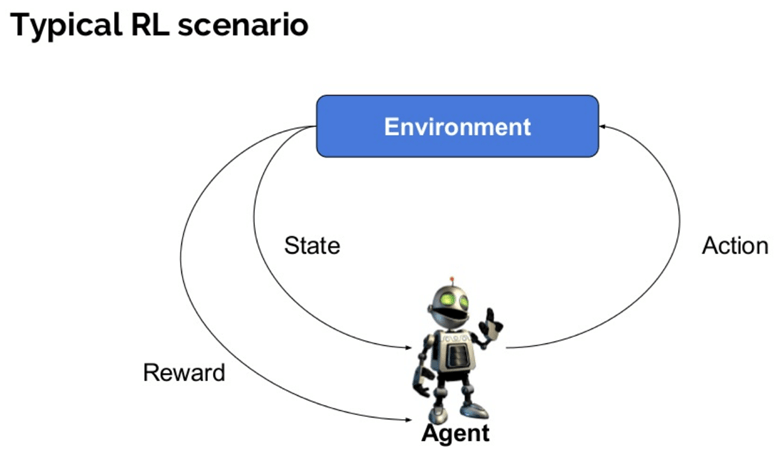
Ακολουθούν ορισμένοι σημαντικοί όροι που χρησιμοποιούνται στην Ενισχυτική Μάθηση:
- Μέσο: Η οντότητα που εκτελεί ενέργειες σε ένα περιβάλλον για να αποκομίσει κάποια ανταμοιβή.
- Περιβάλλον (ε): Ένα σενάριο που πρέπει να αντιμετωπίσει ένας πράκτορας.
- Ανταμοιβή (R): Μια άμεση ανταπόδοση που δίνεται σε έναν πράκτορα όταν εκτελεί μια συγκεκριμένη ενέργεια ή εργασία.
- Πολιτεία (ες): Το κράτος αναφέρεται στην τρέχουσα κατάσταση που επιστρέφει το περιβάλλον.
- Πολιτική (π): Η στρατηγική που εφαρμόζει ο πράκτορας για να αποφασίσει την επόμενη ενέργεια με βάση την τρέχουσα κατάσταση.
- Τιμή (V): Η αναμενόμενη μακροπρόθεσμη απόδοση με έκπτωση, σε σύγκριση με τη βραχυπρόθεσμη ανταμοιβή.
- Συνάρτηση τιμής: Καθορίζει την αξία μιας κατάστασης, δηλαδή το συνολικό ποσό ανταμοιβής που ένας πράκτορας μπορεί να αναμένει να συσσωρεύσει ξεκινώντας από αυτήν την κατάσταση.
- Μοντέλο περιβάλλοντος: Αυτό μιμείται τη συμπεριφορά του περιβάλλοντος. Σας επιτρέπει να κάνετε συμπεράσματα και επίσης να καθορίσετε πώς θα συμπεριφερθεί το περιβάλλον.
- Μέθοδοι που βασίζονται σε μοντέλα: Μέθοδοι που επιλύουν προβλήματα ενισχυτικής μάθησης μαθαίνοντας πρώτα ή χρησιμοποιώντας ένα μοντέλο του περιβάλλοντος και στη συνέχεια σχεδιάζοντας εναντίον του.
- Τιμή Q ή τιμή ενέργειας (Q): Η τιμή Q είναι αρκετά παρόμοια με την τιμή. Η μόνη διαφορά μεταξύ των δύο είναι ότι δέχεται μια επιπλέον παράμετρο, την τρέχουσα ενέργεια.
Πώς λειτουργεί η Ενισχυτική Μάθηση;
Μια καθημερινή αναλογία καθιστά σαφή τον μηχανισμό πριν εμφανιστεί οποιαδήποτε σημειογραφία.
Σκεφτείτε το σενάριο να διδάξετε νέα κόλπα στη γάτα σας.
- Καθώς η γάτα δεν καταλαβαίνει αγγλικά ή κάποια άλλη ανθρώπινη γλώσσα, δεν μπορούμε να της πούμε απευθείας τι να κάνει. Αντίθετα, ακολουθούμε μια διαφορετική στρατηγική.
- Μιμούμαστε μια κατάσταση και η γάτα προσπαθεί να αντιδράσει με πολλούς διαφορετικούς τρόπους. Αν η αντίδραση της γάτας είναι η επιθυμητή, της δίνουμε ψάρι.
- Τώρα, κάθε φορά που η γάτα εκτίθεται στην ίδια κατάσταση, εκτελεί μια παρόμοια ενέργεια με ακόμα πιο ενθουσιασμό, περιμένοντας να λάβει περισσότερη ανταμοιβή (φαγητό).
- Αυτή είναι η μάθηση που παίρνει η γάτα για το «τι να κάνει» από θετικές εμπειρίες.
- Ταυτόχρονα, η γάτα μαθαίνει επίσης τι δεν πρέπει να κάνει όταν αντιμετωπίζει αρνητικές εμπειρίες.
Παράδειγμα Ενισχυτικής Μάθησης
Το παρακάτω σχήμα αντιστοιχίζει την ιστορία της γάτας στον επίσημο βρόχο, με το νοικοκυριό ως το περιβάλλον και το ψάρι ως την ανταμοιβή.
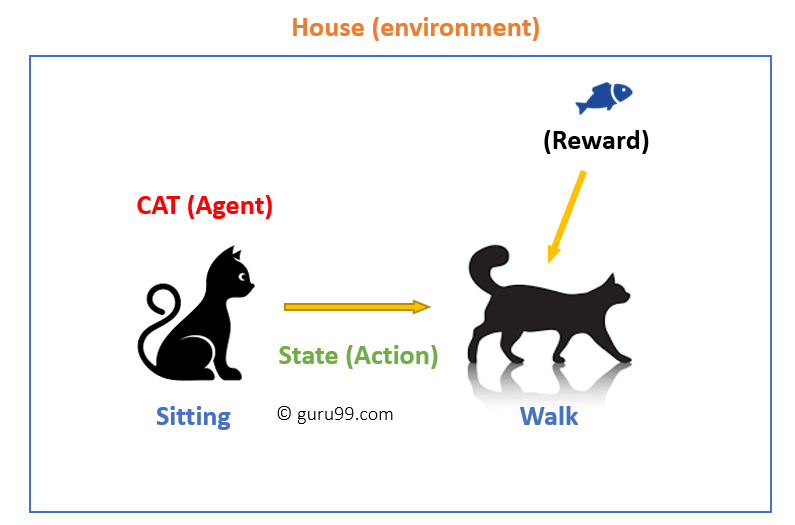
Στην περίπτωση αυτή,
- Η γάτα σας είναι ένας παράγοντας που εκτίθεται στο περιβάλλον. Σε αυτήν την περίπτωση, είναι το σπίτι σας. Ένα παράδειγμα κατάστασης θα μπορούσε να είναι η γάτα σας να κάθεται και εσείς να χρησιμοποιείτε μια συγκεκριμένη λέξη για να την κάνετε να περπατήσει.
- Ο αντιπρόσωπός μας αντιδρά εκτελώντας μια μετάβαση ενέργειας από μια "κατάσταση" σε μια άλλη "κατάσταση".
- Για παράδειγμα, η γάτα σας πηγαίνει από το να κάθεται στο περπάτημα.
- Η αντίδραση ενός πράκτορα είναι μια ενέργεια και η πολιτική είναι μια μέθοδος επιλογής μιας ενέργειας δεδομένης μιας κατάστασης με προσδοκία καλύτερων αποτελεσμάτων.
- Μετά τη μετάβαση, ο πράκτορας μπορεί να λάβει μια ανταμοιβή ή μια ποινή σε αντάλλαγμα.
Μάθηση Ενίσχυσης Algorithms
Υπάρχουν τρεις προσεγγίσεις για την υλοποίηση ενός αλγορίθμου Ενισχυτικής Μάθησης και διαφέρουν κυρίως ως προς το τι αποθηκεύει και μαθαίνει ο πράκτορας.
Βάσει αξίας
Σε μια μέθοδο Ενισχυτικής Μάθησης που βασίζεται σε τιμές, προσπαθείτε να μεγιστοποιήσετε μια συνάρτηση τιμής V(s). Σε αυτήν τη μέθοδο, ο πράκτορας αναμένει μια μακροπρόθεσμη απόδοση των τρεχουσών καταστάσεων υπό την πολιτική π.
Με βάση την πολιτική
Σε μια μέθοδο RL που βασίζεται σε πολιτικές, προσπαθείτε να καταλήξετε σε μια πολιτική τέτοια ώστε η ενέργεια που εκτελείται σε κάθε κατάσταση να σας βοηθά να αποκομίσετε τη μέγιστη ανταμοιβή στο μέλλον.
Δύο τύποι μεθόδων που βασίζονται σε πολιτικές είναι:
- Ντετερμινιστική: Για κάθε κατάσταση, η ίδια ενέργεια παράγεται από την πολιτική π.
- Στοχαστικό: Κάθε ενέργεια έχει μια συγκεκριμένη πιθανότητα, η οποία δίνεται από την ακόλουθη εξίσωση.
Στοχαστική πολιτική:
π(a|s) = P[At = a | St = s]
Με βάση το μοντέλο
Σε αυτήν τη μέθοδο Ενισχυτικής Μάθησης, δημιουργείτε ένα εικονικό μοντέλο για κάθε περιβάλλον. Ο πράκτορας μαθαίνει να λειτουργεί σε αυτό το συγκεκριμένο περιβάλλον.
Χαρακτηριστικά της Ενισχυτικής Μάθησης
Ακολουθούν τα σημαντικά χαρακτηριστικά της ενισχυτικής μάθησης:
- Δεν υπάρχει επόπτης, μόνο πραγματικός αριθμός ή σήμα ανταμοιβής
- Διαδοχική λήψη αποφάσεων
- Ο χρόνος παίζει καθοριστικό ρόλο στα προβλήματα Ενίσχυσης
- Η ανατροφοδότηση είναι συχνά καθυστερημένη και όχι άμεση
- Οι ενέργειες του πράκτορα καθορίζουν τα επόμενα δεδομένα που λαμβάνει
Τύποι Ενισχυτικής Μάθησης
Η λέξη «ενίσχυση» δανείζεται από την ψυχολογία συμπεριφοράς και εμφανίζεται σε δύο μορφές:
Θετικός:
Ορίζεται ως ένα συμβάν που συμβαίνει λόγω μιας συγκεκριμένης συμπεριφοράς. Αυξάνει την ισχύ και τη συχνότητα της συμπεριφοράς και επηρεάζει θετικά τη δράση που αναλαμβάνει ο δράστης.
Αυτός ο τύπος ενίσχυσης σάς βοηθά να μεγιστοποιήσετε την απόδοση και να διατηρήσετε την αλλαγή για μεγαλύτερο χρονικό διάστημα. Ωστόσο, η υπερβολική ενίσχυση μπορεί να οδηγήσει σε υπερβολική βελτιστοποίηση της κατάστασης, η οποία μπορεί να επηρεάσει τα αποτελέσματα.
Αρνητικός:
Η αρνητική ενίσχυση ορίζεται ως η ενδυνάμωση μιας συμπεριφοράς που προκύπτει λόγω μιας αρνητικής συνθήκης που θα έπρεπε να είχε σταματήσει ή να αποφευχθεί. Σας βοηθά να ορίσετε το ελάχιστο πρότυπο απόδοσης. Ωστόσο, το μειονέκτημα αυτής της μεθόδου είναι ότι παρέχει μόνο όσα απαιτούνται για την επίτευξη του ελάχιστου επιπέδου συμπεριφοράς.
Μαθησιακά Μοντέλα Ενίσχυσης
Υπάρχουν δύο σημαντικά μοντέλα μάθησης στην ενισχυτική μάθηση:
- Διαδικασία απόφασης Markov
- Q εκμάθηση
Διαδικασία απόφασης Markov
Οι ακόλουθες παράμετροι χρησιμοποιούνται για τη λήψη μιας λύσης:
- Σύνολο ενεργειών – Α
- Σύνολο καταστάσεων – S
- Ανταμοιβή – R
- Πολιτική – π
- Αξία – V
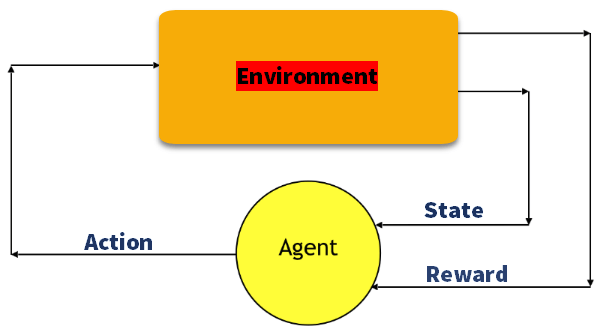
Η μαθηματική προσέγγιση για τον χάρτηping Μια λύση στην Ενισχυτική Μάθηση τυποποιείται ως Διαδικασία Απόφασης Markov ή MDP. Το παρακάτω σχηματικό δείχνει αυτές τις πέντε παραμέτρους που συνδέονται στον ίδιο κύκλο πράκτορα-περιβάλλοντος.
Q-Εκμάθηση
Η Q μάθηση είναι μια μέθοδος παροχής πληροφοριών που βασίζεται σε αξίες και υποδεικνύει σε έναν πράκτορα ποια ενέργεια να κάνει.
Ας κατανοήσουμε αυτήν τη μέθοδο με το ακόλουθο παράδειγμα:
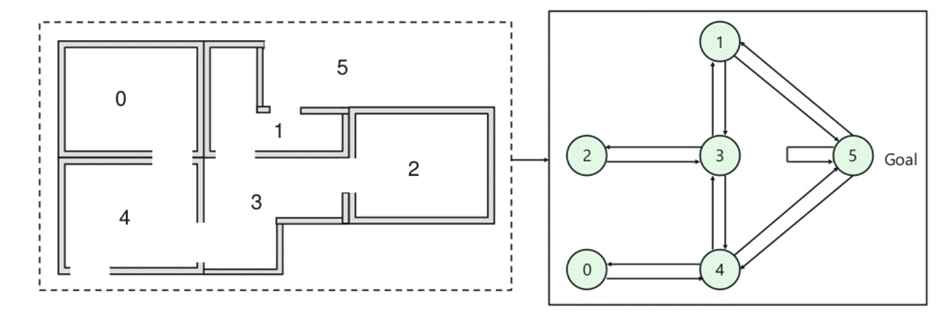
- Υπάρχουν πέντε δωμάτια σε ένα κτίριο που συνδέονται με πόρτες.
- Κάθε δωμάτιο αριθμείται από το 0 έως το 4
- Το εξωτερικό του κτιρίου μπορεί να αντιμετωπιστεί ως ένας μεγάλος εξωτερικός χώρος (5)
- Οι πόρτες 1 και 4 οδηγούν στο κτίριο από το δωμάτιο 5
Η παρακάτω κάτοψη αριθμεί αυτά τα δωμάτια και δείχνει ποιες πόρτες τα συνδέουν.
Στη συνέχεια, πρέπει να συσχετίσετε μια τιμή ανταμοιβής με κάθε πόρτα:
- Οι πόρτες που οδηγούν απευθείας στον στόχο έχουν ανταμοιβή 100
- Οι πόρτες που δεν συνδέονται απευθείας με το δωμάτιο-στόχο δεν δίνουν καμία ανταμοιβή.
- Καθώς οι πόρτες είναι διπλής κατεύθυνσης, έχουν αντιστοιχιστεί δύο βέλη για κάθε δωμάτιο.
- Κάθε βέλος στην παραπάνω εικόνα φέρει μια άμεση αξία ανταμοιβής
Επεξήγηση: Σε αυτήν την εικόνα, κάθε δωμάτιο αντιπροσωπεύει μια κατάσταση και η μετακίνηση του πράκτορα από το ένα δωμάτιο στο άλλο αντιπροσωπεύει μια ενέργεια.
Στο παρακάτω γράφημα, μια κατάσταση σχεδιάζεται ως κόμβος, ενώ τα βέλη δείχνουν τις διαθέσιμες ενέργειες και την ανταμοιβή που συνδέεται με καθεμία από αυτές.

Για παράδειγμα, ένας πράκτορας διασχίζει το δωμάτιο 2 με το δωμάτιο 5:
- Αρχική κατάσταση = κατάσταση 2
- Κατάσταση 2-> κατάσταση 3
- Κατάσταση 3 -> κατάσταση (2,1,4)
- Κατάσταση 4-> κατάσταση (0,5,3)
- Κατάσταση 1-> κατάσταση (5,3)
- Κατάσταση 0-> κατάσταση 4
Ενισχυτική μάθηση έναντι εποπτευόμενης μάθησης
Ο σαφέστερος τρόπος για να τοποθετήσουμε την Ενισχυτική Μάθηση είναι να την θέσουμε εκτός του παραδείγματος που ήδη γνωρίζουν οι περισσότεροι αναγνώστες.
| Παράμετροι | Μάθηση Ενίσχυσης | Εποπτευόμενη μάθηση |
|---|---|---|
| Στυλ απόφασης | Η Ενισχυτική Μάθηση σας βοηθά να παίρνετε τις αποφάσεις σας διαδοχικά. | Σε αυτή τη μέθοδο, λαμβάνεται μια απόφαση σχετικά με την είσοδο που δίνεται στην αρχή. |
| Λειτουργεί | Λειτουργεί αλληλεπιδρώντας με το περιβάλλον. | Λειτουργεί σε παραδείγματα ή δεδομένα δείγματος. |
| Εξάρτηση από την απόφαση | Στη μέθοδο RL, κάθε απόφαση μάθησης εξαρτάται από τις προηγούμενες, επομένως ολόκληρη η ακολουθία αποφάσεων είναι αυτή που αξιολογείται. | In εποπτευόμενη μάθηση Οι αποφάσεις είναι ανεξάρτητες η μία από την άλλη, επομένως δίνεται μια ετικέτα για κάθε απόφαση. |
| καλυτερα suited | Υποστηρίζει και λειτουργεί καλύτερα στην Τεχνητή Νοημοσύνη, όπου η ανθρώπινη αλληλεπίδραση είναι διαδεδομένη. | Λειτουργεί κυρίως με ένα διαδραστικό σύστημα λογισμικού ή εφαρμογές. |
| Παράδειγμα | Παιχνίδι σκακιού | Αναγνώριση αντικειμένων |
Εφαρμογές Ενισχυτικής Μάθησης
Ακολουθούν οι εφαρμογές της Ενισχυτικής Μάθησης:
- Ρομποτική για βιομηχανικούς αυτοματισμούς.
- Σχεδιασμός επιχειρηματικής στρατηγικής
- Μηχανική μάθηση και επεξεργασία δεδομένων
- Σας βοηθά να δημιουργήσετε συστήματα εκπαίδευσης που παρέχουν προσαρμοσμένη διδασκαλία και υλικό σύμφωνα με τις απαιτήσεις των μαθητών.
- Έλεγχος αεροσκαφών και έλεγχος κίνησης ρομπότ
Γιατί να χρησιμοποιήσετε την Ενισχυτική Μάθηση;
Ακολουθούν οι κύριοι λόγοι για τη χρήση της Ενισχυτικής Μάθησης:
- Σας βοηθά να εντοπίσετε ποια κατάσταση χρειάζεται δράση
- Σας βοηθά να ανακαλύψετε ποια ενέργεια αποφέρει την υψηλότερη ανταμοιβή σε μεγαλύτερο χρονικό διάστημα
- Η Ενισχυτική Μάθηση παρέχει επίσης στον μαθησιακό παράγοντα μια συνάρτηση ανταμοιβής.
- Επιτρέπει επίσης στον πράκτορα να βρει την καλύτερη μέθοδο για την απόκτηση μεγάλων ανταμοιβών.
Πότε να μην χρησιμοποιείτε την Ενισχυτική Μάθηση;
Δεν μπορείτε να εφαρμόσετε ένα μοντέλο ενισχυτικής μάθησης σε κάθε περίπτωση. Ακολουθούν ορισμένες περιπτώσεις στις οποίες δεν πρέπει να το χρησιμοποιείτε.
- Όταν έχετε αρκετά δεδομένα με ετικέτες για να λύσετε το πρόβλημα με μια μέθοδο εποπτευόμενης μάθησης
- Η Ενισχυτική Μάθηση απαιτεί πολλούς υπολογισμούς και είναι χρονοβόρα, ιδιαίτερα όταν ο χώρος δράσης είναι μεγάλος.
Προκλήσεις της Ενισχυτικής Μάθησης
Ακολουθούν οι σημαντικότερες προκλήσεις που θα αντιμετωπίσετε κατά την Ενισχυτική Μάθηση:
- Σχεδιασμός χαρακτηριστικών και ανταμοιβών, ο οποίος μπορεί να είναι πολύπλοκος
- Οι παράμετροι μπορεί να επηρεάσουν την ταχύτητα εκμάθησης.
- Τα ρεαλιστικά περιβάλλοντα μπορούν να έχουν μερική παρατηρησιμότητα.
- Η υπερβολική ενίσχυση μπορεί να οδηγήσει σε υπερφόρτωση καταστάσεων, η οποία μπορεί να μειώσει τα αποτελέσματα.
- Τα ρεαλιστικά περιβάλλοντα μπορεί να είναι μη ακίνητα.
