
MongoDB Κανονική έκφραση ($regex) με παραδείγματα
 Στίβεν Τουέιν
⚡ Έξυπνη Σύνοψη
MongoDB Οι κανονικές εκφράσεις εκτελούν αντιστοίχιση μοτίβων για να βρουν συμβολοσειρές μέσα σε έγγραφα, χρησιμοποιώντας τον τελεστή $regex, τη σημαία $options για έλλειψη ευαισθησίας πεζών-κεφαλαίων, τις αγκυρώσεις για ακριβείς αντιστοιχίσεις και τους οριοθέτες κάθετου όταν η ακριβής τιμή πεδίου είναι άγνωστη.
Οι κανονικές εκφράσεις χρησιμοποιούνται για την αντιστοίχιση μοτίβων, η οποία ουσιαστικά αφορά την εύρεση συμβολοσειρών μέσα σε έγγραφα.
Μερικές φορές κατά την ανάκτηση εγγράφων σε μια συλλογή, ενδέχεται να μην γνωρίζετε ακριβώς ποια είναι η ακριβής τιμή πεδίου για αναζήτηση. Ως εκ τούτου, μπορεί κανείς να χρησιμοποιήσει κανονικές εκφράσεις για να βοηθήσει στην ανάκτηση δεδομένων με βάση τις τιμές αναζήτησης που ταιριάζουν με μοτίβο.
Χρήση τελεστή $regex για αντιστοίχιση μοτίβων
Ο τελεστής $regex στο MongoDB χρησιμοποιείται για την αναζήτηση συγκεκριμένων συμβολοσειρών στη συλλογή. Το παρακάτω παράδειγμα δείχνει πώς μπορεί να γίνει αυτό.
Ας υποθέσουμε ότι έχουμε την ίδια συλλογή Υπαλλήλων που έχει τα ονόματα πεδίων "Employeeid" και "EmployeeName". Ας υποθέσουμε επίσης ότι έχουμε τα ακόλουθα έγγραφα στη συλλογή μας.
| Ταυτότητα Υπαλλήλου | όνομα υπαλλήλου |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Γκουράνγκ |
Εδώ στον παρακάτω κώδικα χρησιμοποιήσαμε τον τελεστή $regex για να καθορίσουμε τα κριτήρια αναζήτησης.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Επεξήγηση:
- Εδώ θέλουμε να βρούμε όλα τα ονόματα υπαλλήλων που περιέχουν τους χαρακτήρες 'Gu'. Ως εκ τούτου, καθορίζουμε τον τελεστή $regex για να ορίσουμε τα κριτήρια αναζήτησης του 'Gu'.
- Το printjson χρησιμοποιείται για την εκτύπωση κάθε εγγράφου που επιστρέφεται από το ερώτημα με καλύτερο τρόπο.
Εάν η εντολή εκτελεστεί με επιτυχία, θα εμφανιστεί η ακόλουθη έξοδος:
Παραγωγή:

Η έξοδος δείχνει ξεκάθαρα ότι επιστρέφονται εκείνα τα έγγραφα στα οποία το Όνομα Υπαλλήλου περιέχει τους χαρακτήρες «Gu».
Αν υποθέσουμε ότι η συλλογή σας περιέχει τα ακόλουθα έγγραφα με ένα επιπλέον έγγραφο που περιείχε το Όνομα Υπαλλήλου ως "Guru999”. Εάν εισαγάγατε τα κριτήρια αναζήτησης ως «Guru99", θα επέστρεφε επίσης το έγγραφο που είχε «Guru999". Αλλά ας υποθέσουμε ότι δεν το θέλαμε αυτό και θέλαμε μόνο να επιστρέψουμε το έγγραφο με "Guru99”. Στη συνέχεια, μπορούμε να το κάνουμε αυτό με ακριβή αντιστοίχιση μοτίβων. Για να κάνουμε ακριβή αντιστοίχιση μοτίβων, θα χρησιμοποιήσουμε τους χαρακτήρες ^ και $. Θα προσθέσουμε τον χαρακτήρα ^ στην αρχή της συμβολοσειράς και το $ στο τέλος της συμβολοσειράς.
| Ταυτότητα Υπαλλήλου | όνομα υπαλλήλου |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Γκουράνγκ |
| 8 | Guru999 |
Το παρακάτω παράδειγμα δείχνει πώς μπορεί να γίνει αυτό.
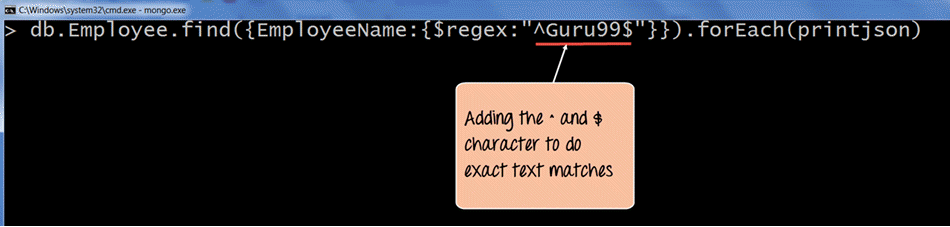
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Επεξήγηση:
- Εδώ στα κριτήρια αναζήτησης, χρησιμοποιούμε τους χαρακτήρες ^ και $. Το ^ χρησιμοποιείται για να διασφαλιστεί ότι η συμβολοσειρά ξεκινά με έναν συγκεκριμένο χαρακτήρα και το $ χρησιμοποιείται για να διασφαλιστεί ότι η συμβολοσειρά τελειώνει με έναν συγκεκριμένο χαρακτήρα. Έτσι, όταν εκτελεστεί ο κώδικας, θα ανακτήσει μόνο τη συμβολοσειρά με το όνομα "Guru99. "
- Το printjson χρησιμοποιείται για την εκτύπωση κάθε εγγράφου που επιστρέφεται από το ερώτημα με καλύτερο τρόπο.
Εάν η εντολή εκτελεστεί με επιτυχία, θα εμφανιστεί η ακόλουθη έξοδος:
Παραγωγή:
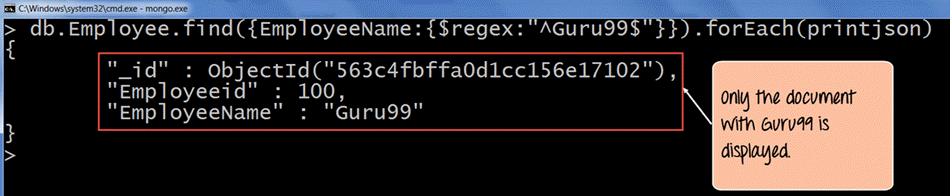
Στην έξοδο, είναι σαφώς ορατή η συμβολοσειρά "Guru99" είναι προσβάσιμο.
Αντιστοίχιση μοτίβων με $επιλογές
Όταν χρησιμοποιείτε τον τελεστή $regex, μπορείτε επίσης να παρέχετε πρόσθετες επιλογές χρησιμοποιώντας τον τελεστή $επιλογές λέξη-κλειδί. Για παράδειγμα, ας υποθέσουμε ότι θέλετε να βρείτε όλα τα έγγραφα που είχαν "Gu" στο Όνομα Υπαλλήλου τους, ανεξάρτητα από το αν ήταν διάκριση πεζών-κεφαλαίων ή χωρίς διάκριση. Εάν επιθυμούμε ένα τέτοιο αποτέλεσμα, τότε πρέπει να χρησιμοποιήσουμε το $επιλογές με την παράμετρο αναισθησίας πεζών-κεφαλαίων.
Το παρακάτω παράδειγμα δείχνει πώς μπορεί να γίνει αυτό.
Ας υποθέσουμε ότι έχουμε την ίδια συλλογή υπαλλήλων που έχει τα ονόματα πεδίων "Employeeid" και "EmployeeName".
Ας υποθέσουμε επίσης ότι έχουμε τα ακόλουθα έγγραφα στη συλλογή μας.
| Ταυτότητα Υπαλλήλου | όνομα υπαλλήλου |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Γκουράνγκ |
| 7 | GURU99 |
Τώρα, αν εκτελέσουμε το ίδιο ερώτημα όπως στο προηγούμενο θέμα, δεν θα δούμε ποτέ το έγγραφο με το "GURU99" στο αποτέλεσμα. Για να διασφαλίσουμε ότι αυτό θα περιλαμβάνεται στο σύνολο αποτελεσμάτων, πρέπει να προσθέσουμε την παράμετρο $options "i".
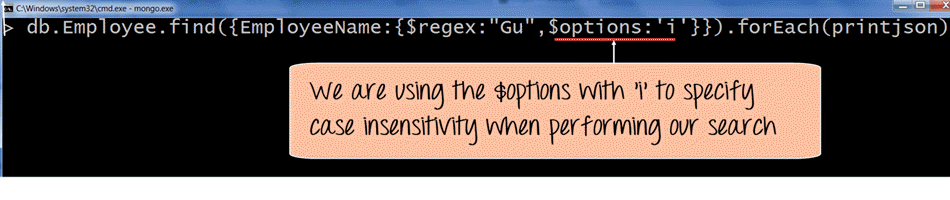
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Επεξήγηση:
- Οι επιλογές $με την παράμετρο 'i' (που σημαίνει έλλειψη ευαισθησίας πεζών-κεφαλαίων) καθορίζουν ότι θέλουμε να πραγματοποιήσουμε την αναζήτηση ανεξάρτητα από το αν βρούμε τα γράμματα 'Gu' με πεζά ή κεφαλαία γράμματα.
Εάν η εντολή εκτελεστεί με επιτυχία, θα εμφανιστεί η ακόλουθη έξοδος:
Παραγωγή:
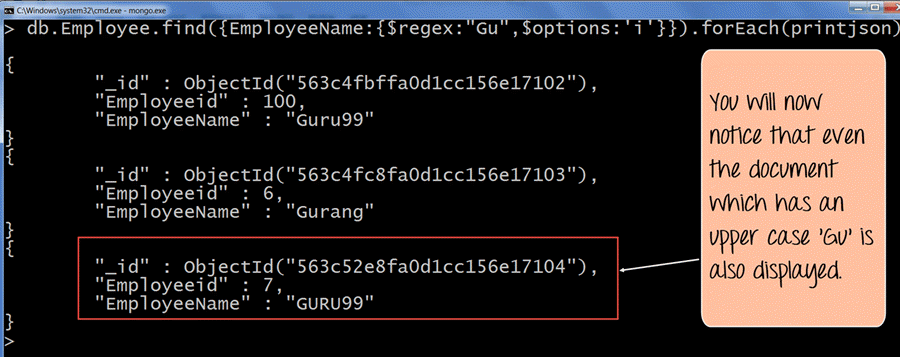
- Το αποτέλεσμα δείχνει ξεκάθαρα ότι παρόλο που ένα έγγραφο έχει κεφαλαίο γράμμα «Gu», το έγγραφο εξακολουθεί να εμφανίζεται στο σύνολο αποτελεσμάτων.
Αντιστοίχιση μοτίβου χωρίς τον τελεστή regex
Μπορεί επίσης να γίνει αντιστοίχιση μοτίβων χωρίς τον τελεστή $regex. Το ακόλουθο παράδειγμα δείχνει πώς μπορεί να γίνει αυτό.
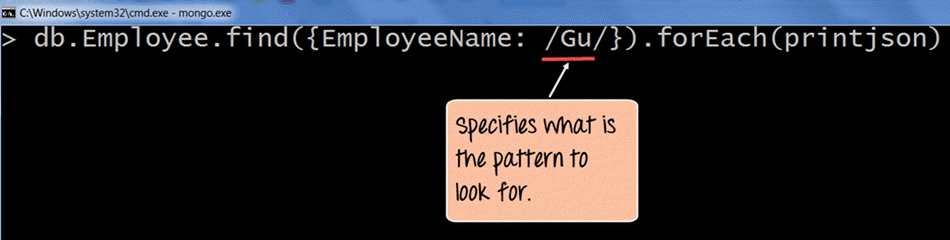
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Επεξήγηση:
- Οι οριοθέτες "//" ουσιαστικά σημαίνουν ότι καθορίζουν τα κριτήρια αναζήτησής σας μέσα σε αυτούς τους οριοθέτες. Επομένως, καθορίζουμε /Gu/ για να βρούμε ξανά εκείνα τα έγγραφα που έχουν 'Gu' στο Όνομα Εργαζομένου τους.
Εάν η εντολή εκτελεστεί με επιτυχία, θα εμφανιστεί η ακόλουθη έξοδος:
Παραγωγή:
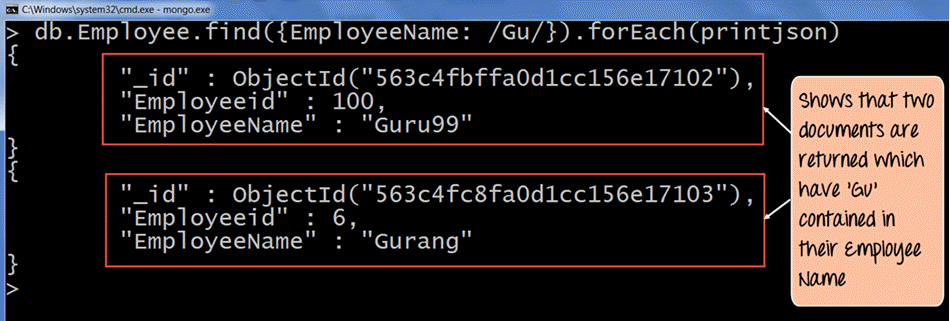
Η έξοδος δείχνει ξεκάθαρα ότι επιστρέφονται εκείνα τα έγγραφα στα οποία το Όνομα Υπαλλήλου περιέχει τους χαρακτήρες «Gu».
Λήψη των τελευταίων «n» εγγράφων από μια συλλογή
Υπάρχουν διάφοροι τρόποι για να λάβετε τα τελευταία n έγγραφα σε μια συλλογή.
Ας δούμε έναν από τους τρόπους μέσω των παρακάτω βημάτων.
Το παρακάτω παράδειγμα δείχνει πώς μπορεί να γίνει αυτό.
Ας υποθέσουμε ότι έχουμε την ίδια συλλογή υπαλλήλων που έχει τα ονόματα πεδίων "Employeeid" και "EmployeeName".
Ας υποθέσουμε επίσης ότι έχουμε τα ακόλουθα έγγραφα στη συλλογή μας:
| Ταυτότητα Υπαλλήλου | όνομα υπαλλήλου |
|---|---|
| 22 | NewMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Γκουράνγκ |
| 7 | GURU99 |
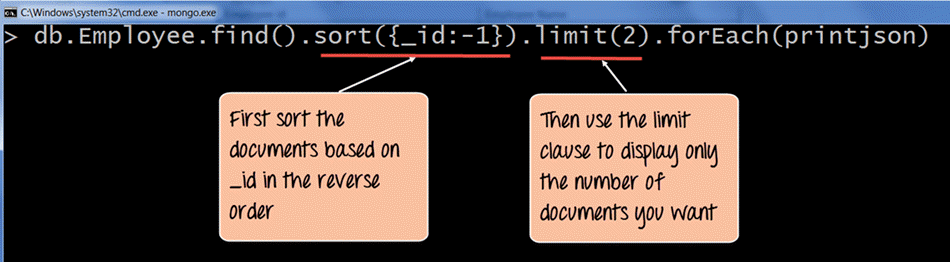
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Επεξήγηση:
- Όταν υποβάλλετε ερώτημα για έγγραφα, χρησιμοποιήστε τη συνάρτηση ταξινόμησης για να ταξινομήσετε τις εγγραφές με αντίστροφη σειρά με βάση την τιμή του πεδίου _id στη συλλογή. Το -1 ουσιαστικά υποδεικνύει την ταξινόμηση των εγγράφων με αντίστροφη ή φθίνουσα σειρά, έτσι ώστε το τελευταίο έγγραφο να γίνει το πρώτο έγγραφο που θα εμφανιστεί.
- Στη συνέχεια, χρησιμοποιήστε τη ρήτρα limit για να εμφανίσετε μόνο τον αριθμό των εγγραφών που θέλετε. Εδώ έχουμε ορίσει τη ρήτρα limit (2), ώστε να ανακτήσει τα δύο τελευταία έγγραφα.
Εάν η εντολή εκτελεστεί με επιτυχία, θα εμφανιστεί η ακόλουθη έξοδος:
Παραγωγή:
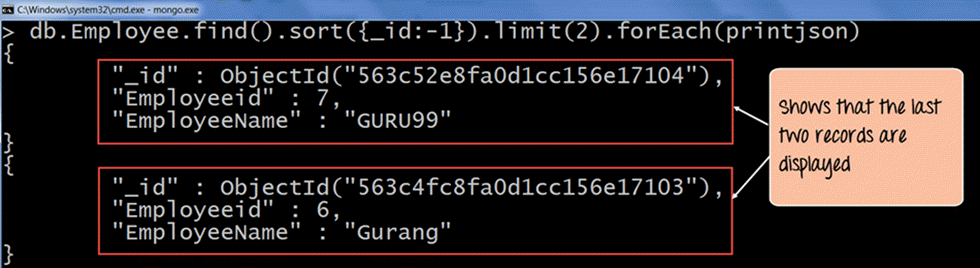
Η έξοδος δείχνει ξεκάθαρα ότι εμφανίζονται τα δύο τελευταία έγγραφα της συλλογής. Ως εκ τούτου, δείξαμε ξεκάθαρα ότι για να ανακτήσουμε τα τελευταία «n» έγγραφα στη συλλογή, μπορούμε πρώτα να ταξινομήσουμε τα έγγραφα με φθίνουσα σειρά και στη συνέχεια να χρησιμοποιήσουμε την ρήτρα ορίου για να επιστρέψουμε τον αριθμό «n» των εγγράφων που απαιτούνται.
Σημείωση: Εάν η αναζήτηση εκτελείται σε μια συμβολοσειρά που είναι μεγαλύτερη από 38,000 χαρακτήρες, δεν θα εμφανίσει τα σωστά αποτελέσματα.
