
Πώς να εγκαταστήσετε το Hadoop σε Ubuntu: Βήματα λήψης και εγκατάστασης
 Prafulla Ranadive
⚡ Έξυπνη Σύνοψη
Εγκατάσταση του Apache Hadoop σε Ubuntu χρειάζεται δύο φάσεις: αποσυμπιέστε την έκδοση σε έναν αποκλειστικό λογαριασμό συστήματος με SSH χωρίς κωδικό πρόσβασης και, στη συνέχεια, επεξεργαστείτε τέσσερα αρχεία XML πριν από τη μορφοποίηση του HDFS και την εκκίνηση του συμπλέγματος ενός κόμβου.
Σε αυτό το σεμινάριο, θα σας καθοδηγήσουμε βήμα προς βήμα στη διαδικασία εγκατάστασης του Apache Hadoop σε ένα Linux box (Ubuntu). Αυτή είναι μια διαδικασία δύο μερών: πρώτα κατεβάστε και εγκαταστήστε την έκδοση και, στη συνέχεια, διαμορφώστε την.
Υπάρχουν δύο προϋποθέσεις:
- Πρέπει να έχετε Ubuntu εγκατασταθεί και τρέξιμο.
- Πρέπει να έχετε Java εγκατασταθεί.
Σημειώσεις έκδοσης Hadoop 3.x για αυτήν τη ρύθμιση
Τα στιγμιότυπα οθόνης σε αυτήν την αναλυτική παρουσίαση καταγράφηκαν στο Hadoop 2.2.0. Η ακολουθία των βημάτων δεν έχει αλλάξει στις τρέχουσες εκδόσεις, αλλά ορισμένα ονόματα και προεπιλογές έχουν αλλάξει. Ελέγξτε τον παρακάτω πίνακα πριν αντιγράψετε οποιαδήποτε εντολή αυτούσια.
| Ρύθμιση ή βήμα | Σε αυτό το σεμινάριο (Hadoop 2.x) | Τρέχον Hadoop 3.x |
|---|---|---|
| Αρχείο έκδοσης | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz, η πρώτη σταθερή έκδοση 3.5, δημοσιεύτηκε στις 2 Απριλίου 2026 |
| Προεπιλεγμένη ιδιότητα συστήματος αρχείων | fs.default.name στην πεζογραφία, fs.defaultFS στην XML |
fs.defaultFS μόνο; fs.default.name είναι απαρχαιωμένο |
| Ιδιότητα MapReduce | mapreduce.jobtracker.address |
mapreduce.framework.name οριστεί σε yarn; η ΕργασίαTracΤο ker δεν υπάρχει πλέον μόλις το YARN προγραμματίσει την εργασία |
| mapred-site.xml | Αντιγράφηκε από mapred-site.xml.template |
Αποστέλλεται μέσα etc/hadoop ήδη, επομένως το βήμα αντιγραφής δεν είναι απαραίτητο |
| Θύρα UI ιστού NameNode | 50070 | 9870 |
| Java | Java 6 ή Java 7 | Java 8 ή Java 11 |
Όλα τα υπόλοιπα σε αυτόν τον οδηγό συμπεριφέρονται με τον ίδιο τρόπο στο Hadoop 3: ο αποκλειστικός λογαριασμός, το κλειδί SSH, τα τέσσερα αρχεία διαμόρφωσης και τα σενάρια έναρξης και διακοπής.
Μέρος 1) Λήψη και εγκατάσταση του Hadoop
Βήμα 1) Προσθήκη χρήστη συστήματος Hadoop
Προσθέστε έναν χρήστη συστήματος Hadoop χρησιμοποιώντας την παρακάτω εντολή.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
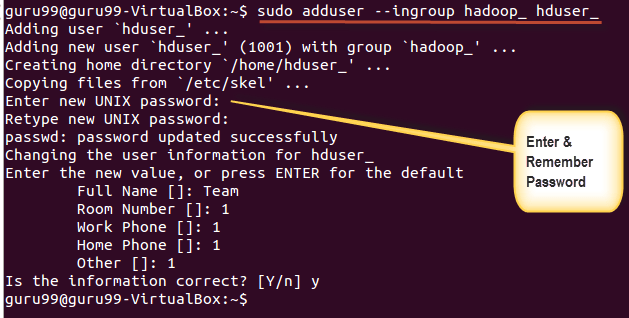
Εισαγάγετε τον κωδικό πρόσβασης, το όνομα και άλλα στοιχεία.
ΣΗΜΕΊΩΣΗ: Υπάρχει πιθανότητα να εμφανιστεί το παρακάτω σφάλμα σε αυτήν τη διαδικασία ρύθμισης και εγκατάστασης.
"Το hduser δεν βρίσκεται στο αρχείο sudoers. Αυτό το περιστατικό θα αναφερθεί».

Αυτό το σφάλμα μπορεί να επιλυθεί συνδεόμενοι ως χρήστης root.
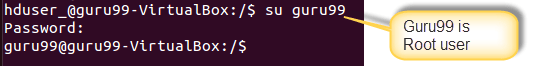
Εκτελέστε την εντολή
sudo adduser hduser_ sudo

Re-login as hduser_

Βήμα 2) Διαμορφώστε το SSH
Για τη διαχείριση κόμβων σε ένα σύμπλεγμα, το Hadoop απαιτεί πρόσβαση SSH.
Πρώτα, αλλάξτε χρήστη, πληκτρολογήστε την ακόλουθη εντολή
su - hduser_

Αυτή η εντολή θα δημιουργήσει ένα νέο κλειδί.
ssh-keygen -t rsa -P ""

Ενεργοποιήστε την πρόσβαση SSH στον τοπικό υπολογιστή χρησιμοποιώντας αυτό το κλειδί.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

Τώρα δοκιμάστε τη ρύθμιση SSH συνδεόμενοι στο localhost ως ο χρήστης 'hduser_'.
ssh localhost

Σημείωση: Εάν δείτε το παρακάτω σφάλμα ως απάντηση στο 'ssh localhost', τότε υπάρχει πιθανότητα το SSH να μην είναι διαθέσιμο σε αυτό το σύστημα.

Για να επιλύσετε αυτό -
Εκκαθάριση SSH χρησιμοποιώντας,
sudo apt-get purge openssh-server
Είναι καλή πρακτική να κάνετε καθαρισμό πριν ξεκινήσετε την εγκατάσταση.

Εγκαταστήστε το SSH χρησιμοποιώντας την εντολή-
sudo apt-get install openssh-server

Βήμα 3) Κατεβάστε το Hadoop
Το επόμενο βήμα είναι να κατεβάσετε το Hadoop από το Σελίδα κυκλοφορίας του Apache Hadoop.

Επιλέξτε Σταθερό

Επιλέξτε το αρχείο tar.gz (όχι το αρχείο που τελειώνει σε src).

Μόλις ολοκληρωθεί η λήψη, μεταβείτε στον κατάλογο που περιέχει το αρχείο tar.

Enter,
sudo tar xzf hadoop-2.2.0.tar.gz

Τώρα, μετονομάστε το hadoop-2.2.0 σε hadoop.
sudo mv hadoop-2.2.0 hadoop

Τέλος, παραδώστε τον φάκελο στον νέο λογαριασμό.
sudo chown -R hduser_:hadoop_ hadoop

Αντικαταστήστε την έκδοση που πραγματικά κατεβάσατε hadoop-2.2.0 στις τρεις παραπάνω εντολές.
Μέρος 2) Διαμόρφωση του Hadoop
Βήμα 1) Τροποποιήστε το αρχείο ~/.bashrc
Προσθέστε τις ακόλουθες γραμμές στο τέλος του αρχείου ~/.bashrc.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
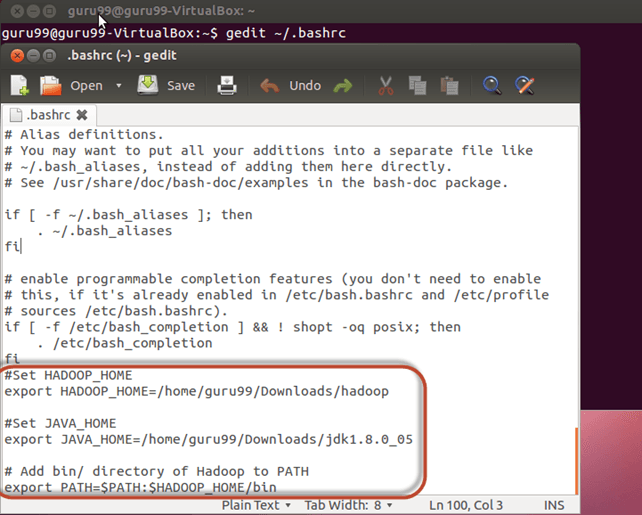
Τώρα, ορίστε την πηγή αυτής της διαμόρφωσης περιβάλλοντος χρησιμοποιώντας την παρακάτω εντολή.
. ~/.bashrc

Βήμα 2) Διαμορφώσεις που σχετίζονται με το HDFS
Ορίστε την τιμή JAVA_HOME μέσα στο αρχείο $HADOOP_HOME/etc/hadoop/hadoop-env.sh, όπως φαίνεται παρακάτω.


Με

Υπάρχουν δύο παράμετροι στο $HADOOP_HOME/etc/hadoop/core-site.xml που πρέπει να οριστούν-
1. 'hadoop.tmp.dir' – Χρησιμοποιείται για να καθορίσει έναν κατάλογο που θα χρησιμοποιηθεί από το Hadoop για την αποθήκευση των αρχείων δεδομένων του.
2. 'fs.defaultFS' – Αυτό καθορίζει το προεπιλεγμένο σύστημα αρχείων. Το παλαιότερο όνομα για την ίδια ιδιότητα, 'fs.default.name', έχει καταργηθεί.
Για να ορίσετε αυτές τις παραμέτρους, ανοίξτε το core-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

Αντιγράψτε τις παρακάτω γραμμές ανάμεσα στις ετικέτες.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

Μεταβείτε στον κατάλογο $HADOOP_HOME/etc/hadoop.

Τώρα, δημιουργήστε τον κατάλογο που αναφέρεται στο core-site.xml.
sudo mkdir -p <Path of Directory used in above setting>

Παραχωρήστε δικαιώματα στον κατάλογο.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

Βήμα 3) Διαμόρφωση MapReduce
Πριν ξεκινήσετε με αυτές τις διαμορφώσεις, ας ορίσουμε τη διαδρομή HADOOP_HOME.
sudo gedit /etc/profile.d/hadoop.sh
Και μπείτε
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

Επόμενη εισαγωγή
sudo chmod +x /etc/profile.d/hadoop.sh

Κλείστε το τερματικό και κάντε επανεκκίνηση ξανά.
Πληκτρολογήστε echo $HADOOP_HOME για να επαληθεύσετε τη διαδρομή.

Τώρα αντιγράψτε αρχεία
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

Ανοίξτε το αρχείο mapred-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

Προσθέστε τις παρακάτω ρυθμίσεις ανάμεσα στις και ετικέτες.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

Ανοίξτε το $HADOOP_HOME/etc/hadoop/hdfs-site.xml όπως παρακάτω,
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

Προσθέστε τις παρακάτω ρυθμίσεις μεταξύ των και ετικέτες.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

Δημιουργήστε τον κατάλογο που καθορίζεται στην παραπάνω ρύθμιση.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

Στη συνέχεια, παραχωρήστε ιδιοκτησία και δικαιώματα σε αυτό.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

Βήμα 4) Μορφοποίηση HDFS
Πριν ξεκινήσουμε το Hadoop για πρώτη φορά, μορφοποιήστε το HDFS χρησιμοποιώντας την παρακάτω εντολή.
$HADOOP_HOME/bin/hdfs namenode -format

Βήμα 5) Ξεκινήστε το σύμπλεγμα ενός κόμβου Hadoop
Ξεκινήστε το σύμπλεγμα ενός κόμβου Hadoop χρησιμοποιώντας την παρακάτω εντολή.
$HADOOP_HOME/sbin/start-dfs.sh
Η έξοδος της παραπάνω εντολής φαίνεται παρακάτω.

Στη συνέχεια, ξεκινήστε τους δαίμονες YARN.
$HADOOP_HOME/sbin/start-yarn.sh

Χρησιμοποιώντας το εργαλείο 'jps', επαληθεύστε εάν εκτελούνται όλες οι διεργασίες που σχετίζονται με το Hadoop.
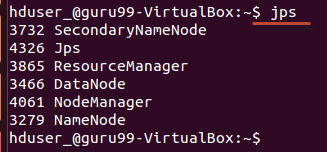
Εάν το Hadoop έχει ξεκινήσει με επιτυχία, η έξοδος jps θα πρέπει να εμφανίζει τα NameNode, NodeManager, ResourceManager, SecondaryNameNode και DataNode.
Βήμα 6) Διακοπήping Hadoop
Απενεργοποιήστε το σύμπλεγμα με την αντίστροφη σειρά.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

Πώς να επαληθεύσετε ότι το Hadoop εκτελείται και να διορθώσετε συνηθισμένα σφάλματα
Η έξοδος jps επιβεβαιώνει ότι οι διεργασίες ξεκίνησαν, αλλά όχι ότι το σύμπλεγμα είναι χρησιμοποιήσιμο. Τέσσερις επιπλέον έλεγχοι επιλύουν αυτό το ερώτημα.
- Ανοίξτε τη διεπαφή ιστού του NameNode στη διεύθυνση
http://localhost:9870(θύρα 50070 στο Hadoop 2.x) και επιβεβαιώστε τις αναφορές σύνοψης ενός ενεργού κόμβου. - Ανοίξτε τη διεπαφή ResourceManager στη διεύθυνση
http://localhost:8088για να επιβεβαιώσει ότι το YARN αποδέχτηκε το NodeManager. - τρέξιμο
hdfs dfsadmin -reportγια χωρητικότητα, ενεργά DataNodes και τυχόν υπο-αναπαραγόμενα μπλοκ. - Γράψε κάτι:
hdfs dfs -mkdir /testακολουθούμενη απόhdfs dfs -ls /αποδεικνύει ότι ο χώρος ονομάτων δέχεται αλλαγές.
Οι περισσότερες αποτυχίες που παρατηρούνται για πρώτη φορά εμπίπτουν σε μία από τις πέντε κατηγορίες.
| Σύμπτωμα | Αιτία | σταθερός |
|---|---|---|
| Το JAVA_HOME δεν έχει οριστεί και δεν ήταν δυνατό να βρεθεί | Η μεταβλητή εξάγεται σε .bashrc αλλά όχι σε hadoop-env.sh | Ορίστε επίσης την απόλυτη διαδρομή JDK μέσα στο hadoop-env.sh |
| Δεν επιτρέπεται η πρόσβαση (publickey,password) στον ssh localhost | Το authorized_keys λείπει ή είναι πολύ επιτρεπτικό | Προσθέστε ξανά το id_rsa.pub και, στη συνέχεια, εκτελέστε την εντολή chmod 600 στο ~/.ssh/authorized_keys |
| Η σύνδεση απορρίφθηκε στη θύρα 22 | Ο openssh-server δεν είναι εγκατεστημένος ή δεν εκτελείται | Εγκαταστήστε το openssh-server και ξεκινήστε την υπηρεσία ssh |
| Το DataNode λείπει από το jps μετά από αναδιαμόρφωση | Cluster Αναντιστοιχία αναγνωριστικού μεταξύ του μορφοποιημένου καταλόγου NameNode και του παλιού καταλόγου DataNode | Αδειάστε τον φάκελο dfs.datanode.data.dir και, στη συνέχεια, κάντε ξανά μορφοποίηση |
| start-dfs.sh: η εντολή δεν βρέθηκε | Τα HADOOP_HOME και PATH δεν προήλθαν ποτέ από το τρέχον κέλυφος | Εκτελέστε .~/.bashrc ή ανοίξτε ένα νέο τερματικό |
