
10 beste KOSTENLOSE Web-Scraperping Werkzeuge (2026)
 Redaktion
Disclosure: Guru99 wird von Lesern unterstützt. Wir erhalten möglicherweise eine Provision, wenn Sie über Links auf dieser Seite einkaufen. Mehr erfahren
Web-Scrapingping Tools können zwar Stunden sparen, doch die falsche Wahl führt oft zu unvollständigen Datensätzen, löst IP-Sperren aus, verschwendet Guthaben, verschleiert wichtige Limits und lässt Anfänger in unübersichtlichen Dashboards zurück. Instabile Selektoren oder inkonsistente Darstellung können Berichte zudem ohne Vorwarnung beschädigen. Leser vergleichen oft die zulässigen Beträge in Überschriften, übersehen dabei aber die Kosten für Anfragen. JavaSkriptunterstützung, Datenaufbewahrung und Compliance-Kontrollen. Eine klarere Überprüfung macht diese Abwägungen sichtbar, hilft dabei, jeden Workflow dem richtigen Service zuzuordnen und verwandelt eine unklare Vorauswahl in einen überschaubaren nächsten Schritt.
Ich habe über 55 Stunden damit verbracht, mehr als 18 Tools zu recherchieren und dabei offizielle Produktseiten, Zugriffsbeschränkungen, Arbeitsabläufe und wiederkehrende Bewertungsmuster zu prüfen. Meine eingehende Recherche ergab die 10 besten kostenlosen Web-Scraping-Tools.ping Die verschiedenen Tools werden mit ihren Funktionen, Vor- und Nachteilen sowie den Details des aktuellen Tarifs vorgestellt. Der Leitfaden unterscheidet zwischen dauerhaft kostenlosen Tarifen, Testguthaben und kostenpflichtigen Testversionen, damit Sie Ihre Erwartungen besser einschätzen können. Lese mehr ...
Oxylabs ist eine marktführende Plattform zur Erfassung von Web-Intelligence. Sie erfüllt die höchsten Standards in den Bereichen Wirtschaft, Ethik und Compliance und ermöglicht es Unternehmen weltweit, datenbasierte Erkenntnisse zu gewinnen. Sie bietet einen automatischen Wiederholungsmechanismus, der dabei hilft, IP-Sperren zu handhaben und zu umgehen.
best FREE Web Scraping Software-Tools
| Name | besten Für | Hauptfunktionen | Benutzerfreundlich | Kostenlose Testversion | verbindung |
|---|---|---|---|---|---|
👍 Oxylabs |
Groß angelegte DatenexperimentetracProduktion | Hohe Erfolgsquote, Geotargeting, Strukturierte Daten | Moderat | Unlimited | Mehr erfahren |
 👍 Decodo |
Fortgeschrittenes Daten-Scrapingping Lösungen | IP-Rotation, Hohe Erfolgsquote, Proxy-Management | Einfach | 7 Tage kostenlose Testversion | Mehr erfahren |
 👍 NodeMaven |
Premium Residential und Mobile Proxy Scraping | IP-Qualitätsfilter, 7-tägige Sitzungsbindung, über 190 Länder | Einfach | 750 MB für 3.50 $ | Mehr erfahren |
 Webshare |
Preisgünstiges Proxy-Netzwerk für Scrapping | Über 80 Millionen IPs, Geo-Targeting, IP-Rotation | Einfach | 10 kostenlose Proxys | Mehr erfahren |
 Apify |
Entwickler und Automatisierungs-Enthusiasten | Erweiterte Datenexportinformationentraction, API-Aufrufe | Moderat | Lebenslanger kostenloser Basisplan | Mehr erfahren |
1) Oxylabs
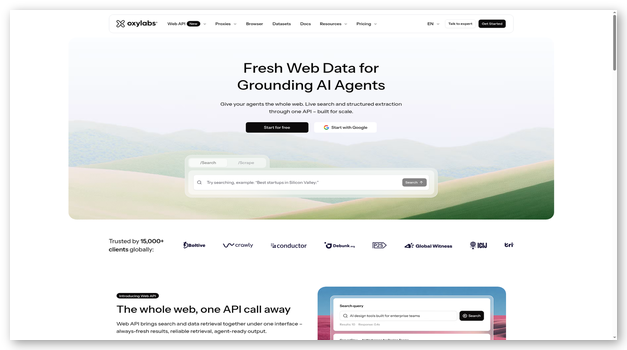
Oxylabs bietet ein verwaltetes Web Scraper API für Teams, die öffentlich zugängliche Daten von schwer zugänglichen Websites sammeln. Sie übernimmt Proxy-Routing, Browser-Rendering, Wiederholungsversuche und strukturierte Datenübermittlung hinter einer einzigen API. Einzelhandels-Monitoring-Teams können lokalisierte Produktseiten anfordern, ohne separate Browserflotten verwalten zu müssen.
Das Dashboard konzentriert sich auf Nutzung, Anfragen und Parsersteuerung. Batch-Abfragen und die Planung unterstützen wiederkehrende Aufgaben, während OxyCopilot die Generierung von Anfragen erleichtert. Der Dienst eignet sich besser für Produktionsworkloads als für gelegentliche Einzelprojekte, insbesondere wenn eine vorhersehbare Lieferung wichtiger ist als die Kontrolle über den Scraper.ping Infrastruktur im großen Maßstab.
Merkmale:
- Verwaltete Anfragen: Die API leitet Anfragen über die geeignete Infrastruktur und wiederholt blockierte Versuche. Teams erhalten nutzbare Antworten, ohne umfangreiche Proxy-Listen oder Browser-Worker verwalten zu müssen.
- Headless-Browser: Browser-Rendering lädt JavaSeiten mit viel Skript vor extraction. Dies unterstützt dynamische Produktlisten, interaktive Reiseseiten und andere Inhalte, die im reinen HTML-Code fehlen.
- Benutzerdefinierter Parser: Benutzerdefinierte Parsing-Regeln wandeln unterstützte Seiten in strukturierte Felder um. Analysten verbringen dadurch weniger Zeit mit der Bereinigung des Markups, bevor sie Ergebnisse in Datenbanken oder Berichte laden.
- Stapelabfragen: Batch-Übermittlungsgruppen mit vielen Zielen URLs wird in einen Workflow integriert. Dadurch wird der Koordinationsaufwand reduziert, wenn Teams Preise, Lagerbestände, Suchergebnisse oder Angebote überwachen.
- Scheduler: Geplante Jobs führen regelmäßig Datenerfassungen in definierten Intervallen durch. Dies hilft Teams, Datensätze zu aktualisieren, ohne für jedes Projekt einen separaten Cron-Dienst zu benötigen.
- Geografisches Targeting: Standortparameter fordern Seiten aus ausgewählten Märkten an. Forscher können über dieselbe API-Integration regionale Preise, Verfügbarkeit oder Suchergebnisse vergleichen.
- Nutzungssteuerung: Das Dashboard zeigt den Ergebnisverbrauch und die Anfrageaktivität an. Teams können tracDas k-Volumen, bevor die Grenzwerte während einer Produktionssammlung zu einer Überraschung werden.
Vorteile
Nachteile
👉 Wie man erhält Oxylabs kostenlos?
- Öffnen Sie den Microsoft Store auf Ihrem Windows-PC Oxylabs Web Scraper Seite mit den API-Preisen.
- Erstellen Sie ein Konto und wählen Sie die kostenlose Testversion ohne Angabe einer Karte.
- Die Studie umfasst bis zu 2,000 Ergebnisse für unterstützte Scraping-Verfahren.ping zum Arbeitsablauf
Kostenlose Testversion mit bis zu 2,000 Ergebnissen
2) Decodo
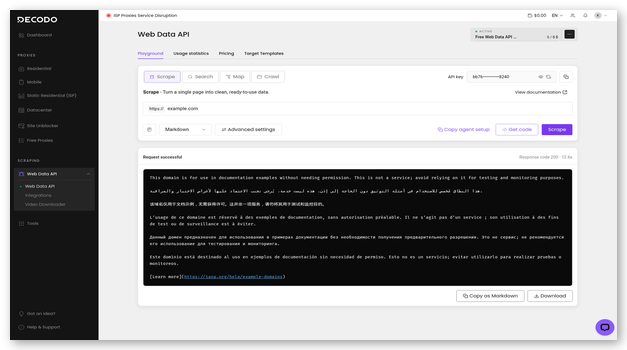
Decodo kombiniert Proxy-Infrastruktur mit Web-Scrapingping Diese API wurde speziell für Entwickler, Analysten und KI-Workflows entwickelt. Ihre Endpunkte zum Scrapen, Suchen, Kartieren und Crawlen decken sowohl einzelne Seiten als auch mehrseitige Analysen ab. Vorgefertigte Vorlagen liefern strukturierte Daten für gängige Ziele, ohne dass ein benutzerdefinierter Parser erforderlich ist.
Das Dashboard zeigt API-Schlüssel, Anfrageeinstellungen, Nutzungshinweise und Ausgabeoptionen an. JavaSkriptbasierte Darstellung und die Auswahl verwalteter Proxys bewältigen auch komplexere Seiten, während die Markdown-Ausgabe Sprachmodell-Pipelines unterstützt. Dank eines dauerhaft kostenlosen Abonnements eignet sich Decodo ideal für Prototypen, bevor Teams höhere Anfragevolumina zuverlässig bewältigen.
Merkmale:
- Vier Endpunkte: Scrape-, Such-, Karten- und Crawling-Endpunkte decken fokussierte Beispiele abtracDatenverarbeitung und Website-Erkennung. Entwickler können mehrere Datenaufgaben mit einem einzigen API-Schlüssel verwalten.
- Vorbereitete Vorlagen: Mehr als 100 gepflegte Vorlagen zielen auf gängige Websites und Datentypen ab. Sie reduzieren den Auswahlaufwand und beschleunigen frühe Proof-of-Concept-Projekte.
- JavaSkriptwiedergabe: Optionales Rendering lädt dynamische Inhalte vor der Auslieferung. Teams können Daten von clientseitig gerenderten Seiten erfassen, ohne einen eigenen Headless-Browsercluster betreiben zu müssen.
- Flexible Ausgabe: Antworten können, sofern unterstützt, HTML-, Markdown-, JSON-, CSV-, PNG- oder XHR-Daten enthalten. Jeder Workflow kann ein analysetaugliches Format auswählen.
- Proxy-Verarbeitung: Die integrierte Proxy-Auswahl und die Anti-Bot-Funktionen reduzieren den manuellen Aufwand für die Serverrotation. Anfragen können geografisch sensible Seiten erreichen, während die API die Infrastrukturentscheidungen trifft.
- KI-Verbindungen: MCP und andere Integrationswege bringen aktuelle Webdaten in unterstützte KI-Tools. Dies eignet sich für Recherche-Agenten und Abruf-Workflows, die Live-Quellen benötigen.
- Anforderungskontrollen: Bei jedem Tarif werden Ratenbegrenzungen und Gesamtnutzungssummen angezeigt. Teams können die Projektgröße anhand des Crawl-Volumens bestimmen, anstatt nur die Bandbreite zu schätzen.
Vorteile
Nachteile
👉 Wie bekomme ich Decodo kostenlos?
- Besuchen Sie Decodos Web-Scraping-Seite.ping Seite mit den API-Preisen.
- Erstellen Sie ein kostenloses Konto und kopieren Sie die generierten API-Zugangsdaten.
- Der kostenlose Tarif umfasst 5,000 Crawls oder 10,000 extrahierte Seiten pro Monat.
Kostenloser Tarif mit bis zu 10,000 Seiten
3) NodeMaven
NodeMaven ist eine Proxy-Plattform für Scrapingping Teams, die bereits Ex besitzentracCode- oder Browserautomatisierung. Optionen für Privatkunden, Mobilfunk und Internetanbieter unterstützen HTTP- und SOCKS5-Verbindungen mit großer geografischer Abdeckung. Der IP-Qualitätsfilter prüft Adressen vor der Zuweisung, um vermeidbare Fehler zu reduzieren.
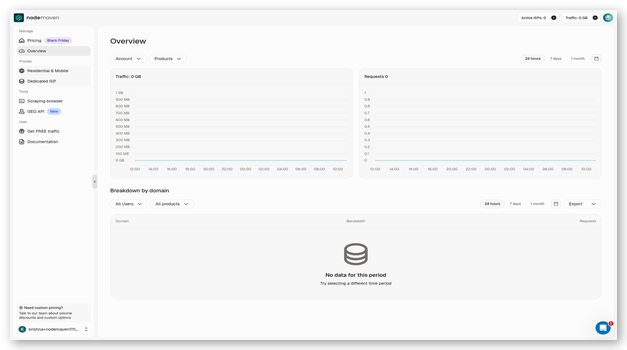
Das Dashboard konzentriert sich auf Datenverkehr, Anmeldeinformationen, Targeting und Rotationseinstellungen anstatt auf analysierte Datensätze. Sticky Sessions eignen sich für die Konto- oder Standortkontinuität, während die Rotation pro Anfrage für umfassende Crawls geeignet ist. NodeMaven ist am effektivsten, wenn Proxy-Qualität und Sitzungskontrolle wichtiger sind als ein vorgefertigter Crawler.ping API.
Merkmale:
- Qualitätsfilter: Der IP-Qualitätsfilter prüft verfügbare Adressen vor der Zuweisung. Sauberere Adresspools können unnötige Wiederholungsversuche und CA-Fehler reduzieren.PTCHA-Unterbrechungen während langer Datenerfassungsläufe.
- Proxy-Typen: Residential-, Mobilfunk- und ISP-Proxys befinden sich unter einem einzigen Konto. Teams können Reputation, Stabilität und Kosten jedem Proxy zuordnen.ping Ziel.
- Rotationssteuerung: Verbindungen können zwischen Anfragen rotieren oder über längere Sitzungen hinweg bestehen bleiben. Dies unterstützt sowohl große Crawls als auch Workflows, die eine konsistente Identität erfordern.
- Geografisches Targeting: Durch die Filterung nach Land, Stadt und Internetanbieter wird der Ausstiegsort eingeschränkt. Forscher können lokalisierte Preise, Werbung, Suchergebnisse oder Verfügbarkeitsdaten erfassen.
- Protokollunterstützung: Die Unterstützung für HTTP und SOCKS5 funktioniert mit gängigen Skripten und Automatisierungstools. Bestehende Crawler können sich verbinden, ohne ihre Konfiguration ändern zu müssen.tracLogik der Translation.
- Verkehrsüberschlag: Nicht genutzter Datenverkehr kann gemäß den aktuellen Tarifen in den nächsten Abrechnungszeitraum übertragen werden. Dies hilft Projekten mit unregelmäßigen monatlichen Zahlungsplänen, die gekaufte Kapazität zu erhalten.
- Nutzungs-Dashboard: Verkehrs- und Verbindungsdetails werden im Konto-Dashboard angezeigt. Teams können den Verbrauch überwachen und die Rotation anpassen, bevor das Datenvolumen eines Crawls erschöpft ist.
Vorteile
Nachteile
👉 Wie erhalte ich NodeMaven kostenlos?
- Öffne die Preisseite von NodeMaven und erstelle ein Konto.
- Wählen Sie die Testversion für den Proxy-Zugriff für Privatkunden und Mobilgeräte.
- Die kostenpflichtige Testversion kostet 3.50 US-Dollar und beinhaltet ein Datenvolumen von 750 MB.
750 MB Testversion für 3.50 $
4) Webshare
Webshare Bietet Proxy-Verbindungen für Rechenzentren, Privatkunden und Internetanbieter für Skripte, Crawler und Browserautomatisierung. Der dauerhaft kostenlose Tarif umfasst zehn Rechenzentrum-Proxys und ein monatliches Datenvolumen für kleinere Projekte. Die Authentifizierung erfolgt über Anmeldedaten oder genehmigte IP-Adressen.
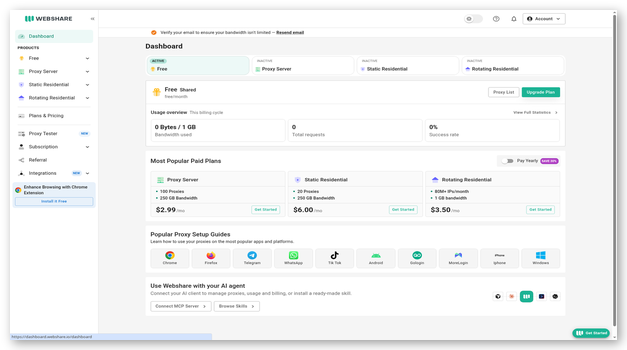
Das Dashboard präsentiert Proxy-Listen, Verbindungsdetails, Nutzung und API-Zugriff übersichtlich an einem Ort. Rotationssteuerungen helfen bei der Verteilung von Anfragen, während Standortfilter die regionale Erfassung unterstützen. Webshare Es eignet sich für Lernende und einfache Aufgaben, die einen zuverlässigen Proxy-Zugriff benötigen, ersetzt aber weder einen Parser noch ein vollständiges Scraping.ping Arbeitsablauf.
Merkmale:
- Kostenlose Proxys: Der dauerhaft kostenlose Tarif umfasst zehn Rechenzentrumsproxys und 1 GB monatliches Datenvolumen. Kleinere Experimente können ohne zeitliche Begrenzung des Testzeitraums fortgesetzt werden.
- Proxy-Optionen: Die kostenpflichtigen Optionen umfassen Rechenzentrums-, Heim- und ISP-Verbindungen. Teams können einen Pool basierend auf dem angestrebten Schwierigkeitsgrad, der Stabilität und dem Budget auswählen.
- Drehung: Bei unterstützten Tarifen ändern rotierende Endpunkte ihre Adressen automatisch. Dies reduziert den manuellen Aufwand für die Pflege der Proxy-Liste bei größeren oder häufig wiederholten Anfragesätzen.
- Geografische Steuerung: Standortfilter helfen dabei, Anfragen über relevante Länder oder Regionen zu leiten. Marktforscher können lokalisierte Inhalte mithilfe desselben Verbindungsworkflows vergleichen.
- API-Zugriff: Die API stellt Proxy-Details und Kontovorgänge zur Automatisierung bereit. Entwickler können Verbindungen bereitstellen oder abrufen, ohne Listen vom Dashboard kopieren zu müssen.
- Authentifizierung: Benutzername und IP-Autorisierung unterstützen unterschiedliche Bereitstellungsmuster. Teams können den Zugriff auf Server, Laptops oder verteilte Scrap-Systeme sichern.ping Arbeitnehmer.
- Anwendungsbereich tracKönig: Die Kennzahlen im Dashboard zeigen Bandbreiten- und Proxy-Aktivität an. Benutzer können so nahende Grenzwerte erkennen, bevor ein Crawler während eines wichtigen Datenerfassungslaufs stoppt.
Vorteile
Nachteile
👉 Wie man erhält Webshare kostenlos?
- Öffne Webshare und registrieren Sie sich kostenlos ohne Karte.
- Rufen Sie die Proxy-Liste auf, um die zugewiesenen Verbindungsdetails abzurufen.
- Der kostenlose Tarif beinhaltet zehn Rechenzentrumsproxys und 1 GB pro Monat.
10 kostenlose Proxys und 1 GB monatlich
5) Apify
Apify ist eine Cloud-Plattform für die Ausführung wiederverwendbarer Web-Scraper, sogenannter Actors. Der öffentliche Store deckt gängige Websites ab, während Entwickler mit Crawlee oder anderen unterstützten Tools benutzerdefinierte Actors erstellen können. Zeitpläne, Datensätze, Warteschlangen und Webhooks wandeln einzelne Ausführungen in wiederholbare Daten-Workflows um.
Die Konsole zeigt Eingaben, Ausführungsprotokolle, Speicherbedarf, Kosten und Ausgaben für jeden Akteur an. Teams können Datensätze exportieren oder über die API verbinden. Apify Es bietet hohe Flexibilität, wobei die Qualität des Marktplatzes und die Nutzungskosten variieren. Es eignet sich für Anwender, die sowohl vorgefertigte Web-Scraper als auch eine programmierbare Automatisierungsplattform benötigen.
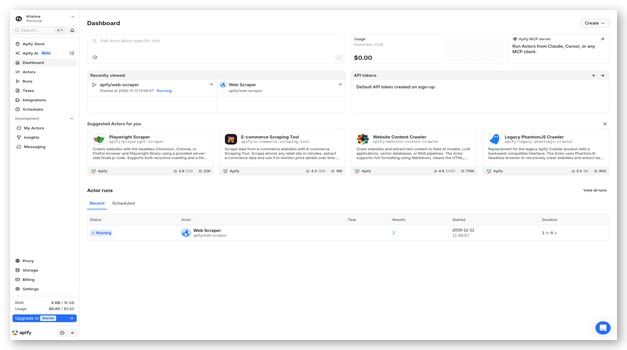
Merkmale:
- Schauspielerladen: Der Store bietet vorgefertigte Scraper für viele gängige Websites und Aufgaben. Benutzer können mit einem bestehenden Actor beginnen, anstatt jeden Collector selbst zu programmieren.
- Benutzerdefinierte Akteure: Entwickler können ihre eigenen Scraps verpacken.ping Logik als wiederverwendbare Akteure. Versionierte Eingaben und Builds erleichtern die wiederholte Ausführung desselben Workflows.
- Scheduling: Integrierte Zeitpläne starten Akteure zu ausgewählten Zeiten oder in festgelegten Intervallen. Wiederkehrende Preis-, Angebots- oder Inhaltsüberwachung kann ohne externen Zeitplaner ausgeführt werden.
- Datenspeicher: Datensätze, Schlüsselwertspeicher und Anforderungswarteschlangen organisieren Ausgaben und den Crawling-Status. Jeder Durchlauf sorgt dafür, dass seine Datensätze für den Export oder die Weiterverarbeitung zugänglich bleiben.
- Integrationen: APIs, Webhooks und Konnektoren senden Ergebnisse an andere Systeme. Teams können nach einem erfolgreichen oder fehlgeschlagenen Durchlauf Folgeaufträge auslösen.
- Proxy-Optionen: Innerhalb der Plattform sind Rechenzentrums- und Wohn-Proxy-Dienste verfügbar. Akteure können Verbindungen wechseln, ohne einen separat verwalteten Proxy-Anbieter zu benötigen.
- Überwachung ausführen: Für jeden Durchlauf werden Protokolle, Status, Rechenleistung und Kosten angezeigt. Entwickler können Fehler diagnostizieren und den Ressourcenverbrauch wiederkehrender Aufträge abschätzen.
Vorteile
Nachteile
👉 Wie man erhält Apify kostenlos?
- Besuchen Sie ApifyBesuchen Sie die Preisseite von [Name des Unternehmens] und wählen Sie den kostenlosen Tarif aus.
- Erstellen Sie ein Konto, ohne Zahlungskarteninformationen anzugeben.
- Der Plan verlängert sich automatisch mit einem monatlichen Guthaben von 5 US-Dollar und fünf gleichzeitigen Durchläufen.
5 $ monatliches Gratisguthaben
6) Novada
Novada Gruppen a Scraper API, Web Unblocker und Browser-API unter einem Guthaben. Scraper Die API gibt strukturierte Datensätze für unterstützte Ziele zurück, während die Browser-API die interaktive Verarbeitung übernimmt. JavaSkriptseiten werden mithilfe bekannter Automatisierungsprotokolle erstellt. Verwaltete Anti-Bot-Kontrollen reduzieren den Infrastrukturaufwand.
Sein Dashboard tracks-Produktnutzung, Domains, Guthaben und gleichzeitige Anfragen. Die einheitliche Abrechnung ermöglicht es Teams, die Abrechnungsmethode ohne separate Abonnements zu wechseln. Novada ist nützlich für gemischte BeispieletracFür die Nutzung sind weitere Anforderungen erforderlich, der Testzugang setzt jedoch die Freigabe und Zustimmung der Kampagne voraus. Gekaufte Guthaben verfallen nach Ablauf der angegebenen Gültigkeitsdauer.
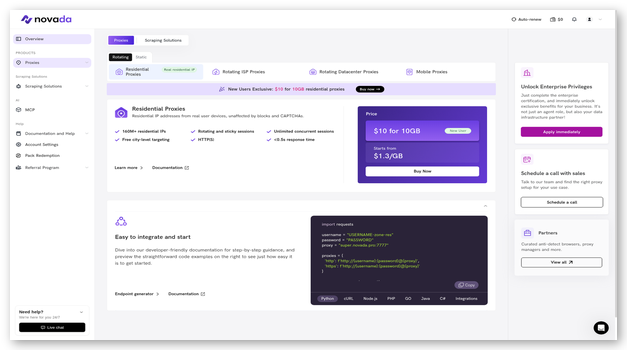
Merkmale:
- Scraper API: Das Scraper Die API liefert aufbereitete Daten für unterstützte Such-, Handels- und Social-Media-Ziele. Teams können dadurch einen Großteil der HTML-Analyse überspringen.
- Web-Unblocker: Web Unblocker liefert unformatierte Seiten und behebt gleichzeitig gängige Zugriffsbarrieren. Es eignet sich für Teams, die ihre eigene Parsing-Logik beibehalten möchten.
- Browser-API: Cloud-Browser unterstützen Verbindungen im Puppeteer- und Playwright-Stil. Entwickler können Seiten rendern, Elemente anklicken, scrollen und komplexe interaktive Inhalte erfassen.
- Vereinheitlichte Credits: Ein Kontostand deckt den Schrott abpingEntsperrungs- und Browserprodukte. Teams können die Methoden ändern, ohne für jeden Dienst ein separates Kontingent erwerben zu müssen.
- Erfolgsabrechnung: Novada berechnet Guthaben, wenn Anfragen gemäß den veröffentlichten Regeln Daten zurückgeben. Fehlgeschlagene Plattformanfragen verbrauchen nicht dasselbe Guthaben.
- Strukturierte Ausgabe: Unterstützte Vorlagen liefern JSON- oder CSV-Datensätze anstelle von Rohdaten. Analysten können die Ergebnisse mit weniger Aufwand in Berichte einbinden.
- Parallelitätskontrollen: Die Tarifstufen definieren die Kapazität für parallele Anfragen für jedes Produkt. Teams können ein Kontingent wählen, das dem Crawler-Volumen und den erwarteten Antwortzeiten entspricht.
Vorteile
Nachteile
👉 Wie man erhält Novada kostenlos?
- Erstellen Sie Novada account und öffne die Seite für die kostenlose Testphase.
- Teile die Kampagne mit drei Gruppen und sende anschließend Screenshots an den Support.
- Nach der Genehmigung, Novada fügt 15 $ Guthaben für Proxys und Scraping hinzu.ping Werkzeuge.
15 $ Testguthaben
7) Bright Data
Bright Data bietet vorgefertigte Webseiten Scraper APIs, ein Scraping Browser, Scraper Studio, Proxys und Datensätze. Teams können strukturierte Datensätze auswählen oder einen Remote-Browser mit Playwright und Puppeteer steuern. Die integrierte Zugriffsverwaltung kümmert sich um Rotation, Browser-Fingerprints und Zugriffsabfragen.
Das Kontrollfeld trennt Produkte, Anmeldeinformationen, Nutzung, Datensammler und Bereitstellungseinstellungen. Vorkonfigurierte APIs reduzieren den Wartungsaufwand auf unterstützten Zielplattformen, während der Browserzugriff benutzerdefinierte Interaktionen ermöglicht. Bright Data Es eignet sich für anspruchsvolle Projekte mit umfassendem Funktionsumfang und Supportbedarf. Der große Produktkatalog und die Optionen für Unternehmen können für einfache persönliche Anwendungen jedoch übertrieben wirken.ping.
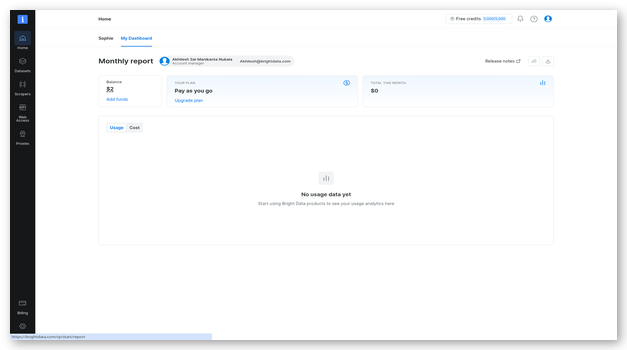
Merkmale:
- Scraper APIs: Vorkonfigurierte APIs liefern strukturierte Datensätze für unterstützte Websites und Kategorien. Teams vermeiden so die Pflege von Selektoren und Browserlogik bei jeder Zieländerung.
- Scharfping Browser: Ein gehosteter Browser verbindet sich über Playwright oder Puppeteer. Entwickler können Folgendes ausführen: JavaInteraktionen skripten und automatisieren, während Bright Data Verwaltet die Zugangsinfrastruktur.
- Scraper Studio: Studio-Tools helfen beim Erstellen und Bereitstellen benutzerdefinierter Datensammler. Visuelle und KI-gestützte Optionen verkürzen die Einrichtungszeit für Ziele ohne vorbereitete API.
- Proxy-Netzwerk: Integrierte Proxy-Dienste decken verschiedene Verbindungstypen und Standorte ab. Workflows können den Datenverkehr weiterleiten, ohne dass Anmeldeinformationen zwischen mehreren separaten Anbietern übertragen werden müssen.
- Lieferoptionen: Die erfassten Daten können über APIs, Webhooks oder unterstützte Cloud-Ziele übertragen werden. Teams können bestehende Data Warehouses und Analyse-Pipelines nach jedem Durchlauf speisen.
- Ausgabenkontrollen: Pay-as-you-go-Optionen und monatliche Limits helfen bei der Verbrauchssteuerung. Nutzungsübersichten im Dashboard zeigen, wie sich ein Datensammler auf das Projektbudget auswirkt.
- Kostenlose Schallplatten: Das Web Scraper Die kostenlose API-Lizenz umfasst 5,000 Datensätze pro Monat. Für die Nutzung dieser Lizenz ist keine Zahlungskarte erforderlich.
Vorteile
Nachteile
👉 Wie man erhält Bright Data kostenlos?
- Öffne Bright Data's Web Scraper Seite mit den API-Preisen.
- Wählen Sie „Kostenlos starten“ und registrieren Sie sich ohne Angabe einer Zahlungskarte.
- Das kostenlose Paket umfasst 5,000 Web Scraper Die API protokolliert jeden Monat.
5,000 kostenlose Datensätze pro Monat
8) PrivateProxy
PrivateProxy Bietet statische und rotierende Proxy-Pakete für Skripte und Browserautomatisierung. Statische Testversionen für Privatkunden und Rechenzentren ermöglichen es Nutzern, eine Adresse vor der endgültigen Buchung zu testen, während kostenpflichtige, rotierende Pakete anfrage- oder bandbreitenbasierten Datenverkehr abdecken. Verbindungen unterstützen gängige Authentifizierungsmuster.
Der Kontobereich konzentriert sich auf Pakete, Standorte, Zugangsdaten, Nutzung und Abonnementstatus. Feste, statische Optionen eignen sich für Anwendungen, die eine konsistente Adresse erfordern, während rotierende Dienste für umfassendere Suchvorgänge geeignet sind. PrivateProxy ist eher eine Infrastrukturkomponente als ein vollständiger Scraper, daher müssen Teams ex bereitstellen.tracLogik, Wiederholungsversuche, Speicherung und Datenvalidierung.
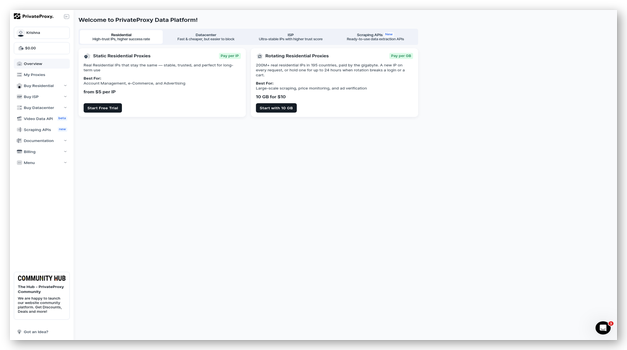
Merkmale:
- Statische Proxys: Statische Rechenzentrums- und ISP-Optionen behalten für die gesamte Abonnementlaufzeit eine Adresse bei. Sie eignen sich für Sitzungen, die Kontinuität oder Zugriffsbeschränkungen erfordern.
- Rotierender Zugang: Durch die Rotation von Paketen ändern sich die Adressen über Anfragen oder Sitzungen hinweg. Dies ermöglicht die Verteilung des Crawler-Datenverkehrs, ohne dass eine separate lokale Proxy-Liste verwaltet werden muss.
- Auswahlmöglichkeiten: Ausgewählte statische Pakete beinhalten eine zweitägige kostenlose Testphase mit Kartenverifizierung. Rotierende Testpakete hingegen bieten einen Einführungspreis für die erste Nutzung.
- Authentifizierung: Benutzernamebasierte Anmeldeinformationen und IP-basierte Autorisierung unterstützen gängige Serverbereitstellungen. Teams können die Methode wählen, die am besten zu ihrer Crawler-Umgebung passt.
- Standortauswahl: Die verfügbaren Pakete bieten während der Bestellung regionale Auswahlmöglichkeiten. Nutzer können einen Proxy-Standort dem untersuchten Markt oder der Website zuordnen.
- Abonnementsteuerung: Das Dashboard zeigt aktive Pakete und den Verlängerungsstatus an. Testnutzer können vor der Verlängerung kündigen, um die angegebene monatliche Gebühr zu vermeiden.
- Protokollunterstützung: HTTP-, HTTPS- und SOCKS-Verbindungen decken viele Scraping-Verfahren ab.ping Bibliotheken und Browser. Bestehende Tools können ohne herstellerspezifische Schnittstelle eine Verbindung herstellen.traction SDK.
Vorteile
Nachteile
👉 Wie man erhält PrivateProxy kostenlos?
- Öffne PrivateProxyBesuchen Sie die Hilfeseite und wählen Sie eine geeignete statische Testversion aus.
- Wählen Sie die Standortdetails aus und fügen Sie eine Karte zur Verifizierung hinzu.
- Die kostenlose Testphase dauert zwei Tage und verlängert sich automatisch, sofern sie nicht umgehend gekündigt wird.
2-Tage kostenlose Testversion
9) ScraperAPI
ScraperAPI Bietet Entwicklern einen zentralen Endpunkt zum Abrufen von Seiten über verwaltete Proxy-Pools. Es übernimmt Adressrotation, automatische Wiederholungsversuche und CA (Certificate of Access).PTCHAs, Geotargeting und optionale JavaSkript-Rendering. Strukturierte Endpunkte decken ausgewählte Handels- und Suchziele ab, während die asynchrone API größere Anfragepakete unterstützt.
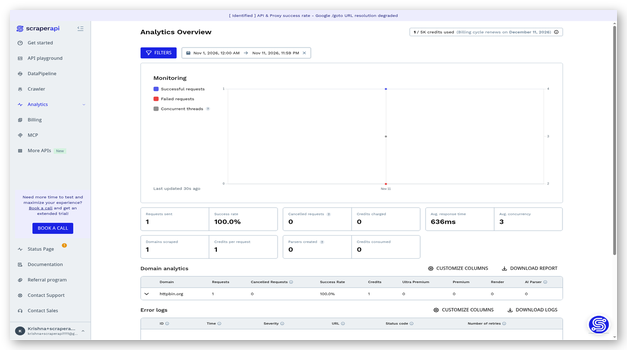
Das Dashboard zeigt API-Zugangsdaten, Guthabennutzung, Parallelität und Anfrageanalysen an. DataPipeline ermöglicht die Planung und Bereitstellung von Daten ohne separaten Crawler-Dienst. ScraperAPI Geeignet für Teams, die bereits wissen, welche Seiten sie anfordern müssen, aber Proxy-Operationen vermeiden möchten. Die Kosten für die Gutschrift variieren je nach Ziel und aktivierten Funktionen.
Merkmale:
- Einzelner Endpunkt: Eine Standard-API-Anfrage sendet das Ziel URL und Authentifizierungsschlüssel. ScraperAPI Verwaltet die Proxy-Auswahl und gibt die resultierende Seitenantwort zurück.
- Automatische Wiederholungsversuche: Fehlgeschlagene oder blockierte Versuche können über verschiedene Verbindungen wiederholt werden. Dies reduziert die benutzerdefinierte Wiederholungslogik im Scraper des Aufrufers.ping Anwendung.
- JavaSkriptwiedergabe: Optionales Rendering lädt clientseitige Inhalte, bevor eine Antwort zurückgegeben wird. Dynamische Produktseiten und Anwendungsschnittstellen sind über dieselbe API zugänglich.
- Strukturierte Daten: Dedizierte Endpunkte liefern analysierte Datensätze für unterstützte Ziele. Teams können so die Pflege von Selektoren für gängige Produkt-, Such- und Listenseiten vermeiden.
- Datenpipeline: DataPipeline plant Datenerfassungen und liefert die fertigen Dateien an unterstützte Zielorte. Analysten können wiederkehrende Aufträge ausführen, ohne eine vollständige Orchestrierungsschicht erstellen zu müssen.
- Kostenrechner: Dashboard-Tools schätzen den Kreditverbrauch für ein URL und Parametersatz. Dies hilft Teams, die Kosten für Rendering, Premium-Proxy und Bypass zu vergleichen.
- Freibetrag: Der veröffentlichte Gratis-Tarif umfasst 1,000 API-Credits und fünf gleichzeitige Verbindungen. Nutzer können Standardanfragen testen, bevor sie sich für einen kostenpflichtigen Tarif entscheiden.
Vorteile
Nachteile
👉 Wie man erhält ScraperAPI kostenlos?
- Besuchen Sie ScraperAPIBesuchen Sie die Preisseite von [Name des Unternehmens] und erstellen Sie ein kostenloses Konto.
- Kopieren Sie den API-Schlüssel und testen Sie eine Standardanfrage.
- Der kostenlose Tarif beinhaltet 1,000 Credits und fünf gleichzeitige Verbindungen pro Monat.
1,000 kostenlose Credits monatlich
10) ScrapingBee
ScrapingBee ist eine API zum Sammeln von Seiten, die Browser, Proxys oder Standortkontrollen erfordern. JavaDie Skriptwiedergabe lädt interaktive Inhalte, während klassische, Premium- und Stealth-Verbindungen unterschiedliche Schwierigkeitsgrade abdecken. Screenshot- und Such-APIs erweitern die Funktionen desselben Kontos über den HTML-Abruf hinaus.
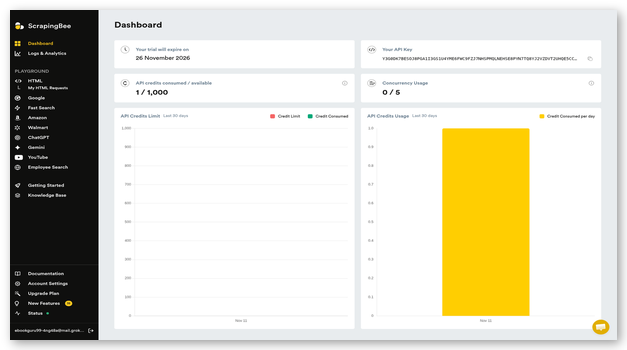
Das Dashboard bietet einen API-Schlüssel, einen Anfragegenerator, eine Guthabenschätzung und den Nutzungsverlauf. Entwickler können benutzerdefinierte Header hinzufügen oder JavaSkriptszenarien für Klicks und Scrollen. KI-Beispieletraction akzeptiert Feldanweisungen in einfacher Sprache. ScrapingBee ist für API-Nutzer leicht zugänglich, allerdings können aktivierte Optionen die Kreditkosten stark verändern.
Merkmale:
- HTML-API: Die HTML-API liefert gerenderten oder ungerenderten Seiteninhalt über einen einzigen Endpunkt. Entwickler können Proxy-Level, Speicherort, Header und Browserverhalten steuern.
- JS-Szenarien: Maßgeschneidert JavaSkriptszenarien können vor der Erfassung klicken, scrollen, warten oder interagieren. Dies unterstützt Seiten, auf denen Inhalte erst nach Benutzeraktionen angezeigt werden.
- Proxy-Ebenen: Klassische, Premium- und Stealth-Routen decken unterschiedliche Blockierungsstufen ab. Teams können mit einem kostengünstigeren Zugang beginnen und diesen nur bei Bedarf eskalieren.
- KI-Extraction: Anfragen in einfacher Sprache und BeispieletracDie Regeln identifizieren die angeforderten Felder. Dies reduziert den Selektoraufwand, wenn Teams beim Seitenwechsel schnell ein strukturiertes Ergebnis benötigen.
- Screenshot-API: Screenshot-Anfragen erfassen entweder ganze Seiten oder ausgewählte Elemente. Überwachungsteams können visuelle Beweise zusammen mit den Screenshots speichern.tracted Werte und Änderungsdatensätze.
- Anfragegenerator: Der Dashboard-Generator erstellt Code und zeigt die geschätzten Kreditkosten an. Entwickler können Parameter überprüfen, bevor sie diese einer Anwendung hinzufügen.
- Kostenlose Credits: Jedes neue Konto erhält 1,000 API-Credits ohne Angabe einer Zahlungskarte. Das Guthaben dient der Evaluierung, wird aber nicht als zeitlich begrenzte Testversion verlängert.
Vorteile
Nachteile
👉 Wie man erhält ScrapingBee kostenlos?
- Öffne ScrapingBee und ein neues Konto ohne Karte registrieren.
- Verwenden Sie den Dashboard-Anfragegenerator, um einen Testaufruf zu generieren.
- Jedes neue Konto erhält 1,000 kostenlose API-Credits zur Evaluierung.
1,000 kostenlose Anmelde-Credits
Funktionsvergleichstabelle der Top-Web-Scraperping Zubehör
Wie haben wir die besten kostenlosen Web-Scraper ausgewählt?ping Werkzeuge?

At Guru99Wir sind bestrebt, genaue, relevante und objektive Informationen bereitzustellen, damit Nutzer fundierte Entscheidungen treffen können. Unser redaktioneller Prozess konzentriert sich auf die Bereitstellung informativer und zuverlässiger Ressourcen und stellt sicher, dass die Inhalte glaubwürdig und vertrauenswürdig sind. Nach Überprüfung von über 18 der besten Web-Scraping-Toolsping WerkzeugeWir haben eine umfassende Auswahl an kostenlosen und kostenpflichtigen Optionen zusammengestellt, basierend auf Funktionen, Vor- und Nachteilen sowie Preisen. Dieser Leitfaden bietet Ihnen ein detailliertes Verständnis der einzelnen Tools und hilft Ihnen bei der Auswahl des optimalen Tools für Ihre Anforderungen. Wir konzentrieren uns bei der Bewertung eines Tools auf Funktionalität, Benutzerfreundlichkeit und Vielseitigkeit auf die folgenden Faktoren.
- Einfache Bedienung: Wir haben Tools aufgrund ihrer benutzerfreundlichen Oberfläche ausgewählt, die sowohl Anfängern als auch Experten ein reibungsloses Scraping der Daten ermöglichen.
- Effizienz: Die Experten in unserem Team priorisierten Tools, die auf Effizienz optimiert sind und einen schnellen und genauen Datenexport gewährleisten.traction ohne Kompromisse.
- Sicherheit: Wir haben darauf geachtet, Tools mit starken Sicherheitsfunktionen in die engere Auswahl zu nehmen, um sensible Daten zu schützen und die Privatsphäre zu wahren.
- Anpassungsfähigkeit: Wir haben die Tools danach ausgewählt, ob sie mit verschiedenen Websites und Benutzeroberflächen zurechtkommen.tracDaten in verschiedenen Formaten problemlos verarbeiten.
- Gemeinschaftliche Unterstützung: Unser Team hat Tools mit aktiven Communities und zuverlässigem Kundensupport in Betracht gezogen, um Probleme effektiv zu lösen.
- Flexibilität: Wir haben Tools ausgewählt, die eine individuelle Anpassung ermöglichen und so sicherstellen, dass sie den spezifischen Anforderungen verschiedener Benutzer und Projekte gerecht werden.
Was ist Web-Scraping?ping Welches Werkzeug und wie funktioniert es?
Web-Scrapingping Das Tool fordert eine Webseite an, liest deren Inhalt und gibt diesen aus.tracDie ausgewählten Felder werden in ein strukturiertes Format umgewandelt. Einige Tools parsen HTML direkt. Andere verwenden einen Browser, um dies zu ermöglichen. JavaDas Skript kann zuerst geladen werden. Verwaltete APIs rotieren außerdem Proxys, wiederholen blockierte Anfragen und geben Ergebnisse über einen einzigen Endpunkt zurück. Der Workflow beginnt üblicherweise mit einem URL und extracDie Regel für die Datenverarbeitung endet mit Datensätzen im JSON-, CSV- oder Datenbankformat. Anfänger sollten zunächst entscheiden, ob sie Seiten, strukturierte Felder, Screenshots oder wiederholte Überwachung benötigen. Diese Wahl bestimmt den passenden Tool-Typ.
Welches kostenlose Zugriffsmodell passt zu Ihrem Web-Scraping?ping Projekt?
Kostenloser Zugang kann ein dauerhaftes monatliches Kontingent, einmalige Anmeldeguthaben, eine zeitlich begrenzte Testphase oder eine kostenpflichtige Evaluierung umfassen. Diese Modelle sind nicht austauschbar. Ein Abonnement mit automatischer Verlängerung eignet sich für kleinere, regelmäßig wiederkehrende Aufgaben. Einmalige Guthaben sind besser geeignet, um eine Integration zu testen. Zeitlich begrenzte Testphasen helfen, Support und anspruchsvolle Ziele schnell zu evaluieren. Kostenpflichtige Testphasen bieten oft qualitativ hochwertigeren Proxy-Traffic als ein kostenloses Angebot. Prüfen Sie, ob eine Kreditkarte erforderlich ist, wofür Guthaben verbraucht wird und ob ungenutztes Kontingent verfällt. Die beste Option entspricht Ihrer Anfragehäufigkeit, dem Schwierigkeitsgrad Ihres Ziels und Ihrer Bereitschaft, später gegebenenfalls Anpassungen vorzunehmen.
Auf welche Merkmale sollte man beim Web-Scraping achten?ping Werkzeuge?
Nützliche Funktionen hängen von der jeweiligen Aufgabe ab. Beginnen Sie daher mit dem Ziel und dem erforderlichen Ergebnis. Diese Prüfungen decken die wichtigsten Kaufentscheidungen ab:
- Rendering: JavaDie Unterstützung von Skripten ist dann wichtig, wenn die benötigten Daten erst nach der ersten HTML-Antwort erscheinen.
- Zugangskontrolle: Proxy-Rotation, Sitzungen und Standortausrichtung bestimmen, ob Anfragen regionale oder geschützte Seiten erreichen.
- Ausgang: JSON, CSV, Markdown, Screenshots und rohes HTML dienen unterschiedlichen Analyse- und Beweisanforderungen.
- Operanationen: Planung, Wiederholungsversuche, Protokolle, Warnmeldungen und Ausgabenlimits sorgen dafür, dass wiederkehrende Aufgaben beobachtbar und kontrollierbar bleiben.
- Kundendienst: Eine klare Dokumentation und ein reaktionsschneller Support reduzieren Ausfallzeiten bei Änderungen von Zielen oder Anforderungsregeln.
Wie schaben?ping Wie verhalten sich APIs zu Proxys und Browser-Tools?
Scharfping APIs verwalten Anfragen, Wiederholungsversuche und oft auch das Rendering hinter einem einzigen Endpunkt. Sie eignen sich für Teams, die Ergebnisse ohne den Betrieb einer eigenen Netzwerkinfrastruktur erzielen möchten. Proxy-Dienste leiten den Datenverkehr lediglich weiter, sodass Benutzer weiterhin Crawler, Parser, Speicher und Fehlerbehandlung benötigen. Browser-Tools laufen JavaSkripte und Simulationen von Aktionen wie Klicken oder Scrollen ermöglichen die Verarbeitung interaktiver Seiten, benötigen aber mehr Rechenressourcen. Viele Produktionssysteme kombinieren diese Ansätze. Ein Proxy kann einen benutzerdefinierten Crawler unterstützen, während ein verwalteter Browser komplexe Seiten verarbeitet. Wählen Sie die einfachste Methode, die zuverlässig die benötigten Daten liefert.
Wie kann KI das Web-Scraping verbessern?ping Arbeitsabläufe?
KI kann Feldanfragen in einfacher Sprache in explizite Sprache übersetzen.tracKI kann Regeln anwenden, unstrukturierte Werte normalisieren und saubereres JSON oder Markdown erzeugen. Sie kann auch helfen, Selektoren bei Änderungen des Seitenlayouts zu reparieren. Diese Funktionen verkürzen die Einrichtungszeit, insbesondere für Prototypen und Forschungsprojekte. Die Notwendigkeit der Validierung entfällt dadurch jedoch nicht. Modelle können Felder falsch beschriften, versteckte Seitennavigationen übersehen oder nicht zusammengehörige Werte zusammenführen. Teams sollten daher Beispiele mit der Quellseite vergleichen und Änderungen im Zeitverlauf überwachen. KI eignet sich am besten als Unterstützung bei kontrollierten Anfragen, klaren Schemata und wiederholbaren Qualitätsprüfungen.
Wie funktioniert Web-Scraping?ping Tools verbinden sich mit Daten-Workflows?
Web-Scrapingping Tools verbinden sich üblicherweise über REST-APIs, SDKs, Webhooks, Cloud-Speicher oder Automatisierungsplattformen. Ein geplanter Job kann Seiten erfassen, Datensätze in einem Dataset speichern und einen Completion-Webhook senden. Ein anderer Dienst kann die Daten anschließend validieren, transformieren oder in ein Data Warehouse laden. KI-Workflows nutzen zunehmend MCP- oder Markdown-Ausgabe, um Forschungsagenten aktuelle Seiten bereitzustellen. Die Integration sollte außerdem den Ausführungsstatus, Zeitstempel und Fehler enthalten. Ohne diesen Kontext können nachgelagerte Systeme neue Datensätze nicht von unvollständigen oder fehlgeschlagenen Erfassungen unterscheiden.
Ist Web-Scrapingping legal und sicher?
Web-Scrapingping Es kann rechtmäßig sein, aber die Rechtmäßigkeit hängt von den Daten, der Zugriffsmethode, der Gerichtsbarkeit und dem Verwendungszweck ab. Ein verantwortungsvolles Projekt sollte diese Prüfungen dokumentieren:
- Öffentlicher Zugang: Es dürfen nur Informationen gesammelt werden, die rechtmäßig zugänglich und für einen definierten Geschäfts- oder Forschungszweck relevant sind.
- Website-Regeln: RevNutzungsbedingungen, Roboterrichtlinien, KontaktinformationentracVor der Datenerhebung sollten die tatsächlichen Grenzen und die geltenden lokalen Gesetze beachtet werden.
- Persönliche Daten: Minimieren Sie die Datenerfassung, sichern Sie gespeicherte Datensätze und beachten Sie die Datenschutzbestimmungen für identifizierbare Informationen.
- Anfragelast: Verwenden Sie angemessene Tarife und Caching, damit der automatisierte Datenverkehr die Zielwebsite nicht beeinträchtigt.
- Rechtliche Überprüfung: Bei Projekten mit sensiblen Daten, Konten, Authentifizierung oder unklaren Einschränkungen sollten Sie qualifizierten Rat einholen.
Wie kann man Web-Scraping verhindern?ping Datenqualität?
Datenqualität beginnt mit einem klaren Schema und repräsentativen Testseiten. Validieren Sie Feldtypen, Pflichtfelder, Paginierung, Duplikate und Zeitstempel vor der Skalierung. Speichern Sie neben den analysierten Datensätzen eine kleine Stichprobe der Rohdaten, um Fehler zu erkennen. traceable. Überwachen Sie die Anzahl der Datensätze und die Quote fehlender Felder über mehrere Durchläufe hinweg. Layoutänderungen erzeugen oft plausible, aber fehlerhafte Ausgaben, die schwerer zu erkennen sind als eine fehlgeschlagene Anfrage. Version extracDie Regeln für die Datenerhebung sollten überprüft und die Stichproben nach jeder Änderung verglichen werden. Bei wichtigen Datensätzen sollten vor der Veröffentlichung der Schlussfolgerungen unabhängige Prüfungen anhand vertrauenswürdiger Quellen durchgeführt werden.
Wie funktioniert Web-Scraping?ping Ändern sich die Kosten mit zunehmender Projektgröße?
Die Kosten steigen mit dem Anfragevolumen, den gerenderten Seiten, Premium-Proxys, der Parallelverarbeitung, dem Speicherplatz und dem Support. URL kann mehrere Credits verbrauchen, wenn JavaSkriptbasierte, standortbezogene oder erweiterte Umgehungsfunktionen sind aktiviert. Fehlgeschlagene Zugriffsversuche sind bei einigen APIs kostenlos, bei anderen jedoch kostenpflichtig. Berechnen Sie die Kosten anhand einer repräsentativen Stichprobe, nicht anhand der reinen Anzahl der Anfragen. Berücksichtigen Sie den Entwicklungsaufwand für die Wartung und Überwachung des Parsers. Eine verwaltete API kann zwar pro Ergebnis teurer sein, reduziert aber den Betriebsaufwand. Legen Sie Ausgabenlimits fest, überprüfen Sie die Nutzung nach Ziel und trennen Sie Test- von Produktionszugangsdaten.
Welche Probleme verursachen Web ScraperWarum Fehler auftreten und wie lassen sie sich beheben?
Scrapers schlagen normalerweise fehl, weil das Seitenverhalten, die Zugriffsregeln oder extracDie Annahmen bezüglich der Fehlerbehebung haben sich geändert. Jede Korrektur sollte die beobachtete Ursache beheben, anstatt blindlings erneut zu versuchen, die Ursache zu finden.
- Problem: Eine Seite gibt leeren HTML-Code zurück, weil der Inhalt über einen anderen Weg geladen wird. JavaSkript nach der ersten Antwort.
Lösung: Der Operator sollte das Browser-Rendering aktivieren und auf einen stabilen Selektor warten, bevor er extracdas Ausfüllen der angeforderten Felder. - Problem: Wiederholte Anfragen lösen CA ausPTCHAs, Ratenbegrenzungen oder temporäre Sperren während größerer Datenerfassungsläufe.
Lösung: Das Team sollte die Anfragegeschwindigkeit reduzieren, geeignete Proxys rotieren lassen, Sitzungen sorgfältig wiederverwenden und die Zugriffsregeln der Website beachten. - Problem: Eine neu gestaltete Seite verschiebt Felder und erzeugt stillschweigend leere oder nicht übereinstimmende Werte.
Lösung: Der Maintainer sollte die Selektoren versionieren, Rohdaten beibehalten und eine Warnung ausgeben, wenn die Vollständigkeit der Pflichtfelder unter einen vereinbarten Schwellenwert fällt. - Problem: Die Paginierung wird frühzeitig abgebrochen, sodass spätere Produkte, Kommentare oder Einträge nicht mehr im endgültigen Datensatz enthalten sind.
Lösung: Der Entwickler sollte die Logik der nächsten Seite testen, die Seitenanzahl erfassen und die gesammelten Summen mit den sichtbaren Quellindikatoren vergleichen. - Problem: Der Kreditverbrauch steigt unerwartet an, wenn Rendering, Premium-Routen oder schwierige Ziele aktiviert werden.
Lösung: Der Eigentümer sollte zunächst repräsentative Anfragen abschätzen, Ausgabenlimits festlegen und teure Ziele in überwachte Arbeitsabläufe aufteilen. - Problem: Duplikat URLs oder retries erzeugen wiederholte Datensätze, die die Zählungen und die nachfolgende Analyse verfälschen.
Lösung: Die Pipeline sollte stabile Datensatzschlüssel zuweisen und normalisieren. URLs und entfernen Sie Duplikate, bevor Datensätze in Berichte oder den Speicher gelangen.
Welche Trends werden das Web-Scraping prägen?ping Als nächstes Werkzeuge?
Web-Scrapingping Plattformen bewegen sich in Richtung KI-gestützter Prozesse.tracDie Vorteile liegen in der Zusammenarbeit mit Agenten und einer flexibleren Browserinfrastruktur. Klartextschemata verkürzen die Einrichtung, während MCP-Integrationen es Forschungsagenten ermöglichen, aktuelle Seiten über kontrollierte Tools anzufordern. Anbieter kombinieren außerdem Scraping.pingSuchvorgänge, Crawling und Browseraktionen hinter gemeinsam genutzten Konten werden verstärkt. Compliance und Datenherkunft rücken in den Fokus, da die automatisierte Datenerfassung Geschäftsentscheidungen beeinflusst. Der positive Trend geht hin zu mehr Transparenz: Teams benötigen klare Anfragekosten, Quellzeitstempel usw.tracVersionsnummern und Fehlerursachen. Eine bessere Automatisierung sollte diese Kontrollen erleichtern, nicht verbergen.
Urteil
Ich habe die Auswahlliste hinsichtlich Zugriffsbeschränkungen, Workflow-Tiefe und Skalierungsanforderungen geprüft. Drei Optionen eigneten sich am besten für unterschiedliche Scraping-Anforderungen.ping Bedürfnisse.
- Oxylabs: Ich bevorzugte dessen verwaltetes Web Scraper API für schwierige Ziele, strukturierte Bereitstellung und Produktionssteuerung ohne die Notwendigkeit, eine separate Browser- und Proxy-Infrastruktur zu pflegen.
- Decodo: In meiner Bewertung habe ich es aufgrund des einfachen, kostenlosen API-Zugangs und der vorbereiteten Vorlagen auf Platz eins gesetzt. JavaSkriptwiedergabe und Ausgaben, die für Daten- oder KI-Workflows geeignet sind.
- NodeMaven: Ich habe es für Teams ausgewählt, die bereits Scrap besitzen.ping Code und benötigen detaillierte Standortausrichtung, Rotationskontrollen und geprüfte Proxy-Adressen.
