
Was ist Star Schema in der Data Warehouse-Modellierung?
 Redaktion
⚡ Intelligente Zusammenfassung
Das Sternschema in der Data-Warehouse-Modellierung platziert eine zentrale Faktentabelle im Zentrum umgebender Dimensionstabellen. Dadurch entsteht ein denormalisiertes, sternförmiges Design, das analytische Abfragen vereinfacht, die Berichterstellung beschleunigt und OLAP-Cubes auf Business-Intelligence-Plattformen unterstützt.
Was ist ein Sternschema?
A Sternschema In einem Data Warehouse ist ein Sternschema eine Modellierungsstruktur, in der eine zentrale Faktentabelle mit mehreren zugehörigen Dimensionstabellen verbunden ist. Es wird als Sternschema bezeichnet, da die Struktur einem Stern ähnelt, wobei sich die Faktentabelle im Zentrum befindet und die Dimensionstabellen wie Punkte nach außen strahlen.
Das Sternschema ist der einfachste Typ von Data-Warehouse-Schema und wird auch als Stern-Join-Schema bezeichnet. Da seine Dimensionstabellen denormalisiert sind, ist das Modell für die Abfrage sehr großer Datensätze optimiert und daher eine gängige Wahl für dimensionale Modellierung und Berichterstattung.
Was ist ein multidimensionales Schema?
A multidimensionales Schema ist speziell für die Modellierung von Data-Warehouse-Systemen konzipiert. Diese Schemata erfüllen die besonderen Anforderungen sehr großer Datenbanken, die für analytische Zwecke erstellt wurden. OLAP und nicht für die routinemäßige Transaktionsverarbeitung.
Arten von Data-Warehouse-Schemas: Es gibt drei Haupttypen von mehrdimensionalen Schemata, und jeder bietet seine eigenen Vorteile.
- Sternschema – eine zentrale Faktentabelle, die direkt mit denormalisierten Dimensionstabellen verknüpft ist.
- Snowflake-Schema – eine Erweiterung des Sternschemas, bei der die Dimensionen in zusätzliche Unterdimensionstabellen normalisiert werden.
- Galaxienschema – auch Faktenkonstellation genannt, verwendet sie mehrere Faktentabellen, die gemeinsame Dimensionstabellen verwenden.
Da das Snowflake-Schema direkt auf dem Sternschema aufbaut, ist es hilfreich, die beiden Modelle zu vergleichen, bevor man ein detailliertes Sternschema-Beispiel durcharbeitet.
Sternschema vs. Schneeflockenschema
Das Sternschema und das Schneeflockenschema Beide Schemata organisieren Daten anhand von Fakten- und Dimensionstabellen, unterscheiden sich aber in der Art der Dimensionsspeicherung. Ein Sternschema speichert jede Dimension in einer einzelnen denormalisierten Tabelle, während ein Schneeflockenschema diese Dimensionen in mehrere zusammengehörige Tabellen normalisiert.
- Struktur: Das Sternschema ist flach und einfach; das Schneeflockenschema verzweigt Dimensionen in Unterdimensionen.
- Abfragegeschwindigkeit: Sternschemata benötigen weniger Joins, daher laufen Abfragen in der Regel schneller und das SQL bleibt einfacher.
- Lagerung: Snowflake-Schemas beseitigen Redundanzen, benötigen daher weniger Speicherplatz, erhöhen aber die Designkomplexität.
- Datenintegrität: Normalisierte Schneeflockendimensionen gewährleisten eine bessere Integrität, während denormalisierte Sterndimensionen die Leistungsfähigkeit begünstigen.
- Einfache Anwendung: Ein Sternschema ist für Analysten einfacher zu verstehen und schneller zu pflegen, während ein Schneeflockenschema eine sorgfältigere Gestaltung erfordert.
In der Praxis entscheiden sich Teams oft für ein Sternschema für Data Marts und Dashboards, die eine schnelle und unkomplizierte Berichterstellung erfordern, und für ein Schneeflockenschema, wenn Speicherplatzersparnis und strikte Konsistenz wichtiger sind.
Beispiel für ein Sternschema
Im folgenden Sternschema-Beispiel befindet sich die Faktentabelle im Zentrum und enthält die Schlüssel zu jeder Dimensionstabelle, wie z. B. Dealer_ID, Model_ID, Date_ID, Product_ID und Branch_ID, sowie messbare Attribute wie verkaufte Einheiten und Umsatz.
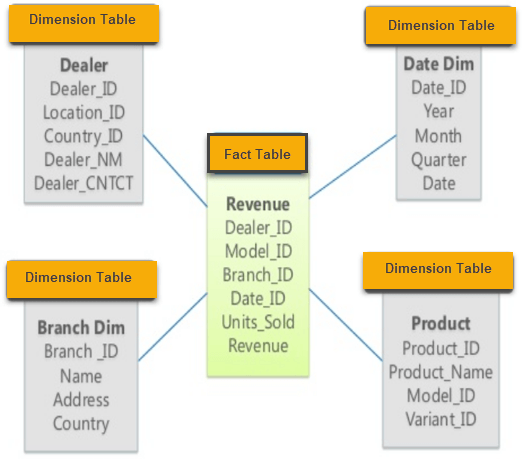
Jede umgebende Dimensionstabelle fügt diesen Kennzahlen beschreibenden Kontext hinzu, sodass eine einzige Abfrage die Verkaufsdaten nach Händler, Modell, Datum, Produkt oder Filiale gruppieren oder filtern kann, ohne dass andere Tabellen verknüpft werden müssen.
Faktentabellen
Eine Faktentabelle in einem Sternschema enthält Fakten und ist mit den Dimensionen verknüpft. Eine Faktentabelle enthält zwei Arten von Spalten:
- Eine Spalte, in der die Fakten oder Kennzahlen gespeichert werden.
- Fremdschlüssel, die mit den einzelnen Dimensionstabellen verknüpfen.
Im Allgemeinen ist der Primärschlüssel einer Faktentabelle ein zusammengesetzter Schlüssel, der aus allen Fremdschlüsseln der Tabelle besteht.
Faktentabellen können detaillierte oder aggregierte Fakten enthalten. Faktentabellen mit aggregierten Fakten werden oft als Übersichtstabellen bezeichnet und enthalten in der Regel bereits aggregierte Fakten.
Maßtabellen
Eine Dimension ist eine Struktur, die Daten hierarchisch kategorisiert. Eine Dimension ohne Hierarchien und Ebenen wird als flache Dimension oder Liste bezeichnet. Der Primärschlüssel jeder Dimensionstabelle ist Teil des zusammengesetzten Primärschlüssels der Faktentabelle.
Ein Dimensionsattribut ist ein beschreibendes, textuelles Attribut, das einen Dimensionswert wie beispielsweise einen Produktnamen oder eine Stadt beschreibt. Da Dimensionstabellen diesen beschreibenden Kontext und nicht Transaktionsereignisse speichern, sind Faktentabellen in der Regel wesentlich größer als Dimensionstabellen.
Wie man ein Sternschema entwirft
Die Entwicklung eines Sternschemas folgt dem von Ralph Kimball bekannt gemachten Ansatz der dimensionalen Modellierung. Ziel ist es, Geschäftskennzahlen anhand klarer, wiederverwendbarer Dimensionen zu organisieren, sodass das fertige Modell leicht abzufragen und schnell auszuwerten ist. Die folgenden fünf Schritte beschreiben den Prozess, dem die meisten Projekte zur dimensionalen Modellierung folgen – von der übergeordneten Geschäftsfrage bis hin zu den physischen Fakten- und Dimensionstabellen.
- Identifizieren Sie den Geschäftsprozess: Wählen Sie die Aktivität aus, die Sie analysieren möchten, z. B. Umsatz, Versandpingoder den Lagerbestand. Diese Entscheidung legt fest, was die Faktentabelle messen soll.
- Getreide deklarieren: Legen Sie den Detaillierungsgrad jeder Datenzeile fest, beispielsweise eine Zeile pro Position, pro Transaktion oder pro Tag. Eine klare Strukturierung gewährleistet die Konsistenz des Modells.
- Ermitteln Sie die Dimensionen: Geben Sie den beschreibenden Kontext an, der zur Segmentierung der Fakten benötigt wird, z. B. Produkt, Kunde, Händler, Filiale und Datum. Jeder dieser Kontexte wird zu einer Dimensionstabelle mit Attributen.
- Identifizieren Sie die Fakten: Ermitteln Sie die numerischen Kennzahlen, die das Unternehmen anstrebt. track, wie z. B. verkaufte Einheiten, Umsatz oder Kosten, und fügen Sie diese in die zentrale Faktentabelle ein.
- Baue den Stern: Verbinde die Faktentabelle über Fremdschlüssel mit jeder Dimension.ping Die Dimensionen wurden denormalisiert, sodass das Diagramm eine einzige zentrale Faktentabelle bildet, die von ihren Dimensionen umgeben ist.
Nachdem das Sternschema erstellt wurde, fügen Sie jeder Dimension einen künstlichen Schlüssel hinzu, stellen Sie sicher, dass jede Faktentabelle eine zugehörige Datumsdimension besitzt, und vergewissern Sie sich, dass alle Fakten auf derselben Granularität vorliegen. Es empfiehlt sich außerdem, atomare Daten der niedrigsten Ebene zuerst zu laden, da Zusammenfassungstabellen später jederzeit abgeleitet werden können. Die Einhaltung dieser Regeln sorgt für ein optimiertes Schema mit hoher Performance und einfacher Handhabung. Data Warehouse Berichterstattung.
Eigenschaften des Sternschemas
- In einem Sternschema wird jede Dimension durch genau eine Dimensionstabelle repräsentiert.
- Jede Dimensionstabelle enthält ihre eigenen Attribute.
- Die Dimensionstabelle ist über einen Fremdschlüssel mit der Faktentabelle verknüpft.
- Die Dimensionstabellen sind nicht miteinander verknüpft.
- Die Faktentabelle enthält Schlüssel und Kennzahlen.
- Das Sternschema ist leicht verständlich und bietet eine optimale Festplattennutzung.
- Die Dimensionstabellen sind nicht normalisiert. Beispielsweise verfügt im obigen Beispiel Country_ID nicht über eine separate Country-Lookup-Tabelle, wie es bei einer anderen Tabelle der Fall ist. OLTP Das Design würde.
- Das Schema wird von BI-Tools weitgehend unterstützt.
Vorteile des Sternschemas
Das Sternschema bietet mehrere Vorteile, die es zu einem beliebten Ausgangspunkt für das Design von Data Warehouses machen:
- Sternschemata verwenden eine einfachere Join-Logik als andere Schemata beim Abrufen von Daten aus hochgradig normalisierten Transaktionsquellen.
- Das Sternschema vereinfacht gängige Geschäftsberichtslogiken, wie z. B. Periodenvergleiche und Stichtagsberichte.
- Sternschemata werden von OLAP-Systemen häufig verwendet, um Cubes effizient zu erstellen, und ein Sternschema kann in den meisten großen OLAP-Systemen als Quelle dienen, ohne dass eine Cube-Struktur entworfen werden muss.
- Durch die Aktivierung spezifischer Leistungsoptimierungen, die auf Abfragen angewendet werden können, kann der Abfrageprozessor bessere Ausführungspläne anbieten.
Nachteile des Sternschemas
- Da das Schema stark denormalisiert ist, wird die Datenintegrität nicht konsequent durchgesetzt.
- Es ist hinsichtlich fortgeschrittener Analyseanforderungen nicht flexibel genug.
- Sternschemata verstärken keine Viele-zu-Viele-Beziehungen zwischen Geschäftseinheiten.
Wann verwendet man ein Sternschema?
Ein Sternschema ist die richtige Wahl, wenn schnelle und vorhersehbare Abfrageleistung wichtiger ist als Speicherplatzersparnis. Da das Modell seine Dimensionstabellen denormalisiert hält und die Anzahl der Joins gering ist, eignet es sich für analytische Workloads, bei denen Anwender regelmäßig ähnliche Berichte, Dashboards und Aggregationen über große Mengen historischer Daten ausführen.
Typische Situationen, in denen ein Sternschema gut geeignet ist, sind beispielsweise:
- Data Marts: Abteilung Datamarts mit einfachen, gut verständlichen Beziehungen profitieren von der übersichtlichen Struktur.
- BI-Dashboards: Business Intelligence Die Tools lassen sich sauber auf Sternschemata abbilden, sodass Berichte und Visualisierungen schnell erstellt werden können.
- OLAP-Cubes: Sternschemata sind eine natürliche Quelle für OLAP-Cubes, Aggregation und Slice-and-Dice-Analysen.
Wenn der Schwerpunkt stattdessen auf minimalem Speicherbedarf, strikter Datenintegrität oder tiefgreifenden, sich verändernden Hierarchien liegt, eignen sich ein Snowflake-Schema oder ein stärker normalisiertes Design möglicherweise besser. Viele Teams kombinieren sogar beide Ansätze, indem sie mit einem Sternschema beginnen und nur die Dimensionen normalisieren, die dies tatsächlich erfordern.
