
Seq2seq (Sequence to Sequence) Modell mit PyTorch
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
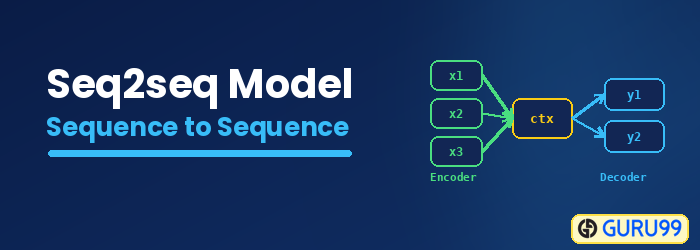
Seq2Seq ist eine Encoder-Decoder-Architektur, die eine Eingabesequenz mithilfe zweier rekurrenter neuronaler Netze auf eine Ausgabesequenz abbildet und so die maschinelle Übersetzung sowie andere Aufgaben der natürlichen Sprachverarbeitung ermöglicht, bei denen sich Eingabe- und Ausgabelänge unterscheiden.
Was ist NLP?
NLP oder Natural Language Processing (Verarbeitung natürlicher Sprache) ist einer der populären Zweige der künstlichen Intelligenz, der Computern hilft, Menschen in ihrer natürlichen Sprache zu verstehen, zu verarbeiten und auf sie zu reagieren. NLP ist der Motor hinter Google Translate Das hilft uns, andere Sprachen zu verstehen.
Was ist Seq2Seq?
Seq2Seq ist eine Methode der Encoder-Decoder-basierten maschinellen Übersetzung und Sprachverarbeitung, die eine Sequenzeingabe einer Sequenzausgabe mit einem Tag und einem Aufmerksamkeitswert zuordnet. Die Idee besteht darin, zwei RNNs zu verwenden, die mit einem speziellen Token zusammenarbeiten und versuchen, die nächste Zustandssequenz aus der vorherigen Sequenz vorherzusagen.
So prognostizieren Sie die Sequenz aus der vorherigen Sequenz
Im Folgenden sind die Schritte zur Vorhersage einer Sequenz aus der vorherigen Sequenz mit Py aufgeführt.Torch.
Schritt 1) Laden unserer Daten
Für unseren Datensatz verwenden Sie einen Datensatz von Durch Tabulatoren getrennte zweisprachige Satzpaare. Hier verwende ich den Englisch-Indonesisch-Datensatz. Sie können alles auswählen, was Sie möchten, aber denken Sie daran, den Dateinamen und das Verzeichnis im Code zu ändern.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Schritt 2) Datenvorbereitung
Sie können den Datensatz nicht direkt verwenden. Sie müssen die Sätze in Wörter aufteilen und diese in einen One-Hot-Vektor umwandeln. Jedes Wort wird in der Klasse `Lang` eindeutig indiziert, um ein Wörterbuch zu erstellen. Die Klasse `Lang` speichert jeden Satz und teilt ihn Wort für Wort mit `addSentence` auf. Anschließend wird ein Wörterbuch erstellt, indem jedes unbekannte Wort für Sequenz-zu-Sequenz-Modelle indiziert wird.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Die Klasse `Lang` hilft uns beim Erstellen eines Wörterbuchs. Für jede Sprache wird jeder Satz in Wörter zerlegt und diese dann einem Container hinzugefügt. Jeder Container speichert die Wörter im entsprechenden Index, zählt die Wörter und fügt den Index des Wortes hinzu, sodass wir den Index eines Wortes oder ein Wort anhand seines Index finden können.
Da unsere Daten durch TAB getrennt sind, müssen Sie sie verwenden Pandas Pandas dient uns als Datenlader. Pandas liest unsere Daten als DataFrame ein und teilt sie in Quell- und Zielsatz auf. Jeder Satz wird in Kleinbuchstaben umgewandelt, alle Nicht-Zeichen werden entfernt, Unicode wird in ASCII konvertiert und die Sätze werden so aufgeteilt, dass jedes Wort einzeln enthalten ist.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Eine weitere nützliche Funktion ist die Umwandlung von Wortpaaren in Tensoren. Dies ist sehr wichtig, da unser Netzwerk ausschließlich Tensor-Daten verarbeitet. Außerdem wird hier am Ende jedes Satzes ein Token eingefügt, das dem Netzwerk signalisiert, dass die Eingabe abgeschlossen ist. Für jedes Wort im Satz wird der Index des entsprechenden Wortes im Wörterbuch ermittelt und am Ende des Satzes ein Token angehängt.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Seq2Seq-Modell

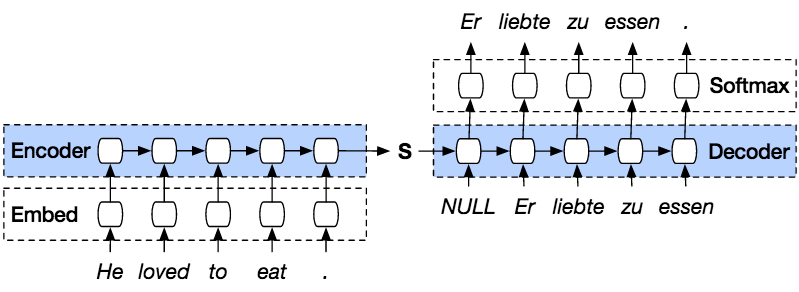
PyTorDas ch-Seq2Seq-Modell ist eine Art von Modell, das Py verwendet.TorDas Modell besteht aus einem Encoder und einem Decoder. Der Encoder kodiert den Satz Wort für Wort in einen Index bekannter Wörter. Der Decoder sagt die Ausgabe der kodierten Eingabe voraus, indem er die Eingabe sequenziell dekodiert und versucht, die letzte Eingabe als nächste zu verwenden, sofern möglich. Mit dieser Methode lässt sich auch die nächste Eingabe vorhersagen, um einen Satz zu bilden. Jedem Satz wird ein Token zugewiesen, der das Ende der Sequenz markiert. Am Ende der Vorhersage wird ebenfalls ein Token gesetzt, der das Ende der Ausgabe markiert. Der Encoder übergibt also einen Zustand an den Decoder, damit dieser die Ausgabe vorhersagen kann.

Der Encoder kodiert unseren Eingabesatz Wort für Wort nacheinander. Am Ende des Satzes markiert ein Token das Satzende. Der Encoder besteht aus einer Embedding-Schicht und einer GRU-Schicht. Die Embedding-Schicht ist eine Lookup-Tabelle, die die Einbettung unserer Eingabe in ein Wörterbuch fester Größe speichert. Diese wird an die GRU-Schicht übergeben. Die GRU-Schicht ist eine Gated Recurrent Unit (GRU) mit mehreren Schichten. RNN Dadurch wird die sequenzierte Eingabe berechnet. Diese Ebene berechnet den verborgenen Zustand aus dem vorherigen und aktualisiert die Reset-, Update- und neuen Gates.

Der Decoder dekodiert die Eingabe aus der Ausgabe des Encoders. Er versucht, die nächste Ausgabe vorherzusagen und diese, falls möglich, als nächste Eingabe zu verwenden. Der Decoder besteht aus einer Embedding-Schicht, einer GRU-Schicht und einer linearen Schicht. Die Embedding-Schicht erstellt eine Lookup-Tabelle für die Ausgabe und übergibt diese an die GRU-Schicht, um den vorhergesagten Ausgabezustand zu berechnen. Anschließend berechnet die lineare Schicht die Aktivierungsfunktion, um den tatsächlichen Wert der vorhergesagten Ausgabe zu bestimmen.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Schritt 3) Trainieren des Modells
Der Trainingsprozess in Seq2Seq-Modellen beginnt mit der Umwandlung jedes Satzpaares in einen Tensor anhand seines Lang-Index. Unser Sequence-to-Sequence-Modell verwendet SGD als Optimierer und die NLLLoss-Funktion zur Verlustberechnung. Der Trainingsprozess startet, indem dem Modell jeweils ein Satzpaar zugeführt wird, um die korrekte Ausgabe vorherzusagen. In jedem Schritt wird die Modellausgabe mit den korrekten Wörtern verglichen, um die Verluste zu ermitteln und die Parameter zu aktualisieren. Da 75000 Iterationen verwendet werden, generiert unser Sequence-to-Sequence-Modell 75000 zufällige Paare aus unserem Datensatz.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Schritt 4) Testen Sie das Modell
Der Evaluierungsprozess von Seq2seq PyTorDie Überprüfung der Modellausgabe erfolgt durch Eingabe jedes Sequence-to-Sequence-Modellpaares, das die vorhergesagten Wörter generiert. Anschließend wird der höchste Wert jeder Ausgabe ermittelt, um den korrekten Index zu finden. Abschließend wird dieser mit der Modellvorhersage verglichen.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Nun beginnen wir unser Training mit Seq to Seq, mit einer Anzahl von Iterationen von 75000 und einer Anzahl von RNN-Schichten von 1 mit einer Hidden-Layer-Größe von 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Wie Sie sehen, stimmt unser vorhergesagter Satz nicht sehr gut überein. Um eine höhere Genauigkeit zu erzielen, müssen Sie also mit viel mehr Daten trainieren und versuchen, mithilfe von Sequenz-zu-Sequenz-Lernen mehr Iterationen und Schichten hinzuzufügen.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
