
Scikit-Learn-Tutorial: Installation und Scikit-Learn-Beispiele
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Scikit-learn ist die Open-Source-Bibliothek Python Eine Bibliothek, die Vorverarbeitung, Klassifizierung, Regression, Clustering und Modellauswahl hinter einer einzigen konsistenten Schnittstelle für Schätzer abdeckt und so einen kompletten Workflow für maschinelles Lernen von den Rohdaten bis zu den bewerteten Vorhersagen kurz, lesbar und reproduzierbar hält.
Was ist Scikit-Learn?
Scikit-lernen ist ein Open-Source Python Bibliothek für Maschinelles LernenEs unterstützt etablierte Algorithmen wie KNN, Gradient Boosting, Random Forest und SVM und basiert auf … NumPy und SciPy. Scikit-learn wird häufig in Kaggle-Wettbewerben sowie in führenden Technologieunternehmen eingesetzt. Es umfasst Vorverarbeitung, Dimensionsreduktion, Klassifizierung, Regression, Clustering und Modellauswahl.
Scikit-learn verfügt über eine der besten Dokumentationen aller Open-Source-Bibliotheken. Es bietet sogar ein interaktives Schätzdiagramm. Den richtigen Kostenvoranschlag auswählenDas führt Sie von der Größe Ihres Datensatzes zu einer Auswahlliste von Algorithmen, die es wert sind, ausprobiert zu werden.
Die folgende Abbildung veranschaulicht die Funktionsweise von Scikit-learn.
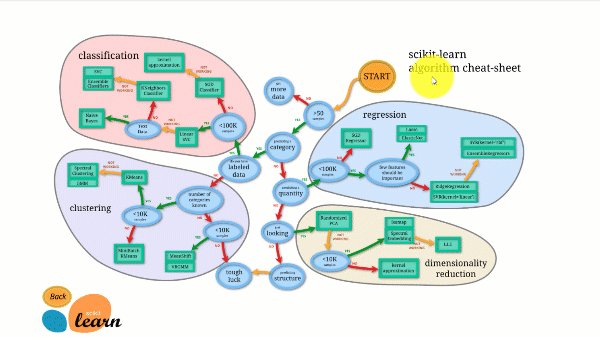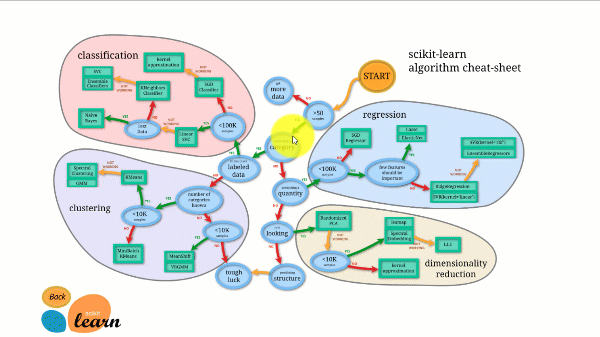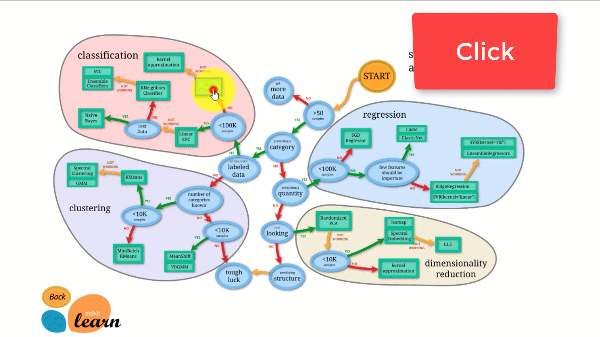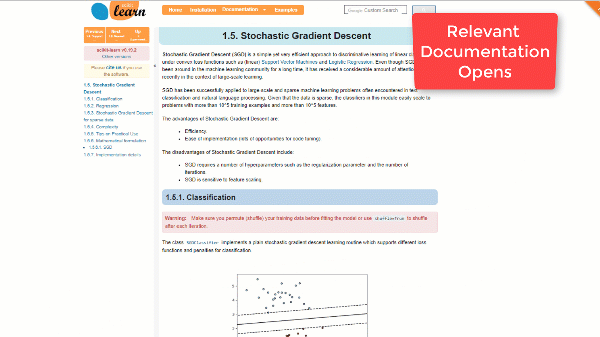
Scikit-learn ist einfach zu bedienen und liefert hervorragende Ergebnisse. Allerdings trainiert es auf der CPU: Die Arbeit wird mithilfe des Arguments `n_jobs` auf die Kerne verteilt, anstatt auf einer GPU. Die Ausführung eines Deep-Learning-Algorithmus ist damit zwar möglich, aber selten optimal, insbesondere wenn man bereits Erfahrung mit der Verwendung von Scikit-learn hat. TensorFlow.
So laden Sie Scikit-learn herunter und installieren es
Jetzt hier Python Scikit-learn-Tutorial: Hier erfahren Sie, wie Sie Scikit-learn herunterladen und installieren:
Option 1: AWS
Scikit-learn kann über AWS verwendet werden. Ein Docker-Image mit vorinstalliertem scikit-learn erspart den gesamten Einrichtungsaufwand.
Um die Entwicklerversion zu installieren, führen Sie den folgenden Befehl aus: Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Option 2: Mac oder Windows mit Anaconda
Informationen zur Installation von Anaconda finden Sie unter So laden Sie TensorFlow herunter und installieren es.
Zum Zeitpunkt der Erstellung dieser Anleitung hatten die Entwickler von scikit eine Entwicklungsversion veröffentlicht, die Probleme der damals aktuellen Version behob. Die folgenden Schritte verwenden daher diese Entwicklerversion. Auf einem neuen Rechner enthält die aktuelle stabile Version bereits alle hier verwendeten Transformer. pip install -U scikit-learn reicht.
So installieren Sie scikit-learn mit Conda Environment
Wenn Sie scikit-learn mit der Conda-Umgebung installiert haben, befolgen Sie die folgenden Schritte, um auf Version 0.20 zu aktualisieren.
Schritt 1) Aktivieren Sie die TensorFlow-Umgebung
source activate hello-tf
Schritt 2) Entfernen Sie scikit-learn mit dem conda-Befehl
conda remove scikit-learn
Schritt 3) Installieren Sie die Entwicklerversion
Installieren Sie die Entwicklerversion von scikit-learn zusammen mit den erforderlichen Bibliotheken.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
Anmerkungen: Windows Benutzer benötigen Microsoft visuell C++ 14. Du kannst es bekommen werden auf dieser Seite erläutert.
Scikit-Learn-Beispiel mit maschinellem Lernen
Dieses Scikit-Tutorial ist in zwei Teile unterteilt:
- Maschinelles Lernen mit scikit-learn
- So vertrauen Sie Ihrem Modell LIME an
Im ersten Teil wird detailliert beschrieben, wie man eine Pipeline aufbaut, ein Modell erstellt und die Hyperparameter optimiert, während der zweite Teil die Modellinterpretation behandelt.
Schritt 1) Importieren Sie die Daten
In diesem Scikit-learn-Tutorial verwenden Sie den Datensatz der Volkszählung für Erwachsene.
Die Datei wird im unten stehenden Code direkt aus dem UCI Machine Learning Repository gelesen, ein manueller Download ist also nicht erforderlich. Falls Sie sich für die deskriptiven Statistiken interessieren, lohnt sich ein Blick auf die Tools „Dive“ und „Overview“. Siehe auch Dieses Tutorial Um mehr über Tauchen und Überblick zu erfahren.
Sie importieren den Datensatz mit pandas. Beachten Sie, dass Sie die kontinuierlichen Variablen in das Float-Format konvertieren müssen.
Dieser Datensatz umfasst acht kategoriale Variablen, die in CATE_FEATURES aufgeführt sind:
- Arbeiterklasse
- Ausbildung
- ehelich
- Beruf
- Beziehung
- Rennen
- Sex
- Heimatland
Es umfasst außerdem sechs stetige Variablen, die in CONTI_FEATURES aufgeführt sind:
- Alter
- fnlwgt
- education_num
- Wertzuwachs
- Kapitalverlust
- Stunden_Woche
Die Listen werden hier manuell ausgefüllt, damit Sie einen besseren Überblick über die relevanten Spalten erhalten. Eine schnellere Methode zum Erstellen einer Liste kategorischer oder kontinuierlicher Spalten ist:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Hier ist der Code zum Importieren der Daten:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Der Aufruf von describe() für den Frame gibt die zusammenfassenden Statistiken für die sechs aufeinanderfolgenden Spalten zurück:
| Alter | fnlwgt | education_num | Wertzuwachs | Kapitalverlust | Stunden_Woche | |
|---|---|---|---|---|---|---|
| zählen | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| bedeuten | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| min | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Sie können die Anzahl der eindeutigen Werte des Merkmals „native_country“ überprüfen. Nur ein Haushalt stammt aus den Niederlanden. Dieser Haushalt liefert keine Informationen und führt während des Trainings zu einem Fehler.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Sie können diese nichtssagende Zeile aus dem Datensatz ausschließen:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Als Nächstes speichern Sie die Position der kontinuierlichen Features in einer Liste. Sie benötigen es im nächsten Schritt zum Aufbau der Pipeline.
Der unten stehende Code durchläuft alle Spaltennamen in CONTI_FEATURES, liest jede Position (d. h. ihre Spaltennummer) und fügt sie einer Liste namens conti_features hinzu.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Der nächste Block führt die gleiche Aufgabe für die kategorialen Variablen aus.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Betrachten wir nun den Datensatz selbst. Jedes kategoriale Merkmal ist eine Zeichenkette, und ein Modell kann nicht mit einem Zeichenkettenwert gefüttert werden, daher muss der Datensatz mit Dummy-Variablen transformiert werden.
df_train.head(5)
Tatsächlich benötigen Sie für jede Gruppe in jedem Feature eine Spalte. Führen Sie zunächst den unten stehenden Code aus, um die Gesamtzahl der benötigten Spalten zu berechnen.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Der gesamte Datensatz umfasst 101 Gruppen, wie oben dargestellt. Allein das Merkmal „Berufsgruppe“ enthält neun Gruppen. Die Namen der Gruppen können Sie mit dem folgenden Code auflisten; die Funktion `unique()` gibt die eindeutigen Werte jedes kategorialen Merkmals zurück.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Der Trainingsdatensatz wird daher 101 + 6 Spalten enthalten: die One-Hot-Gruppen plus die sechs kontinuierlichen Merkmale.
Scikit-learn kann die Konvertierung in zwei Schritten durchführen:
- Die Zeichenkette wird in eine ID umgewandelt. „State-gov“ wird zu ID 1, „Self-emp-not-inc“ zu ID 2 usw. LabelEncoder erledigt das für Sie.
- Jede ID wird in eine neue Spalte transponiert. Der Datensatz enthält 101 Gruppen-IDs, daher ergeben sich 101 Spalten, die jede Kategoriegruppe erfassen. Scikit-learn stellt hierfür den OneHotEncoder bereit.
Schritt 2) Erstellen Sie den Zug-/Testsatz
Nachdem der Datensatz nun fertig ist, teilen Sie ihn im Verhältnis 80/20 auf: 80 Prozent für den Trainingsdatensatz und 20 Prozent für den Testdatensatz.
Sie können `train_test_split` verwenden. Das erste Argument ist der Dataframe mit den Merkmalen, das zweite die Zielvariable. Die Größe des Testdatensatzes legen Sie mit `test_size` fest.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Schritt 3) Erstellen Sie die Pipeline
Die Pipeline vereinfacht die Versorgung des Modells mit konsistenten Daten. Die Idee besteht darin, die Rohdaten durch ein Objekt zu leiten, das alle Operationen der Reihe nach ausführt.
Bei diesem Datensatz müssen die stetigen Variablen standardisiert und die kategorialen Variablen umgewandelt werden. Jede Operation kann innerhalb einer Pipeline erfolgen: Fehlende Werte können durch den Mittelwert oder Median ersetzt und neue Variablen erstellt werden.
Sie haben die Wahl: Entweder Sie kodieren die beiden Prozesse fest oder Sie erstellen eine Pipeline. Durch die feste Kodierung können Testdaten in die angepassten Statistiken einfließen und im Laufe der Zeit Inkonsistenzen entstehen. Daher ist die Pipeline die bessere Option.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Die Pipeline führt zwei Operationen durch, bevor sie dem logistischen Klassifikator zugeführt wird:
- Variable standardisieren: StandardScaler()
- Konvertieren Sie die kategorialen Funktionen: OneHotEncoder(sparse=False)
Beide Schritte werden mit `make_column_transformer` ausgeführt. Zum Zeitpunkt der Erstellung dieser Anleitung war die Funktion noch nicht in der veröffentlichten Version von scikit-learn (0.19) enthalten, weshalb die Entwicklerversion verwendet wurde; sie ist seit Version 0.20 in jeder stabilen Version enthalten.
make_column_transformer ist unkompliziert: Sie deklarieren, welche Spalten transformiert werden sollen und welche Transformation angewendet werden soll. Um die kontinuierlichen Merkmale zu standardisieren, übergeben Sie Folgendes:
- conti_features, StandardScaler() innerhalb von make_column_transformer
- conti_features: die Liste der kontinuierlichen Spalten
- StandardScaler: standardisiert diese Spalten
Das OneHotEncoder-Objekt innerhalb von make_column_transformer codiert die Labels automatisch.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Versionshinweis: Zwei Argumente im obigen Block wurden weiterverfolgt. Aktuelle Versionen erwarten zuerst den Transformator und dann die Spalten. spärlich wurde umbenannt sparse_output in scikit-learn 1.2 und entfernt in 1.4, daher liest neuerer Code OneHotEncoder(sparse_output=False).
Sie können mit `fit_transform` testen, ob die Pipeline funktioniert. Die Ausgabe sollte die Form 26048, 107 haben.
preprocess.fit_transform(X_train).shape
(26048, 107)
Der Datentransformator ist bereit. Sie erstellen die Pipeline mit make_pipeline, und sobald die Daten transformiert sind, speisen Sie sie in die logistische Regression ein.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Das Trainieren eines Modells mit scikit-learn ist dann trivial: Rufen Sie die `fit`-Methode in der Pipeline auf. Die Genauigkeit können Sie mit der `score`-Methode ausgeben.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Abschließend können Sie die Klassen mit predict_proba vorhersagen, das die Wahrscheinlichkeit jeder Klasse zurückgibt. Beachten Sie, dass die beiden Wahrscheinlichkeiten sich zu eins addieren.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Schritt 4) Verwendung unserer Pipeline in einer Rastersuche
Die Feinabstimmung der Hyperparameter, also der Werte, die die Struktur des Modells festlegen, kann mühsam und anstrengend sein.
Eine Möglichkeit zur Bewertung des Modells bestünde darin, die Größe des Trainingsdatensatzes zu verändern und die Leistung zu messen. Diesen Vorgang könnte man zehnmal wiederholen, um die Streuung der Ergebnisse zu ermitteln. Das ist allerdings mit einem hohen manuellen Aufwand verbunden.
Stattdessen stellt scikit-learn Funktionen bereit, die die Parameteroptimierung und Kreuzvalidierung für Sie durchführen.
Quervalidierung
Kreuzvalidierung bedeutet, dass der Trainingsdatensatz während des Trainings n-mal in Teile aufgeteilt und das Modell n-mal evaluiert wird. Bei einem Wert von 10 für cv wird das Modell zehnmal trainiert und evaluiert. In jeder Runde wird der Klassifikator mit neun zufällig ausgewählten Teilen trainiert, der zehnte Teil dient der Evaluierung.
Rastersuche
Jeder Klassifikator hat Hyperparameter, die optimiert werden können. Sie können die Werte einzeln ausprobieren oder ein Parameterraster festlegen. Die scikit-learn-Dokumentation listet alle Parameter auf, die der logistische Klassifikator akzeptiert. Um das Training zu beschleunigen, optimiert dieses Beispiel nur den Parameter C, der die Regularisierung steuert. Er muss positiv sein, und ein kleiner Wert gewichtet die Regularisierung stärker.
Sie verwenden das GridSearchCV-Objekt, das ein Wörterbuch mit den zu optimierenden Hyperparametern entgegennimmt. Listen Sie jeden Hyperparameter gefolgt von den Werten auf, die Sie ausprobieren möchten. Um C zu optimieren, schreiben Sie:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — dem Parameternamen geht der Name des Klassifikators in Kleinbuchstaben und zwei Unterstrichen voraus.
Das Modell wird vier verschiedene Werte ausprobieren: 0.001, 0.01, 0.1 und 1. Es wird mit 10 Faltungen trainiert, das heißt cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Sie können das Modell nun mit GridSearchCV und den Parametern grid und cv trainieren.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Ausgang:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Versionshinweis: die iid Das in dieser Ausgabe sichtbare Argument wurde in scikit-learn 0.22 als veraltet markiert und in 0.24 entfernt. Es sollte daher in den aktuellen Versionen einfach aus dem GridSearchCV-Aufruf entfernt werden.
Um auf die besten Parameter zuzugreifen, verwenden Sie best_params_.
grid_clf.best_params_
Ausgang:
{'logisticregression__C': 1.0}
Nach dem Training des Modells mit vier verschiedenen Regularisierungswerten ergibt sich der optimale Parameter wie folgt:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
Beste logistische Regression aus der Rastersuche: 0.850891
So greifen Sie auf die vorhergesagten Wahrscheinlichkeiten zu:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
XGBoost-Modell mit scikit-learn
Probieren Sie nun einen der leistungsstärksten Klassifikatoren auf dem Markt aus. XGBoost ist eine Gradient-Boosting-basierte Verbesserung des Random Forest. Die theoretischen Grundlagen werden hier nicht behandelt. Python Es gibt zwar ein Scikit-Tutorial, aber denken Sie daran, dass XGBoost zahlreiche Kaggle-Wettbewerbe gewonnen hat. Bei einem durchschnittlich großen Datensatz kann es genauso gut oder sogar besser als ein Deep-Learning-Algorithmus abschneiden.
Das Training des Klassifikators ist anspruchsvoll, da er eine große Anzahl von Parametern aufweist. Sie können GridSearchCV natürlich verwenden, um diese für Sie auszuwählen.
Eine bessere Option ist hier RandomizedSearchCV. GridSearchCV wird bei großen Gittern langsam, da der Suchraum mit jedem zusätzlichen Parameter wächst. RandomizedSearchCV hingegen wählt die Werte jedes Hyperparameters in jeder Iteration zufällig aus, sodass in 1,000 Iterationen 1,000 Kombinationen ausgewertet werden. Ansonsten funktioniert es ähnlich wie GridSearchCV.
Sie müssen xgboost importieren. Falls die Bibliothek nicht installiert ist, führen Sie `pip3 install xgboost` aus oder installieren Sie sie innerhalb einer Anwendung. Jupyter Notizbuch mit:
use import sys
!{sys.executable} -m pip install xgboost
Importieren Sie anschließend den Klassifikator und die beiden Suchhilfsfunktionen:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Der nächste Schritt in diesem Scikit Python Im Tutorial geht es darum, die anzupassenden Parameter festzulegen. Die offizielle XGBoost-Dokumentation listet sie alle auf. Python Im Sklearn-Tutorial wählt man nur zwei Hyperparameter mit jeweils zwei Werten, da das Training von XGBoost sehr lange dauert und jeder zusätzliche Gitterpunkt die Wartezeit verlängert.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Anschließend erstellen Sie eine neue Pipeline mit dem XGBoost-Klassifikator und 600 Schätzern. Der Parameter `n_estimators` ist anpassbar, ein hoher Wert kann jedoch zu Überanpassung führen. Sie können andere Werte ausprobieren, dies kann jedoch mehrere Stunden dauern. Alle anderen Parameter behalten ihre Standardwerte.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Die Kreuzvalidierung lässt sich mit dem stratifizierten K-Folds-Kreuzvalidator verbessern. Hier werden nur drei Folds verwendet, um die Berechnung zu beschleunigen, was jedoch die Qualität beeinträchtigt. Erhöhen Sie die Anzahl auf Ihrem Rechner auf 5 oder 10, um bessere Ergebnisse zu erzielen. Das Modell wird in vier Iterationen trainiert.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Die randomisierte Suche ist abgeschlossen, Sie können also das Modell trainieren.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Wie Sie sehen können, schneidet XGBoost besser ab als die frühere logistische Regression.
print("besten parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
besten parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Erstellen Sie DNN mit MLPClassifier in scikit-learn
Schließlich können Sie ein neuronales Netzwerk mit scikit-learn selbst trainieren. Die Methode ist dieselbe wie bei jedem anderen Klassifikator, und der Schätzer ist MLPClassifier.
from sklearn.neural_network import MLPClassifier
Das untenstehende Netzwerk ist wie folgt definiert:
- Adam-Löser
- ReLU-Aktivierungsfunktion
- Alpha = 0.0001
- Losgröße von 150
- Zwei verborgene Schichten mit jeweils 200 und 100 Neuronen
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Sie können die Anzahl der Schichten ändern, um das Modell zu verbessern.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
DNN-Regressionswert: 0.821253
LIME: Vertrauen Sie Ihrem Modell
Jetzt, da Sie ein gutes Modell haben, benötigen Sie eine Möglichkeit, ihm zu vertrauen. Algorithmen des maschinellen Lernens, insbesondere Random Forests und neuronale Netze, sind als Black-Box-Modelle bekannt: Sie funktionieren, aber niemand kann nachvollziehen, warum.
Drei Forscher haben ein Tool entwickelt, das veranschaulicht, wie der Computer zu einer Vorhersage gelangt. Ihre Veröffentlichung dazu lautet: „Warum sollte ich dir vertrauen?“Der von ihnen veröffentlichte Algorithmus heißt Local Interpretable Model-Agnostic Explanations (LIME).
Nehmen wir ein Beispiel. Manchmal weiß man nicht, ob man einer Vorhersage von maschinellem Lernen vertrauen kann. Ein Arzt kann eine Diagnose nicht einfach akzeptieren, nur weil sie von einem Computer erstellt wurde, und man muss wissen, ob ein Modell zuverlässig ist, bevor man es in der Praxis einsetzt.
Stellen Sie sich vor, Sie könnten nachvollziehen, warum ein Klassifikator eine Vorhersage getroffen hat – selbst bei so komplexen Modellen wie neuronalen Netzen, Random Forests oder SVMs mit beliebigem Kernel. Es wird deutlich einfacher, einer Vorhersage zu vertrauen, wenn die Gründe dafür sichtbar sind, und ebenso leichter zu entscheiden, wann man einem Modell nicht vertrauen sollte. LIME zeigt Ihnen, welche Merkmale die Entscheidung des Klassifikators beeinflusst haben.
Datenaufbereitung
Es gibt ein paar Dinge, die Sie ändern müssen, um LIME auszuführen. PythonZuerst wird Kalk mit dem Rohr „Kalk installieren“ in das Terminal eingebracht.
Lime verwendet ein LimeTabularExplainer-Objekt, um das Modell lokal zu approximieren. Dieses Objekt benötigt:
- ein Datensatz in NumPy Format
- Der Name der Features: feature_names
- Der Name der Klassen: class_names
- Der Index der Spalte der kategorialen Features: categorical_features
- Der Name der Gruppe für jedes kategoriale Merkmal: categorical_names
Erstelle das NumPy-Trainingsset
Sie können df_train von pandas sehr einfach nach NumPy kopieren und konvertieren.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Rufen Sie den Klassennamen ab
Das Label ist über unique() zugänglich. Sie sollten Folgendes sehen:
- '<= 50K'
- '> 50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indizieren Sie die Spalten für kategoriale Merkmale.
Verwenden Sie die zuvor erlernte Methode, um den Namen jeder Gruppe zu erhalten. Sie kodieren die Bezeichnung mit LabelEncoder und wiederholen den Vorgang für jedes kategoriale Merkmal.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Nachdem der Datensatz nun bereit ist, können Sie die verschiedenen Datensätze erstellen, die in den folgenden Scikit-learn-Beispielen gezeigt werden. Die Datentransformation erfolgt hier außerhalb der Pipeline, um Fehler mit LIME zu vermeiden: Der an LimeTabularExplainer übergebene Trainingsdatensatz muss ein NumPy-Array ohne Strings sein, und die obige Methode hat bereits ein solches Array erzeugt.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Sie können die Pipeline mit den von XGBoost ermittelten optimalen Parametern erstellen.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Sie erhalten eine Warnung. Diese erklärt, dass Sie vor der Pipeline keinen Label-Encoder erstellen müssen. Wenn Sie LIME nicht verwenden, ist die Methode aus dem ersten Teil dieses Tutorials „Machine Learning mit Scikit-learn“ ausreichend. Andernfalls sollten Sie wie folgt vorgehen: Erstellen Sie zuerst einen kodierten Datensatz und wenden Sie dann den One-Hot-Encoder innerhalb der Pipeline an.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Bevor Sie LIME verwenden, erstellen Sie ein NumPy-Array, das die Merkmale der falsch klassifizierten Zeilen enthält. Mithilfe dieser Liste können Sie später herausfinden, was den Klassifikator in die Irre geführt hat.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Anschließend erstellen Sie eine Lambda-Funktion, die die Vorhersage des Modells für neue Daten abruft. Sie werden diese Funktion in Kürze benötigen.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Sie konvertieren den Pandas-Dataframe in ein NumPy-Array.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Wählen Sie nun einen zufälligen Haushalt aus dem Testdatensatz aus und sehen Sie sich sowohl die Vorhersage als auch an, wie der Computer zu dieser gelangt ist.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Sie können den Explainer mit `explain_instance` verwenden, um die Logik hinter dem Modell zu untersuchen. Das resultierende Diagramm wird unten angezeigt.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Der Klassifikator hat diesen Haushalt korrekt vorhergesagt: Das Einkommen liegt tatsächlich über 50.
Zunächst ist festzuhalten, dass der Klassifikator nicht sehr sicher ist. Er prognostiziert ein Einkommen über 50 € mit einer Wahrscheinlichkeit von 64 %, wobei diese 64 % durch Kapitalgewinne und den Familienstand bedingt sind. Die blaue Linie trägt negativ zur positiven Kategorie bei, die orange Linie hingegen positiv.
Der Klassifikator zögert, da der Kapitalgewinn dieses Haushalts null beträgt, obwohl der Kapitalgewinn üblicherweise ein guter Indikator für Vermögen ist. Der Haushalt arbeitet zudem weniger als 40 Stunden pro Woche. Alter, Beruf und Geschlecht wirken sich positiv aus.
Wäre der Familienstand ledig, hätte der Klassifikator ein Einkommen unter 50 vorhergesagt (0.64 – 0.18 = 0.46).
Versuchen Sie es nun mit einem anderen Haushalt, der fälschlicherweise klassifiziert wurde. Die zugehörige Erklärungstabelle folgt dem Code.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Der Klassifikator prognostizierte ein Einkommen unter 50, was falsch ist. Dieser Haushalt ist ungewöhnlich: Er weist weder Kapitalgewinne noch Kapitalverluste auf, die Person ist geschieden, fast 60 Jahre alt und gebildet (Bildungsnummer > 12). Entsprechend dem allgemeinen Muster ordnete der Klassifikator den Haushalt einem Einkommen unter 50 zu.
Probieren Sie LIME selbst aus und Sie werden zahlreiche grobe Fehler des Klassifikators feststellen. Das GitHub-Repository des Bibliotheksautors enthält zusätzliche Dokumentation zur Bild- und Textklassifizierung.
Scikit-learn Befehlsreferenz
Nachfolgend finden Sie eine Liste nützlicher Befehle, die für scikit-learn Version 0.20 und höher gelten.
| Aufgabe | Funktion oder Klasse |
|---|---|
| Erstellen Sie den Trainings-/Testdatensatz | train_test_split |
| Bauen Sie eine Pipeline | |
| Wählen Sie die Spalten aus und wenden Sie die Transformation an. | make_column_transformer |
| Art der Transformation | |
| Standardisieren | Standardskala |
| Min-Max-Skalierung | MinMaxSkalierer |
| Normalisieren | Normalizer |
| Fehlende Werte ersetzen | SimpleImputer |
| Kategorisch umwandeln | OneHotEncoder |
| Passen Sie die Daten an und transformieren Sie sie | fit_transform |
| Machen Sie die Pipeline | make_pipeline |
| Grundmodell | |
| Logistische Regression | Logistische Regression |
| XGBoost | XGBClassifier |
| Neuronales Netz | MLPClassifier |
| Rastersuche | GridSearchCV |
| Zufällige Suche | RandomizedSearchCV |
