
MongoDB Regulärer Ausdruck ($regex) mit Beispielen
 Stephen Twain
⚡ Intelligente Zusammenfassung
MongoDB Reguläre Ausdrücke führen Mustervergleiche durch, um Zeichenketten innerhalb von Dokumenten zu finden. Dabei werden der Operator $regex, das Flag $options für die Nichtbeachtung der Groß-/Kleinschreibung, Anker für exakte Übereinstimmungen und Schrägstriche als Trennzeichen verwendet, wenn der genaue Feldwert unbekannt ist.
Reguläre Ausdrücke werden für die Mustererkennung verwendet, die im Grunde dazu dient, Zeichenketten innerhalb von Dokumenten zu finden.
Manchmal wissen Sie beim Abrufen von Dokumenten in einer Sammlung möglicherweise nicht genau, nach welchem genauen Feldwert gesucht werden soll. Daher können reguläre Ausdrücke verwendet werden, um das Abrufen von Daten basierend auf Suchwerten für Musterübereinstimmungen zu unterstützen.
Verwenden des $regex-Operators für die Musterübereinstimmung
Der $regex-Operator in MongoDB wird verwendet, um nach bestimmten Zeichenfolgen in der Sammlung zu suchen. Das folgende Beispiel zeigt, wie dies durchgeführt werden kann.
Nehmen wir an, wir verfügen über dieselbe Mitarbeiter-Collection mit den Feldnamen „Employeeid“ und „EmployeeName“. Nehmen wir außerdem an, dass unsere Collection die folgenden Dokumente enthält.
| Angestellten ID | Mitarbeitername |
|---|---|
| 22 | NeuMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
Im folgenden Code haben wir den $regex-Operator verwendet, um die Suchkriterien anzugeben.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Erläuterung:
- Hier möchten wir alle Mitarbeiternamen finden, die die Buchstaben „Gu“ enthalten. Daher verwenden wir den Operator $regex, um das Suchkriterium „Gu“ zu definieren.
- Der printjson wird verwendet, um jedes Dokument, das von der Abfrage zurückgegeben wird, besser zu drucken.
Wenn der Befehl erfolgreich ausgeführt wurde, wird die folgende Ausgabe angezeigt:
Ausgang:

Die Ausgabe zeigt deutlich, dass die Dokumente zurückgegeben werden, in denen der Mitarbeitername die „Gu“-Zeichen enthält.
Angenommen, Ihre Sammlung enthält die folgenden Dokumente sowie ein zusätzliches Dokument, das den Mitarbeiternamen als „Guru999“. Wenn Sie als Suchkriterien „Guru99”, würde es auch das Dokument zurückgeben, das „Guru999". Aber angenommen, wir wollten das nicht und wollten das Dokument nur mit „Guru99”. Dann können wir dies mit exakter Mustererkennung durchführen. Für eine exakte Mustererkennung verwenden wir die Zeichen ^ und $. Wir fügen das Zeichen ^ am Anfang und das Zeichen $ am Ende der Zeichenkette ein.
| Angestellten ID | Mitarbeitername |
|---|---|
| 22 | NeuMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Das folgende Beispiel zeigt, wie dies gemacht werden kann.
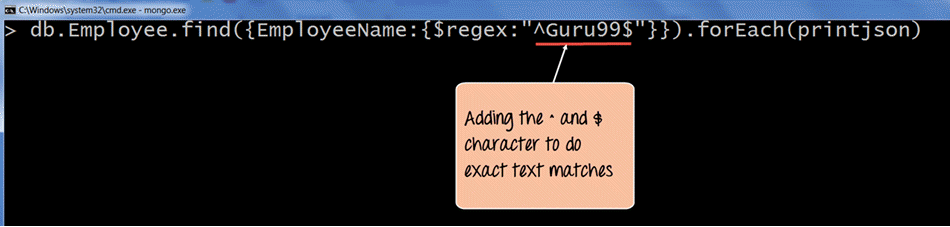
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Erläuterung:
- Hier in den Suchkriterien verwenden wir die Zeichen ^ und $. Das ^ stellt sicher, dass die Zeichenkette mit einem bestimmten Zeichen beginnt, und das $ stellt sicher, dass sie mit einem bestimmten Zeichen endet. Wenn der Code ausgeführt wird, wird also nur die Zeichenkette mit dem Namen „“ abgerufen.Guru99 ".
- Der printjson wird verwendet, um jedes Dokument, das von der Abfrage zurückgegeben wird, besser zu drucken.
Wenn der Befehl erfolgreich ausgeführt wurde, wird die folgende Ausgabe angezeigt:
Ausgang:
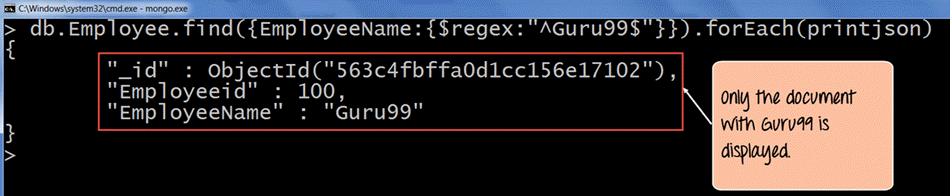
In der Ausgabe ist deutlich zu erkennen, dass die Zeichenkette „Guru99” wird abgerufen.
Mustervergleich mit $options
Bei Verwendung des $regex-Operators können auch zusätzliche Optionen angegeben werden, indem man den $ options Stichwort. Angenommen, Sie möchten alle Dokumente finden, deren Mitarbeitername „Gu“ enthält, unabhängig davon, ob die Groß-/Kleinschreibung beachtet wird oder nicht. Wenn ein solches Ergebnis gewünscht ist, müssen wir das verwenden $ options mit dem Parameter der Groß-/Kleinschreibungsunempfindlichkeit.
Das folgende Beispiel zeigt, wie dies gemacht werden kann.
Nehmen wir an, wir haben unsere Mitarbeiter-Collection mit den Feldnamen „Employeeid“ und „EmployeeName“.
Nehmen wir außerdem an, dass sich die folgenden Dokumente in unserer Sammlung befinden.
| Angestellten ID | Mitarbeitername |
|---|---|
| 22 | NeuMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Wenn wir nun dieselbe Abfrage wie im letzten Thema ausführen, wird das Dokument mit „GURU99“ niemals im Ergebnis angezeigt. Um sicherzustellen, dass es im Ergebnis erscheint, müssen wir den Parameter „i“ in der $options-Anweisung hinzufügen.
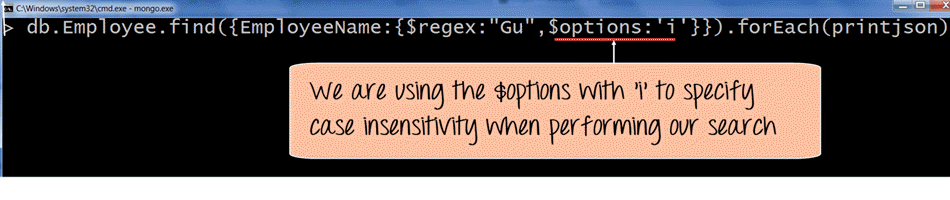
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Erläuterung:
- Die $options mit dem Parameter 'i' (was Groß-/Kleinschreibung-Unempfindlichkeit bedeutet) geben an, dass die Suche unabhängig davon durchgeführt werden soll, ob die Buchstaben 'Gu' in Klein- oder Großschreibung gefunden werden.
Wenn der Befehl erfolgreich ausgeführt wurde, wird die folgende Ausgabe angezeigt:
Ausgang:
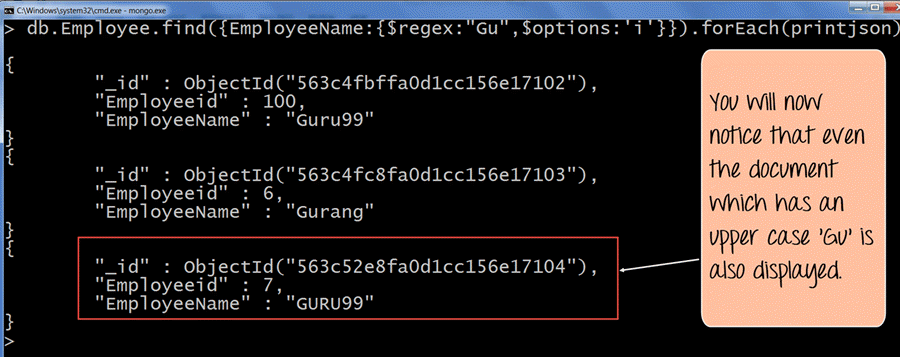
- Die Ausgabe zeigt deutlich, dass ein Dokument, obwohl es den Großbuchstaben „Gu“ enthält, trotzdem in der Ergebnisliste angezeigt wird.
Mustervergleich ohne den Regex-Operator
Mustervergleiche sind auch ohne den $regex-Operator möglich. Das folgende Beispiel zeigt, wie das geht.
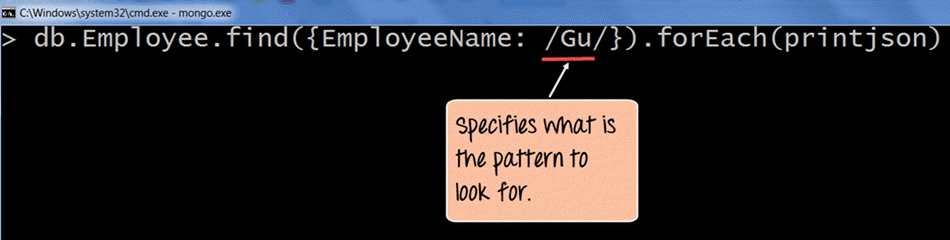
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Erläuterung:
- Die Trennzeichen „//“ dienen dazu, die Suchkriterien innerhalb dieser Trennzeichen anzugeben. Daher geben wir /Gu/ an, um erneut diejenigen Dokumente zu finden, deren Mitarbeitername „Gu“ enthält.
Wenn der Befehl erfolgreich ausgeführt wurde, wird die folgende Ausgabe angezeigt:
Ausgang:
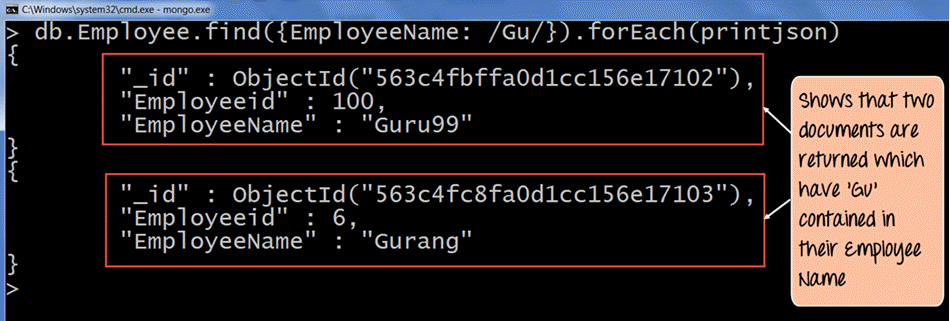
Die Ausgabe zeigt deutlich, dass die Dokumente zurückgegeben werden, in denen der Mitarbeitername die „Gu“-Zeichen enthält.
Die letzten n Dokumente aus einer Sammlung abrufen
Es gibt verschiedene Möglichkeiten, die letzten n Dokumente in einer Sammlung abzurufen.
Betrachten wir eine der Möglichkeiten anhand der folgenden Schritte.
Das folgende Beispiel zeigt, wie dies gemacht werden kann.
Nehmen wir an, wir haben unsere Mitarbeiter-Collection mit den Feldnamen „Employeeid“ und „EmployeeName“.
Nehmen wir außerdem an, dass sich die folgenden Dokumente in unserer Sammlung befinden:
| Angestellten ID | Mitarbeitername |
|---|---|
| 22 | NeuMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
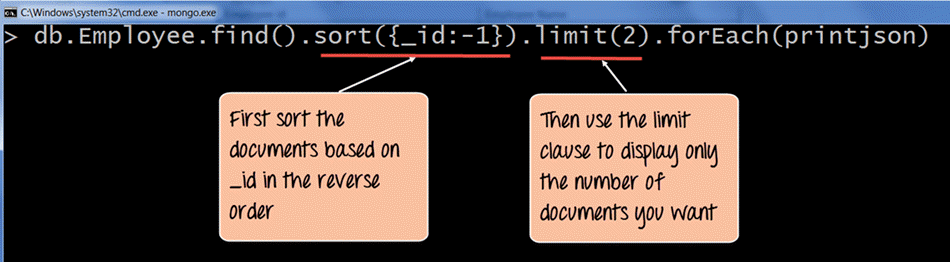
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Erläuterung:
- Um Dokumente abzufragen, verwenden Sie die Sortierfunktion, um die Datensätze anhand des Werts im Feld „_id“ der Sammlung in umgekehrter Reihenfolge zu sortieren. Der Wert -1 bedeutet, dass die Dokumente in absteigender Reihenfolge sortiert werden, sodass das letzte Dokument als erstes angezeigt wird.
- Verwenden Sie anschließend die LIMIT-Klausel, um nur die gewünschte Anzahl an Datensätzen anzuzeigen. Hier haben wir die LIMIT-Klausel auf (2) gesetzt, sodass die letzten beiden Dokumente abgerufen werden.
Wenn der Befehl erfolgreich ausgeführt wurde, wird die folgende Ausgabe angezeigt:
Ausgang:
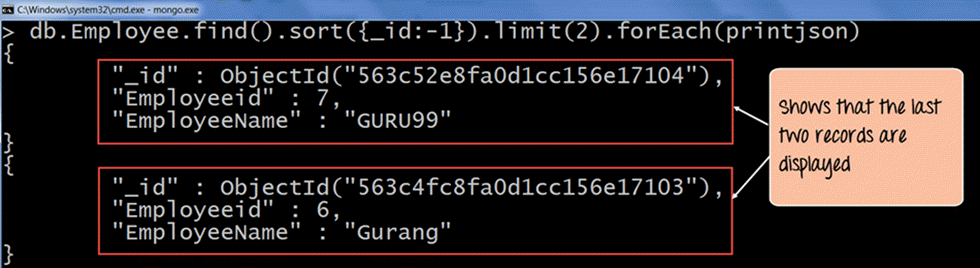
Die Ausgabe zeigt deutlich, dass die letzten beiden Dokumente in der Sammlung angezeigt werden. Damit haben wir deutlich gezeigt, dass wir zum Abrufen der letzten „n“ Dokumente in der Sammlung die Dokumente zunächst in absteigender Reihenfolge sortieren und dann die Limit-Klausel verwenden können, um die erforderliche Anzahl „n“ Dokumente zurückzugeben.
Hinweis: Wenn die Suche nach einer Zeichenfolge durchgeführt wird, die beispielsweise mehr als 38,000 Zeichen umfasst, werden nicht die richtigen Ergebnisse angezeigt.
